Las herramientas de seguridad asistidas por IA están encontrando más errores, pero el nivel de amenaza no ha cambiado

Los sistemas de inteligencia artificial como el Proyecto Glasswing de Anthropic y el MDASH de Microsoft están ayudando a descubrir vulnerabilidades, llenando el grupo cada vez mayor de defectos que los defensores deben abordar antes de que ocurra la explotación. Sin embargo, durante la primera mitad de 2026, estas vulnerabilidades no tenían ni más ni menos probabilidades de ser explotadas que todas las vulnerabilidades reveladas durante ese período, dijo VulnCheck en un informe Martes.

Siguen existiendo grandes preocupaciones acerca de que las vulnerabilidades descubiertas en la IA impulsen más ataques, pero la revisión de los datos de explotación realizada por VulnCheck muestra que esos temores son infundados, al menos hasta ahora.

Patrick Garrity, investigador de seguridad de VulnCheck y autor del informe, identificó 1.061 vulnerabilidades atribuidas al descubrimiento asistido por IA durante los primeros seis meses del año. De las vulnerabilidades descubiertas por la IA, 14 (1,3%) fueron explotadas en estado salvaje, un desglose que se alinea con la tasa de explotación que los investigadores observaron en todas las vulnerabilidades durante el mismo período.

“Si bien el descubrimiento de vulnerabilidades asistido por IA claramente tiene valor tanto para los atacantes como para los defensores, los datos no sugieren que las vulnerabilidades descubiertas por la IA tengan inherentemente más probabilidades de ser explotadas que las encontradas mediante métodos tradicionales”, escribió Garrity.

Si bien la contribución de la IA a las vulnerabilidades explotadas activamente fue reducida en la primera mitad del año, es demasiado pronto para asumir que esa tendencia continuará. Además, ninguno de estos principales modelos de búsqueda de vulnerabilidades estuvo funcionando durante todo ese período. El Proyecto Glasswing se lanzó en abril, mientras que MDASH de Microsoft y Daybreak de OpenAI se dieron a conocer en mayo.

La tendencia al alza en el Patch Tuesday mensual de Microsoft indica hasta qué punto se podrían abrir las compuertas durante el resto del año a medida que los modelos de IA descubran más vulnerabilidades. La actualización de seguridad de julio de la compañía contenía un récord histórico de 622 vulnerabilidades, superando la anterior actualización récord de junio con 206 vulnerabilidades.

El informe del estado de explotación de VulnCheck también encontró que las vulnerabilidades se explotaron mucho más rápido después de la publicación de CVE, pasando de un promedio de 120 días en 2025 a 80 días durante la primera mitad del año.

La empresa de inteligencia también determinó qué categorías tecnológicas eran explotadas activamente con mayor frecuencia. Los sistemas de gestión de contenido representaron casi un tercio de las 495 vulnerabilidades explotadas conocidas que VulnCheck identificó durante la primera mitad de 2026. Los dispositivos de borde de red fueron responsables de casi el 14 %, seguidos por los sistemas operativos con casi el 9 %, el software de servidor con el 8 % y los productos de inteligencia artificial (una superficie de ataque emergente) con casi el 6 %.

Matt Kapko

Escrito por Matt Kapko

Matt Kapko es reportero de CyberScoop. Su área incluye delitos cibernéticos, ransomware, defectos de software y (mala) gestión de vulnerabilidades. El californiano de toda la vida comenzó su carrera periodística en 2001 con paradas anteriores en Cybersecurity Dive, CIO, SDxCentral y RCR Wireless News. Matt tiene una licenciatura en periodismo e historia de la Universidad Estatal de Humboldt.

GitHub reduce los pagos públicos de recompensas por errores y traslada las recompensas principales al nivel VIP – CYBERDEFENSA.MX

A partir del 27 de julio de 2026, GitHub reducirá los pagos públicos de recompensas por errores al menos a la mitad en cada nivel de gravedad. Los hallazgos críticos bajarán de $20,000-$30,000+ a $10,000 fijos, mientras que su nivel VIP permanente solo por invitación pagará $30,000 o más.

Los informes presentados antes de esa fecha, incluidos aquellos que ya se encuentran en la creciente cola de clasificación de GitHub, conservarán los términos de pago anteriores.

GitHub dijo Los cambios tienen como objetivo reducir el ruido y al mismo tiempo brindar a los investigadores establecidos respuestas más rápidas, mayores recompensas y un acceso más cercano a su equipo de ingeniería de seguridad.

«No se gana más enviando más», dijo la empresa. «Ganas más enviando mejor.»

El programa público pasa de rangos flexibles a pagos fijos:

  • Mínimo: $250, en comparación con $617-$2000
  • Mediano: $2000, en comparación con $4000-$10 000
  • Alto: $5,000, en comparación con $10,000-$20,000
  • Crítico: $10,000, en comparación con $20,000-$30,000+

The Hacker News calculó que las nuevas tarifas públicas son un 50% más bajas para hallazgos medios, altos y críticos y alrededor de un 59% más bajas para informes de baja gravedad cuando se comparan con la parte inferior de GitHub. rangos anteriores.

Ciberseguridad

GitHub dijo que los pagos fijos deberían eliminar la incertidumbre y los gastos generales de clasificación, aunque aún puede otorgar bonificaciones discrecionales por trabajos excepcionales.

El programa VIP establece pagos en 1.000 dólares para hallazgos de baja gravedad, 7.500 dólares para vulnerabilidades medias, 20.000 dólares para vulnerabilidades altas y 30.000 dólares o más para vulnerabilidades críticas.

Los investigadores pueden calificar para el programa privado informando al menos una vulnerabilidad crítica, dos alta, cuatro media o siete vulnerabilidades de gravedad baja. El anuncio no especifica un período de tiempo para alcanzar esos umbrales ni dice si la calificación garantiza una invitación. GitHub dijo que aparecerán criterios más completos en su página pública del programa HackerOne.

GitHub no ha revelado el umbral de HackerOne Signal que aplicará. La compañía dice que los investigadores que se encuentran debajo recibirán hasta cuatro presentaciones iniciales.

Por separado, Reglas generales de HackerOne Brinde a los nuevos investigadores cuatro informes de prueba por programa dentro de un período continuo de 30 días.

Cuando tu propia IA encuentra el error primero

Los controles de informes de GitHub llegan a medida que la IA hace que generar los hallazgos de los candidatos sea más barato y que la revisión del código sea más barata de repetir. Más investigadores pueden producir hallazgos potenciales, mientras que los equipos internos pueden escanear códigos, validar problemas e introducir correcciones en los procesos de lanzamiento y confirmación antes de que llegue un informe externo.

Un día antes del anuncio de GitHub, Google presentó Gemini 3.5 Flash Cyber, un modelo liviano optimizado para encontrar, validar y parchear vulnerabilidades de software. Google dijo que el modelo inicialmente estará disponible exclusivamente para gobiernos y socios confiables a través de CodeMender, su agente de seguridad de códigos, como parte de un piloto limitado.

Google dijo que el modelo se puede invocar repetidamente para examinar más rutas de código sin utilizar un modelo de frontera más grande para cada intento. La compañía lo posiciona para escaneos frecuentes de repositorios, revisiones de lanzamiento urgentes y procesos de escaneo de confirmaciones.

En las pruebas realizadas por Google, Gemini 3.5 Flash Cyber ​​encontró 55 problemas únicos confirmados con V8, en comparación con 47 para el Gemini 3.5 Flash principal y 36 para Claude Opus 4.6.

Google dijo por separado que su equipo de Investigación de Vulnerabilidad en la Nube utilizó el modelo para encontrar fallas de ejecución remota de código en API públicas y una falla de corrupción de memoria en un servicio de producción sensible en dos horas. Luego, el modelo generó lo que Google describió como un exploit RCE 100% confiable que pasó por alto ASLR y W^X. Las cifras de referencia y el resultado del exploit de producción son informes de Google y no han sido verificados de forma independiente.

Un equipo de seguridad interno puede brindar un contexto de repositorio de agentes, un modelo de amenaza específico para el proyecto y un entorno de validación adaptado al sistema en ejecución. Los sistemas como Codex Security de OpenAI pueden luego probar los hallazgos, generar pruebas de concepto funcionales y proponer soluciones que tengan en cuenta la intención del sistema y el comportamiento circundante.

El trabajo puede realizarse durante el desarrollo y en cada compromiso relevante, en lugar de esperar una evaluación programada o un informe externo. La IA no reemplaza una prueba de penetración, pero la revisión del código fuente, la generación de pruebas y la validación de primer paso son cada vez más fáciles de automatizar.

Los evaluadores humanos conservan más valor cuando el trabajo requiere encadenar debilidades a través de límites de confianza, reconocer fallas en la lógica empresarial, modelar rutas de ataque realistas y demostrar el impacto material.

Mantenedor de rizos Daniel Stenberg puso fin a la recompensa en efectivo por errores del proyecto a finales de enero de 2026 después de que su tasa de vulnerabilidad confirmada cayera por debajo del 5% en medio de un aumento de los informes basura generados por IA.

En abril, después de que curl terminara las recompensas en efectivo y regresó a HackerOnelos informes llegaban a aproximadamente el doble de la tasa de 2025 y se confirmó que entre el 15% y el 16% eran vulnerabilidades. stenberg dijo Casi todos los informes aparecían asistidos por IA y la mayoría ahora eran de alta calidad.

En conjunto, los controles de informes de GitHub, las repetidas llamadas a modelos de Google y el creciente volumen de envíos de curl apuntan al mismo cambio. La IA puede inundar a los mantenedores con basura, pero también puede hacer que los investigadores capaces sean más rápidos y permitir que los equipos internos examinen más código, con más frecuencia.

Ciberseguridad

Cada vez abunda más un hallazgo que parece plausible. La clasificación, la prueba de explotación, el contexto del producto, la divulgación y la remediación siguen estando limitados. Siguen siendo escasos un exploit confiable, una cadena de ataque específica de un producto o un hallazgo que cruce un límite que el proveedor no entendió correctamente.

Los requisitos de señal y las menores recompensas públicas pueden suprimir el ruido automatizado, pero también pueden dificultar la entrada de investigadores capaces sin un historial establecido en HackerOne. Para un nuevo investigador de HackerOne, un límite de programa de cuatro informes deja poco espacio para errores, falta de familiaridad con el modelo de seguridad de GitHub o un hallazgo legítimo que inicialmente recibe una puntuación inferior a las expectativas.

La estructura de solo invitación también concentra las relaciones más cercanas de investigadores de GitHub entre las personas que ya han tenido éxito dentro del programa. Eso puede mejorar la velocidad y la calidad de los informes. También puede reducir el número de personas que examinan la plataforma, una de las principales ventajas de un programa de recompensas públicas.

La reestructuración sigue un Cambio de política de mayo de 2026 eso exigía pruebas de concepto funcionales, impacto demostrado, validación antes del envío y mayor atención al alcance de GitHub y a los hallazgos no elegibles.

GitHub dijo que da la bienvenida a la investigación de seguridad asistida por IA y que ya utiliza IA en sus programas de seguridad internos. Los investigadores siguen siendo responsables de reproducir y verificar todo lo que produzcan sus herramientas.

«Las herramientas no importan», dijo GitHub. «La calidad del trabajo sí lo hace».

El 22 de julio, una revisión realizada por The Hacker News encontró que GitHub página de recompensas todavía cotiza entre $ 20 000 y $ 30 000 + para informes críticos, mientras que su Preguntas frecuentes retuvo la prueba de elegibilidad VIP anterior de al menos $20,000 ganados y dos informes presentados durante los dos años anteriores. Las preguntas frecuentes también decían que cumplir con esos criterios no garantizaba una invitación y que GitHub revisaba a los candidatos trimestralmente.


El proyecto de ley de Warner crearía una lista examinada a nivel federal para agentes de IA seguros y confiables

Un nuevo proyecto de ley del Senado establecería una lista de proveedores de software de agentes de IA que las personas pueden utilizar para establecer la propiedad humana y ejecutar agentes de forma segura en las redes sociales y otras plataformas en línea.

La Ley de Acceso a Inteligencia Artificial, Intercambio de Guardianes y Transferencia No Discriminatoria (AI AGENT), liderada por el senador Mark Warner, demócrata por Virginia, permitiría a los usuarios finales de grandes plataformas en línea con más de 50 millones de clientes o suscriptores por mes el derecho a elegir al menos un proveedor de agentes de IA que cumpla con los estándares de seguridad e identidad desarrollados por la Comisión Federal de Comercio.

Estos agentes toman cada vez más decisiones en nombre de los usuarios, como comprar, publicar contenido en las redes sociales o cambiar la configuración de la cuenta, a veces sin el consentimiento o conocimiento del usuario.

bajo el facturala FTC certificaría organismos independientes para examinar a los proveedores de agentes de IA. Estos organismos de certificación garantizarían que los productos cumplan con las protecciones básicas de privacidad, seguridad de los datos y actuar en interés del usuario. El proyecto de ley también requeriría que los proveedores vinculen cada agente de IA con la identidad de su operador humano e incluyan controles integrados que permitan a los usuarios otorgar o revocar claramente el permiso para que el agente actúe en su nombre.

Si bien la comisión no puede impedir que las plataformas utilicen proveedores de agentes de inteligencia artificial que no cumplan con esos estándares, puede cancelar el registro de los infractores de la lista de la FTC.

El proyecto de ley es un borrador de discusión y Warner dijo que lo publicaría ahora para recibir comentarios antes de presentar una versión formal para su consideración en el Senado.

«A medida que la IA agente transforma la forma en que los estadounidenses interactúan con la tecnología, los consumidores merecen una opción real en el mercado, y los agentes de IA deben ser responsables ante las personas a las que sirven», dijo Warner en un comunicado. «Este borrador de discusión es un paso importante hacia la construcción de un marco federal claro que promueva la innovación, proteja a los consumidores y garantice que Estados Unidos continúe liderando el mundo en tecnología emergente».

El año pasado, Morgan Stanley estimado que casi uno de cada cuatro (23%) estadounidenses realizó compras utilizando IA durante un período de 30 días, y que los compradores agentes podrían representar potencialmente cientos de miles de millones de dólares en comercio en línea para 2030.

Pero los agentes de IA todavía pueden ser poco confiable o errático. Pueden realizar compras absurdas que un usuario nunca aprobaría conscientemente, filtrar datos confidenciales o actuar en contra de los intereses del usuario.

A medida que más agentes inundan Internet, aumenta la probabilidad de que los robots de IA interactúen con otros robots de IA y les compren, lo que subraya la necesidad de soluciones de usuario seguras o reguladas que puedan verificar las identidades humanas responsables detrás de la actividad de la IA y proporcionar protecciones básicas de seguridad y privacidad.

La administración Trump está tratando de encontrar su propia base para regular los modelos fronterizos. A principios de este mes, el Departamento de Comercio impuso controles de exportación a los modelos Mythos 5 y Fable 5 de Anthropic, y las dos partes están intentando negociar un marco para proporcionar supervisión gubernamental de los lanzamientos más recientes.

Una orden ejecutiva de IA emitida por la administración Trump estableció un programa de prueba voluntario de 30 días para que las empresas de IA presentaran ciertos modelos fronterizos para prueba y evaluación, pero la administración impuso los controles de exportación días después de que Anthropic publicara Fable 5, supuestamente citando preocupaciones de que el modelo podría tener jailbreak.

Anthropic afirma que las pruebas internas exhaustivas no han identificado fugas universales para Fable 5 y que la investigación de terceros publicada hasta ahora no ha demostrado que se hayan eludido las barreras de seguridad que impiden el acceso a la ciberseguridad mejorada o las capacidades biológicas del modelo. Esas son las capacidades que citó Anthropic cuando retuvo el lanzamiento público de su modelo más nuevo, Mythos.

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

Los piratas informáticos maliciosos aprovechan el día cero de Cisco para obtener el nivel de acceso más alto en el proveedor de servicios de comunicaciones

Un atacante aprovechó una vulnerabilidad de Cisco previamente desconocida y sin parches a principios de este año para infiltrarse en un proveedor de servicios de comunicaciones y obtener el mayor nivel de acceso posible, dijo Mandiant el miércoles.

Desde entonces, Cisco ha reparado la falla, una de las siete vulnerabilidades de día cero explotadas activamente este año en su software SD-WAN (red de área amplia definida por software) utilizado para gestionar el tráfico de Internet dentro de las organizaciones, generalmente aquellas que están ampliamente distribuidas, como los bancos con numerosas sucursales.

Pero la firma de ciberseguridad Mandiant, propiedad de Google, dijo que el atacante (o los atacantes) podrían haber utilizado su acceso de nivel raíz para obtener una visibilidad amplia y no detectada del tráfico interno en toda la red corporativa del proveedor. Como advertencia, Mandiant también dijo que no podía evaluar completamente hasta dónde llegó realmente el compromiso debido a la astucia con la que los perpetradores ocultaron su actividad.

El ataque ilustró el ataque continuo de los piratas informáticos a los dispositivos de borde, dijo Mandiant. Los ataques a dichos dispositivos han sido muy comunes y han estado involucrados en algunas de las violaciones más importantes de los últimos años, lo que llevó a la Agencia de Infraestructura y Ciberseguridad a ordenar a las agencias federales que les presten especial atención este año.

«Esta campaña subraya el paradigma de vivir fuera del borde, donde los actores de amenazas priorizan el compromiso de los dispositivos de red para eludir los perímetros de seguridad tradicionales», escribió Mandiant en un publicación de blog. «A medida que las organizaciones adoptan cada vez más redes definidas por software, los orquestadores que gestionan estos entornos se convierten en objetivos principales. Estos dispositivos ofrecen un entorno de caja negra para los actores de amenazas: a menudo carecen de la telemetría necesaria para un análisis forense profundo, y su función como plano de control central proporciona una plataforma sigilosa para un acceso persistente y a gran escala al tráfico interno de la empresa».

Mandiant no atribuyó el ataque a ningún grupo específico, citando el trabajo que hizo el atacante para cubrir sus huellas y eliminar pruebas. Pero señaló que “para los actores patrocinados por el Estado, la capacidad de explotar las vulnerabilidades de día cero en estas plataformas sigue siendo un vector principal para la recopilación de inteligencia estratégica a largo plazo”.

Kelli Vanderlee, gerente senior de Google Threat Intelligence Group, dijo a CyberScoop que «la explotación de las vulnerabilidades de día cero en los dispositivos de borde y las extensas actividades antiforenses son consistentes con el comportamiento de los actores de amenazas de ciberespionaje previamente documentados».

La empresa tampoco nombró al proveedor de servicios de la víctima.

Los ataques al proveedor de servicios se produjeron en dos oleadas. La primera actividad que Mandiant observó desde finales de 2025 hasta principios de 2026 aprovechó una de las dos vulnerabilidades que en ese momento no estaban parcheadas (CVE-2026-20127 o CVE-2026-20182), en el que el atacante realiza conexiones «peering» no autorizadas a los dispositivos SD-WAN Manager de la víctima en una especie de apretón de manos digital para verificar la identidad y la confianza.

Una vez allí, el atacante facilitó su acceso y lo utilizó para manipular las contraseñas predeterminadas de las cuentas con la esperanza de evitar la detección. A continuación, el atacante aprovechó la vulnerabilidad de día cero (CVE-2026-20245) en Cisco Catalyst SD-WAN Manager, actividad que Mandiant observó en marzo y creó una cuenta de usuario fraudulenta, «troot», que otorgaba control total a nivel de raíz.

“El 4 de junio de 2026, Cisco publicó un aviso de seguridad sobre una vulnerabilidad de escalada de privilegios en Cisco Catalyst SD-WAN Manager», dijo un portavoz de Cisco. «Cisco recomienda encarecidamente a los clientes actualizar a una versión de software fija como se describe en el aviso».

Actualizado el 24/06/26: para incluir el comentario de Cisco.

Tim Starks

Escrito por Tim Starks

Tim Starks es reportero senior de CyberScoop. Sus paradas anteriores incluyen trabajar en The Washington Post, POLITICO y Congressional Quarterly. Originario de Evansville, Indiana, se ocupa de la ciberseguridad desde 2003. Envíe un correo electrónico a Tim aquí: tim.starks@cyberscoop.com.

Cómo reducir la sobrecarga de nivel 1 – CYBERDEFENSA.MX

El phishing siempre ha sido un juego de números. La IA lo ha convertido en una máquina de volumen.

Los atacantes ahora pueden crear correos electrónicos convincentes, páginas de inicio de sesión falsas y señuelos personalizados en minutos. Cada mensaje pulido agrega otro caso para que el Nivel 1 lo revise, otro enlace para inspeccionar y otra alerta que no se puede descartar de un vistazo.

A medida que la cola crece, un intento de robo de credenciales o de entrega de malware puede fácilmente quedar enterrado entre controles de rutina. Los líderes del SOC deben ayudar a sus equipos a eliminar el ruido más rápido y captar las alertas que podrían convertirse en un incidente grave.

Dónde los equipos de nivel 1 pierden tiempo con el phishing de IA

La IA ayuda a los atacantes a lanzar campañas más convincentes, variar el mensaje y rotar la infraestructura más rápidamente. Para los equipos de Nivel 1, eso significa que se pueden descartar rápidamente menos alertas.

Cambio impulsado por la IA Con qué tiene que lidiar el Nivel 1 Impacto en el COS
Más variaciones de señuelos Campañas similares ya no parecen idénticas. Más alertas necesitan revisión manual.
Mejor suplantación Los correos electrónicos suenan como solicitudes rutinarias de recursos humanos, finanzas o TI. Se dedica más tiempo a comprobar el contexto.
Mensajes personalizados Los señuelos se adaptan con detalles de la empresa pública o del empleado. Más correos electrónicos pasan una revisión visual rápida.
Dominios de corta duración Las URL suelen tener poco o ningún historial de reputación. Las herramientas devuelven «desconocido» en lugar de un veredicto claro.
Casos más inciertos El nivel 1 tiene menos evidencia para cerrar las alertas con confianza. Más casos pasan al Nivel 2.

Eso hace que el Nivel 1 dedique más tiempo a cada alerta y envíe más casos poco claros al Nivel 2 para otra ronda de revisión. A medida que crece el trabajo pendiente, las amenazas críticas pueden permanecer en la cola por más tiempo, lo que retrasa la respuesta y aumenta el riesgo de un incidente costoso.

La forma más rápida de gestionar el phishing mediante IA a escala sin sobrecargar el nivel 1

Agregar más comprobaciones manuales no resolverá el problema. Cuando el volumen de phishing aumenta, el Nivel 1 necesita una manera de investigar más alertas sin perder tiempo extra en pasos repetitivos o enviar cada caso poco claro a los equipos superiores.

Un flujo de trabajo más rápido combina controles automatizados, visibilidad basada en el comportamiento e informes listos para usar. Esto le da al Nivel 1 la evidencia necesaria para llegar antes a un veredicto claro y ayuda al Nivel 2 a intervenir sólo cuando un caso realmente requiere una investigación más profunda.

1. Ofrezca visibilidad total del comportamiento de nivel 1 en menos de 60 segundos

La IA facilita que los atacantes produzcan señuelos pulidos y lancen nuevas variaciones más rápido de lo que pueden seguir las comprobaciones de reputación. Incluso cuando el mensaje parece convincente y la URL no tiene un historial conocido, el Nivel 1 aún necesita una forma rápida de ver qué sucede después del clic.

Con soluciones como Interactive Sandbox de ANY.RUN, los equipos pueden abrir enlaces sospechosos en un entorno de navegador real, interactuar con la página libremente y rastrear la cadena de ataque completa sin poner en riesgo los dispositivos o la infraestructura de la empresa.

Explore el análisis de phishing del mundo real

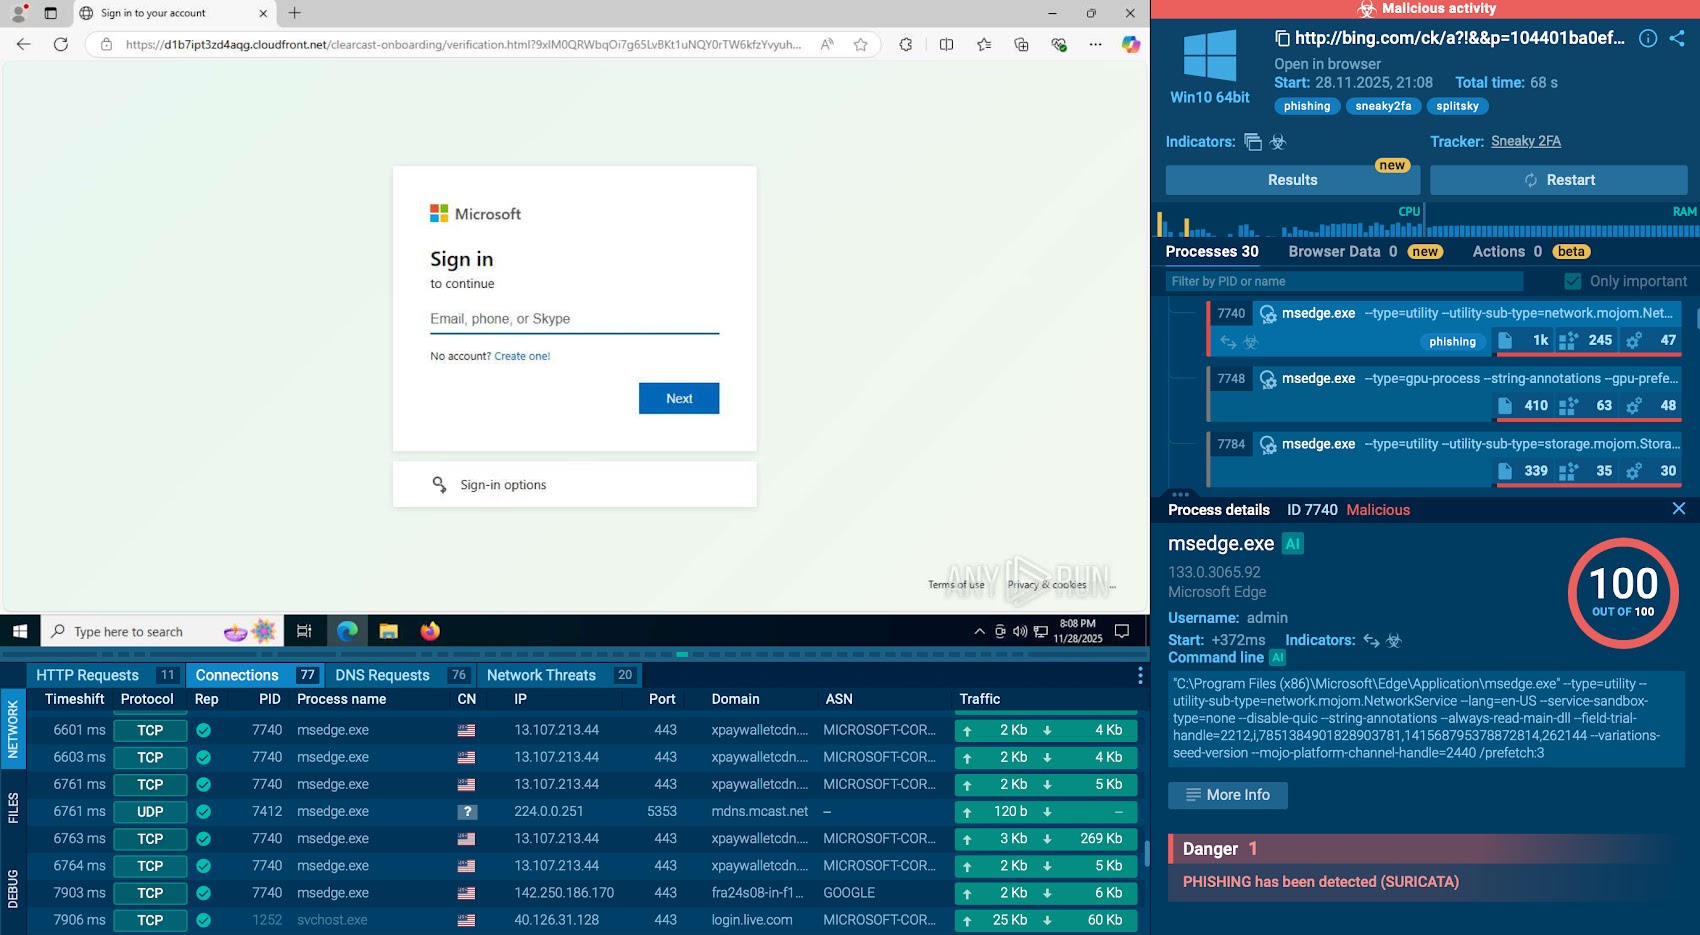
Página de inicio de sesión falsa de Microsoft 365 expuesta en 60 segundos dentro del entorno limitado de ANY.RUN

En este caso reciente, un enlace de LinkedIn Drive que parecía rutinario conducía a una página de inicio de sesión falsa de Microsoft 365 diseñada para robar credenciales corporativas. El contenido de phishing se alojó en AWS CloudFront y filtró dominios de correo electrónico gratuitos, lo que ayudó a permanecer fuera del radar. Dentro de la caja de arena, la cadena completa quedó expuesta en menos de 60 segundos.

Reduzca la sobrecarga del Nivel 1 con análisis de phishing basados ​​en evidencia y logre una clasificación hasta 3 veces más rápida con un 30 % menos de escalaciones.

Reducir la sobrecarga de SOC

Para un equipo de Nivel 1 ocupado, esto cambia el flujo de trabajo de inmediato:

  • Exponga lo que los controles de reputación no pueden ver: Los redireccionamientos, las páginas ocultas y los formularios de recolección de credenciales se revelan en una sola sesión.
  • Llegue a un veredicto sobre URL nuevas más rápido: Incluso cuando un enlace no tiene un historial conocido, el equipo puede ver qué sucede después del clic.
  • Reduzca el tiempo que las amenazas reales permanecen sin resolver: Los intentos de robo de credenciales y las descargas maliciosas se pueden confirmar antes de que queden enterrados en la cola.
  • Tome decisiones basadas en evidencia, no en suposiciones: El nivel 1 ve la cadena de ataque completa antes de decidir si cerrar o escalar el caso.

2. Procese más alertas de phishing sin agregar más trabajo manual

La automatización tradicional puede pasar por alto páginas de phishing que aparecen solo después de una redirección, un CAPTCHA o una acción específica del usuario. Puede ahorrar tiempo en comprobaciones básicas, pero aún así dejar a los equipos de Nivel 1 con resultados incompletos y más casos para investigar manualmente.

ANY.RUN combina automatización con interactividad. Una vez habilitado, el sandbox abre enlaces sospechosos en un navegador aislado, navega por páginas, resuelve CAPTCHA y desencadena pasos ocultos en la cadena de phishing, de forma muy similar a como lo haría un analista durante una investigación manual. Los miembros del equipo también pueden intervenir en cualquier momento cuando un caso necesite una mirada más cercana.

ANY.RUN sandbox resuelve automáticamente el desafío CAPTCHA

Esto ayuda a los SOC a manejar un mayor volumen de alertas sin ejercer más presión sobre el equipo:

  • Elimine los pasos de investigación repetitivos: La zona de pruebas navega por páginas, resuelve CAPTCHA y activa contenido oculto automáticamente.
  • Aumentar la capacidad del Nivel 1: El mismo equipo puede procesar más alertas de phishing de IA durante cada turno.
  • Absorba los picos sin agregar personal inmediatamente: La automatización reduce la cantidad de trabajo práctico necesario para cada caso.
  • Mantenga el juicio humano disponible para amenazas complejas: Los analistas pueden participar en la sesión siempre que un caso necesite una revisión más detallada.

3. Ofrezca informes listos para usar de nivel 2 para una respuesta más rápida

Incluso después de que el Nivel 1 confirme una amenaza, la escalada aún puede llevar tiempo. Cuando los hallazgos se encuentran dispersos en diferentes herramientas, los miembros superiores del equipo tienen que repetir las mismas comprobaciones antes de decidir qué hacer a continuación.

El informe de nivel 1 de ANY.RUN le brinda al equipo una transferencia clara y lista para usar tan pronto como se completa el análisis. Reúne el veredicto, los COI clave, los indicadores de comportamiento y el mapeo de MITRE ATT&CK. El resumen de IA explica lo que sucedió y por qué la actividad es maliciosa, mientras que las recomendaciones de IA sugieren los siguientes pasos de investigación y respuesta.

Informe de nivel 1 de ANY.RUN con detalles de análisis, incluido un resumen de IA y recomendaciones para una investigación más profunda y una transferencia más rápida

En lugar de pasar datos técnicos sin procesar al Nivel 2, el Nivel 1 puede enviar un informe estructurado que ya es útil para escalar y tomar medidas más rápidas.

Esto mejora el traspaso entre la clasificación y la respuesta:

  • Evite que el Nivel 2 reconstruya el caso: Los equipos senior reciben el veredicto, los IOC, los hallazgos de comportamiento y el mapeo de MITRE ATT&CK en un solo informe.
  • Reducir el retraso entre la clasificación y la contención: Los hallazgos claros y los próximos pasos recomendados ayudan al equipo de respuesta a actuar más rápido.
  • Estandarizar escalamientos entre turnos: Cada transferencia sigue la misma estructura, lo que reduce las brechas cuando los casos pasan entre los miembros del equipo.
  • Brindar a los líderes del SOC una mejor supervisión: Los gerentes pueden detectar cuellos de botella, revisar la calidad de la escalada y ver dónde está perdiendo tiempo el equipo.

Convierta una clasificación de phishing más rápida en una protección empresarial más sólida

El phishing con IA no sólo crea más alertas. Mantiene ocupados a los equipos de SOC mientras las amenazas reales se acercan al negocio.

Los equipos que se adelantan al problema le están brindando al Nivel 1 una forma más rápida de confirmar amenazas, cerrar casos de rutina y escalar los incidentes correctos con la evidencia ya preparada.

Equipos que utilizan el informe ANY.RUN:

  • El 94% de los usuarios reportan una clasificación más rápida y decisiones más claras
  • Hasta un 20% de disminución en la carga de trabajo de Nivel 1
  • 30% menos escalamientos de Nivel 1 a Nivel 2
  • MTTR hasta 21 minutos más rápido por caso

Reduzca la sobrecarga de Nivel 1 con ANY.RUN y brinde a su SOC más capacidad para contener amenazas de alto riesgo antes de que interrumpan las operaciones o provoquen incidentes costosos.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

El Departamento de Justicia publica los fundamentos legales para la recopilación de datos de votantes a nivel nacional

La administración Trump publicó una opinión legal que describe el fundamento jurídico detrás de sus esfuerzos de recopilación de datos de votantes a nivel nacional, justificando un papel federal agresivo en la investigación de la elegibilidad de los votantes, una posición que los tribunales han rechazado repetidamente en litigios relacionados. El memorándumpublicado el martes por la Oficina de Asesoría Legal del Departamento de Justicia, admite que si bien la administración electoral es “principalmente competencia de los estados”, los esfuerzos de la administración son un ejercicio legal de supervisión federal.

El Departamento de Justicia fundamenta ese razonamiento en una disposición de la Ley de Derechos Civiles de 1960, que exige a los funcionarios electorales mantener registros de votantes durante 22 meses después de una elección para poder investigar posibles violaciones de los derechos civiles. Según la lectura del memorando, esa regla de retención también otorga al Fiscal General autoridad para obtener copias de esos registros «cuando lo solicite por escrito».

El memorando también cita varias otras leyes electorales federales – como la Ley para Ayudar a Estados Unidos a Votar, la Ley de Registro Nacional de Votantes y la Ley de Derecho al Voto – como apoyo a los esfuerzos del poder ejecutivo. Sostiene que esos estatutos han requerido durante mucho tiempo que los estados modernicen y aseguren los sistemas de votación (incluidas mejoras de accesibilidad) y mantengan listas de votantes precisas eliminando a los votantes no elegibles.

El memorando sostiene además que la presencia potencial de uno o más no ciudadanos en las listas de votantes estatales es suficiente para desencadenar la recopilación de datos a nivel nacional del gobierno federal y los esfuerzos de intercambio con las autoridades de inmigración.

«Debido a que los extranjeros ilegales no son elegibles para votar, estas leyes de aplicación general también están implicadas por la presencia de un extranjero ilegal en las listas de votantes de un estado», afirma el memorando.

Múltiples tribunales federales han llegado a la conclusión opuesta, desestimando media docena de demandas del Departamento de Justicia y del Departamento de Seguridad Nacional que obligarían a los estados a cumplir. Además, los estados han confirmado repetidamente a través de recuentos, auditorías, investigaciones y demandas que el número de no ciudadanos registrados para votar (y que terminan votando) en las elecciones estadounidenses es infinitesimal.

David Becker, director ejecutivo del Centro de Investigación e Innovación Electoral, señaló en un correo en BlueSky que “6 tribunales, incluidos 2 jueces designados por el actual presidente, piensan que esta 'opinión' no vale ni el papel en el que está escrita”. Becker, ex abogado litigante principal del Departamento de Justicia en la sección de votación de la División de Derechos Civiles, ha argumentado constantemente que el poder ejecutivo y la Casa Blanca no tienen ningún papel legal o constitucional que desempeñar en la investigación del registro de votantes estatales.

Sarah Copeland Hanzas, Secretaria de Estado de Vermont, dio una reacción similar cuando CyberScoop pidió comentarios.

«No vale el papel en el que está impreso», dijo Hanzas en un comunicado. «O los electrones necesarios para almacenar y transmitir 41 páginas de fantasía».

Los funcionarios electorales se han resistido en gran medida a las demandas del gobierno federal. A principios de este año, el Secretario de Estado de Virginia Occidental, Kris Warner, dijo a CyberScoop que no tenía intenciones de entregar más información de la que ya está disponible públicamente.

“Si lo quieren, lo pueden tener: $500 dólares por [anyone to buy] «La lista estatal, pero no obtienen información personal», dijo Warner en una entrevista en enero. «La ley estatal dice que no compartiremos eso y mi trabajo es llevar a cabo la ley establecida por la legislatura de Virginia Occidental».

La incapacidad del gobierno federal para señalar pruebas serias de fraude electoral masivo o votación de no ciudadanos ha llevado a los estados a rechazar los intentos de recopilar datos confidenciales sobre cada votante en su estado, incluidos nombres, números de seguro social, domicilios, historial de votantes y otros detalles.

La administración dice que tiene la intención de cotejar los datos estatales con los registros de inmigración, compartir esos datos con el DHS y las agencias de control de inmigración y, en última instancia, crear su propia lista de votantes elegibles. Una orden ejecutiva emitida por la Casa Blanca a principios de este año buscaba negar fondos federales a los estados que no aceptaban listas de votantes del gobierno federal y ordenó al Fiscal General que investigara a los funcionarios electorales estatales en busca de discrepancias en las listas de votantes. Los grupos de votantes han cuestionado la legalidad de la orden, y los tribunales declararon en gran medida inconstitucional una orden ejecutiva anterior relacionada con las elecciones.

La administración ha demandado a docenas de estados que se han negado a entregar esos datos, aunque aún tiene que convencer a los tribunales del mérito. Un juez calificó los esfuerzos de la administración como “sin precedentes e ilegales” y acusó a la administración de torcer la Ley de Derechos Civiles y otras leyes federales que fueron aprobadas “para proteger victorias en materia de derechos civiles logradas con tanto esfuerzo que permiten el acceso a las urnas” para obtener acceso sin restricciones a los datos de los votantes estatales.

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

Ivanti EPMM CVE-2026-6973 RCE bajo explotación activa otorga acceso a nivel de administrador – CYBERDEFENSA.MX

Ivanti advierte que se ha explorado una nueva falla de seguridad que afecta a Endpoint Manager Mobile (EPMM) en ataques limitados en la naturaleza.

La vulnerabilidad de alta gravedad, CVE-2026-6973 (Puntuación CVSS: 7.2), es un caso de validación de entrada incorrecta que afecta a EPMM antes de las versiones 12.6.1.1, 12.7.0.1 y 12.8.0.1.

Permite a «un usuario autenticado remotamente con acceso administrativo lograr la ejecución remota de código», Ivanti dicho en un aviso publicado hoy.

«Somos conscientes de un número muy limitado de clientes explotados con CVE-2026-6973. La explotación exitosa requiere autenticación de administrador. Si los clientes siguieron la recomendación de Ivanti en enero de rotar las credenciales si fueron explotados con CVE-2026-1281 y CVE-2026-1340, entonces su riesgo de explotación por CVE-2026-6973 se reduce significativamente».

Actualmente no se sabe quién está detrás de los esfuerzos de explotación, si alguno de esos ataques tuvo éxito y cuáles eran los objetivos finales de los ataques.

Ciberseguridad

El desarrollo ha llevado a la Agencia de Seguridad de Infraestructura y Ciberseguridad de EE. UU. (CISA) a agregar la falla de sus vulnerabilidades explotadas conocidas (KEV), que exige que las agencias del Poder Ejecutivo Civil Federal (FCEB) apliquen las correcciones antes del 10 de mayo de 2026.

También parcheados por Ivanti en EPMM hay otras cuatro fallas:

  • CVE-2026-5786 (Puntuación CVSS: 8,8): una vulnerabilidad de control de acceso inadecuado que permite a un atacante autenticado remoto obtener acceso administrativo.
  • CVE-2026-5787 (Puntuación CVSS: 8,9): una vulnerabilidad de validación de certificados incorrecta que permite a un atacante remoto no autenticado hacerse pasar por hosts Sentry registrados y obtener certificados de cliente válidos firmados por una CA.
  • CVE-2026-5788 (Puntuación CVSS: 7,0): una vulnerabilidad de control de acceso inadecuado que permite a un atacante remoto no autenticado invocar métodos arbitrarios.
  • CVE-2026-7821 (Puntuación CVSS: 7,4): una vulnerabilidad de validación de certificados incorrecta que permite a un atacante remoto no autenticado inscribir un dispositivo que pertenece a un conjunto restringido de dispositivos no inscritos, lo que lleva a la divulgación de información sobre el dispositivo EPMM y afecta la integridad de la identidad del dispositivo recién inscrito.

«Los problemas solo afectan al producto EPMM local y no están presentes en Ivanti Neurons for MDM, la solución de gestión unificada de terminales basada en la nube de Ivanti, Ivanti EPM (un producto con un nombre similar pero diferente), Ivanti Sentry o cualquier otro producto de Ivanti», dijo la compañía. dicho.

Tres soluciones al proceso SOC que desbloquean la productividad de nivel 1 – CYBERDEFENSA.MX

¿Qué es lo que realmente está frenando el Nivel 1: la amenaza misma o el proceso que la rodea? En muchos SOC, los mayores retrasos no se deben únicamente a la amenaza. Provienen de flujos de trabajo fragmentados, pasos de clasificación manual y visibilidad limitada al principio de la investigación. Corregir esas brechas en los procesos puede ayudar al Nivel 1 a avanzar más rápido, reducir escalaciones innecesarias y mejorar la forma en que todo el SOC responde bajo presión.

Aquí hay tres correcciones de procesos que pueden ayudar a desbloquear un rendimiento de Nivel 1 más sólido.

Proceso #1: Reemplazar el cambio de herramientas con un flujo de trabajo de investigación multiplataforma

El problema: El nivel 1 a menudo pierde tiempo moviéndose entre diferentes herramientas, interfaces y procesos para investigar actividades sospechosas en todos los sistemas operativos. Lo que comienza como una alerta puede convertirse rápidamente en un flujo de trabajo fragmentado.

Por qué perjudica la productividad: El cambio constante de herramientas ralentiza la clasificación, interrumpe el enfoque de la investigación y dificulta la creación de una imagen clara de lo que está sucediendo. También aumenta la posibilidad de perder el contexto, especialmente cuando la actividad sospechosa involucra más de un entorno o no encaja perfectamente en un proceso de Windows.

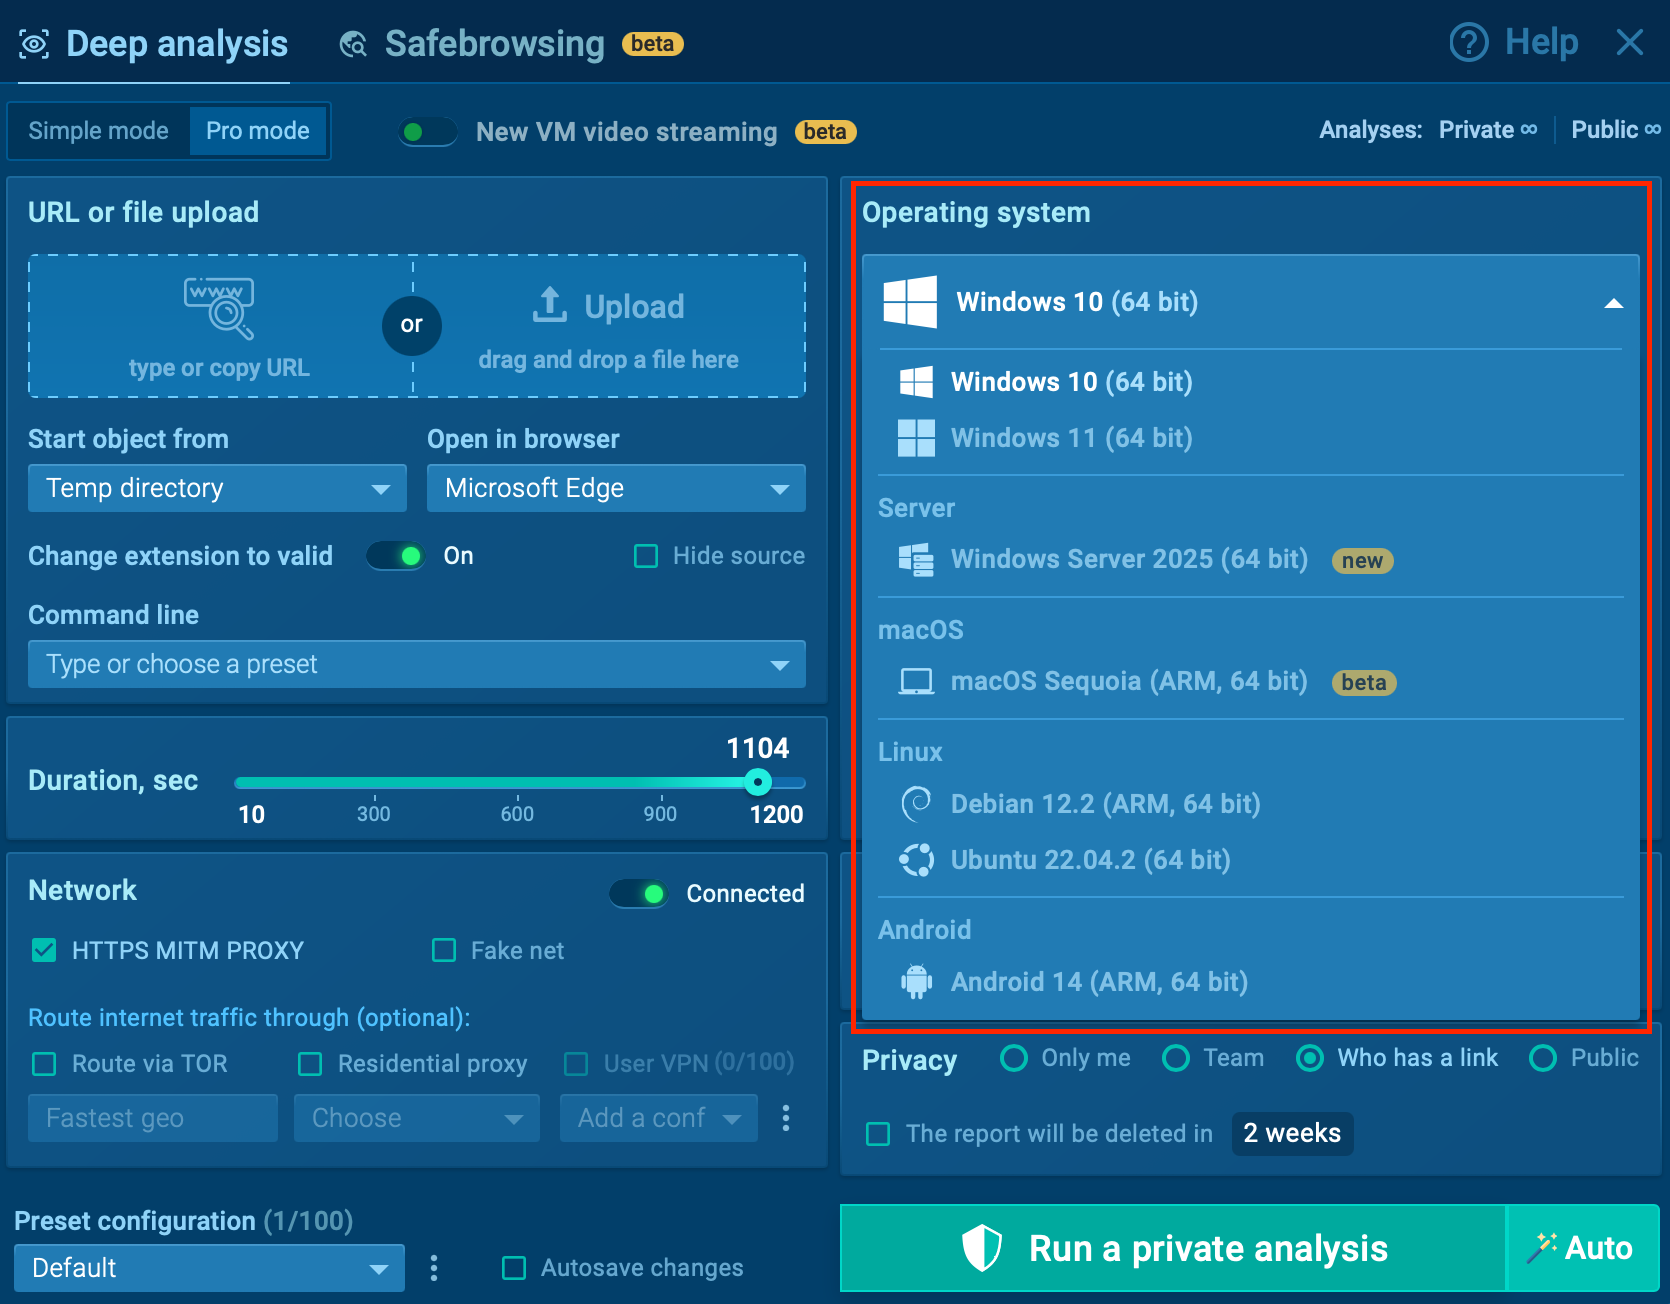
La solución: Reemplace los pasos de investigación fragmentados con un flujo de trabajo unificado para el análisis de URL y archivos sospechosos en todos los sistemas operativos. En lugar de enviar al Nivel 1 a través de herramientas y procesos separados para cada entorno, bríndeles un lugar para observar el comportamiento, recopilar evidencia y tomar decisiones. Esto reduce la fricción en la clasificación diaria y mantiene las investigaciones consistentes en Windows, macOS, Linux y Android.

Sandbox de ANY.RUN que admite 4 sistemas operativos principales

Esto es aún más importante a medida que macOS se convierte en una parte cada vez más importante de los entornos empresariales y los atacantes continúan expandiéndose más allá de las campañas tradicionales centradas en Windows. Los equipos de seguridad necesitan la capacidad de investigar amenazas relacionadas con macOS sin interrumpir su flujo de trabajo. Con ANY.RUN sandbox, Tier 1 puede analizar la actividad en macOS, Windows, Linux y Android en un solo lugar, reduciendo los puntos ciegos y acelerando las decisiones en las primeras etapas.

Consulte el ejemplo del mundo real: Miolab Stealer analizado en entorno macOS

Ladrón de Miolab analizado dentro del sandbox de ANY.RUN

Esta sesión de Miolab Stealer muestra por qué la visibilidad multiplataforma es importante en la clasificación moderna. La muestra imita un mensaje de autenticación legítimo de macOS, roba la contraseña del usuario, recopila archivos de directorios clave y envía los datos a un servidor remoto. Dentro del sandbox de ANY.RUN, este comportamiento se vuelve visible desde el principio, lo que ayuda al equipo a comprender rápidamente la amenaza y responder con más confianza.

Amplíe la visibilidad de las amenazas multiplataforma de su SOC y reduzca el riesgo de infracciones con un análisis unificado en macOS, Windows, Linux y Android.

Intégrelo en su SOC

Qué ayuda a lograr un flujo de trabajo unificado:

  • Menor fricción en la investigación en el Nivel 1, con menos tiempo perdido en herramientas desconectadas
  • Calidad de triaje más consistente en Windows, macOS, Linux y Android
  • Riesgo reducido de pérdida de contexto cuando las amenazas abarcan múltiples sistemas operativos
  • Decisiones de respuesta más rápidas y un camino más fluido desde la clasificación hasta la escalada

Proceso #2: Cambiar el Nivel 1 a una clasificación que priorice el comportamiento con automatización e interactividad

El problema: El nivel 1 suele dedicar demasiado tiempo a revisar alertas, indicadores estáticos y contexto disperso antes de comprender si un archivo o URL sospechoso es realmente malicioso.

Por qué perjudica la productividad: Los datos estáticos pueden sugerir que algo parece sospechoso, pero no siempre muestran lo que realmente hace el objeto durante la ejecución. Además de eso, muchas amenazas modernas no revelan su comportamiento completo sin acciones del usuario, como abrir un archivo, hacer clic en una página o completar parte de una cadena de interacción. Esto crea retrasos, agrega trabajo manual y aumenta las escaladas innecesarias.

La solución: Cambie el proceso de una revisión de alerta primero a una clasificación de comportamiento primero respaldada por la automatización y la interactividad. En lugar de depender principalmente de hashes, dominios o metadatos, deje que el Nivel 1 comience con una ejecución real en un entorno seguro. Esto es especialmente poderoso cuando la parte interactiva del análisis también se puede automatizar.

La interactividad automatizada de ANY.RUN abre el enlace malicioso oculto bajo un código QR sin ningún esfuerzo manual

En lugar de dedicar tiempo de analista a códigos QR, comprobaciones de CAPTCHA y otros pasos diseñados para retrasar o evadir la detección, el flujo de trabajo puede avanzar por sí solo hasta que aparezca un comportamiento significativo. Con ANY.RUN, los equipos pueden descubrir cadenas complejas de phishing y malware más rápido, reducir el esfuerzo manual durante la clasificación y tomar decisiones de escalamiento más claras antes. De hecho, en el 90% de los casos, el comportamiento necesario para validar una amenaza se vuelve visible dentro de los primeros 60 segundos de la detonación.

Se requiere menos de un minuto para analizar la cadena de ataque completa dentro del sandbox de ANY.RUN

Qué ayuda a lograr la clasificación de comportamiento primero con interactividad automatizada:

  • Mejor uso de la capacidad de Nivel 1, con menos tiempo perdido en acciones manuales repetitivas
  • Validación de amenazas más rápida antes de que la actividad sospechosa se convierta en una investigación más larga
  • Menos escaladas causado por evidencia poco clara en las primeras etapas
  • Mayor velocidad de respuesta SOC a través de una confirmación anterior basada en el comportamiento de intenciones maliciosas

Proceso #3: Estandarizar la escalada con evidencia lista para responder

El problema: Demasiadas investigaciones llegan a una escalada sin pruebas claras suficientes. El nivel 1 puede saber que algo parece sospechoso, pero el siguiente equipo todavía tiene que dedicar tiempo a reconstruir el contexto, volver a verificar el comportamiento y descubrir qué es lo que realmente importa.

Por qué perjudica la productividad: Cuando las escaladas son inconsistentes o incompletas, el SOC pierde tiempo en múltiples niveles. Los equipos de nivel 2 y de respuesta a incidentes tienen que repetir el trabajo, los casos urgentes tardan más en validarse y el liderazgo tiene menos confianza en la rapidez con la que el equipo puede pasar de la clasificación a la acción.

La solución: Estandarice la escalada en torno a evidencia lista para responder en lugar de suposiciones o notas parciales. Con ANY.RUN sandbox, el Nivel 1 puede escalar con un informe listo para manejar en lugar de reconstruir manualmente los hallazgos. Genera automáticamente un informe de análisis estructurado con evidencia de comportamiento, actividad del proceso, detalles de la red, capturas de pantalla y otro contexto recopilado durante la detonación.

Informe generado automáticamente para eficiencia y ahorro de tiempo.

Como resultado, el Nivel 2 recibe una visión más clara de la cadena de ataque desde el principio, lo que reduce el trabajo repetido y ayuda a pasar de la clasificación a la respuesta con menos demora.

Qué ayuda a lograr la escalada lista para la respuesta:

  • Carga de documentación reducida en el Nivel 1 durante la escalada
  • Traspaso más rápido al Nivel 2 con una imagen más clara de la cadena de ataque
  • Investigación menos repetida trabajar en todas las funciones SOC
  • Decisiones de respuesta más consistentes basado en evidencia conductual completa

Cómo estas correcciones de procesos mejoran el rendimiento del SOC

Cuando los equipos del SOC solucionan las brechas en los procesos que ralentizan el Nivel 1, el impacto va mucho más allá de una clasificación más rápida. Reducen la carga de trabajo manual, mejoran la calidad de la escalada y brindan a todo el equipo un camino más claro desde la validación inicial hasta la respuesta.

En la práctica, las organizaciones que utilizan ANY.RUN informan ganancias mensurables tanto en las operaciones diarias como en el rendimiento SOC más amplio.

  • Arriba a Carga de trabajo de Nivel 1 un 20% menor a través de una validación más rápida y menos trabajo de clasificación manual
  • Alrededor 30% menos escalamientos de Nivel 1 a Nivel 2ayudando a los miembros superiores del equipo a mantenerse enfocados en amenazas de mayor prioridad
  • El 94% de los usuarios reportan una clasificación más rápida en flujos de trabajo SOC reales
  • Arriba a Eficiencia/rendimiento de SOC 3 veces más fuerteimpulsado por una validación más rápida y flujos de trabajo más fluidos
  • Reduzca los costos de infraestructura reemplazando las configuraciones de análisis con mucho hardware por un entorno basado en la nube
  • un promedio Reducción de 21 minutos en MTTR por casoapoyando una contención y respuesta más rápidas
  • Menos fatiga de alerta y decisiones más tempranas basadas en evidencia a través de un acceso más rápido al comportamiento y contexto de las amenazas.

Fortalecer el desempeño de Nivel 1 y brinde a su SOC un camino más rápido desde la clasificación hasta la respuesta con ANY.RUN.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.