La falla de GhostLock de 15 años permite el escape de raíz y contenedor en la mayoría de las distribuciones de Linux – CYBERDEFENSA.MX

Los investigadores de Nebula Security han revelado GhostLock (CVE-2026-43499), una falla del kernel de Linux de hace 15 años que permite a cualquier usuario que haya iniciado sesión tomar el control total de raíz de una máquina que no ha sido parcheada. El código vulnerable se ha incluido de forma predeterminada en prácticamente todas las distribuciones principales desde 2011. La falla no necesita ningún permiso especial, ni configuraciones inusuales ni red.

Lo que revelan 2000 aplicaciones codificadas por Vibe expuestas sobre los límites de la mayoría de las pilas de seguridad – CYBERDEFENSA.MX

Shadow AI solía significar que los empleados pegaban cosas que no deberían en ChatGPT. Ahora significa algo más grande: empleados que crean aplicaciones completas con IA, las conectan a sistemas de producción y las publican en Internet abierta. Sin seguridad ni TI al tanto.

El artefacto pasó de un mensaje a un producto. La superficie de riesgo se movió con él.

En Los constructores de sombras informe (consíguelo aquí), una nueva investigación a nivel de categoría cubierta en mayo por Axios, WIRED y VentureBeat, Red Access identificó más de 380.000 activos web de acceso público en las principales plataformas de codificación de vibraciones.

Aproximadamente 5.000 parecían corporativos. Más de 2.000 de ellos tenían datos corporativos, operativos o personales confidenciales, ubicados en la web abierta, implementados sin controles de acceso básicos y, a menudo, otorgando acceso de administrador de forma predeterminada a cualquiera que alcanzara la URL. Seis continentes. Se examina cada industria. No se requiere explotación.

Dentro de las organizaciones, pasando sus auditorías mientras estas exposiciones estaban activas.

La nueva Shadow AI no se trata de indicaciones. Se trata de productos.

La codificación Vibe, el espacio más amplio de las plataformas de desarrollo impulsadas por IA donde cualquiera puede crear una aplicación funcional describiendo lo que quiere, ha comprimido lo que solía llevar meses a los equipos de ingeniería en algo que un no desarrollador puede enviar antes del almuerzo.

Un gerente de marketing crea un rastreador de campañas y lo conecta a la herramienta de BI donde se encuentran los números reales. Un gerente de operaciones crea un formulario de admisión de proveedores y lo conecta al sistema de emisión de boletos. Un equipo de finanzas crea un panel de preparación de la junta directiva y ingresa en él los datos de las facturas antes del viernes. Esas aplicaciones se conectan a sistemas de producción autorizados (CRM, ERP, herramientas de emisión de tickets, plataformas de BI) y con frecuencia se publican en la Internet abierta, con cualquier control de acceso que el creador haya configurado. A menudo, ninguno.

Las personas que hacen esto no son maliciosas. Son empleados competentes que resuelven problemas reales más rápido que su organización y hacen exactamente lo que las plataformas les invitaron a hacer. Las plataformas tampoco son villanas: ofrecen lo que pidió su audiencia original. Lo que no ha seguido el ritmo son las barreras técnicas y de comportamiento que rigen lo que sucede después de la construcción.

Esto no es Shadow IT en el antiguo sentido. La TI en la sombra estaba limitada: cuando un equipo compraba una cuenta de Trello con una tarjeta corporativa sin decírselo a nadie, los datos se guardaban dentro de un proveedor de SaaS no autorizado, pero al menos existían la identidad, los registros de auditoría y una superficie de gobernanza. Constructores de sombras invertir eso. La aplicación está diseñada a medida, los datos se cargan a medida, las integraciones son conexiones directas a sistemas de registro de producción y el artefacto a menudo se publica en Internet abierto. La plataforma debajo puede ser auditada; la aplicación construida sobre él no lo es. Está el constructor, la plataforma y la URL. ¿ÉL? Principalmente no en la habitación.

Por qué una pila de seguridad madura todavía no tiene esto en cuenta

El reflejo de un CISO que lee los números anteriores es comprobar la pila. EDR está en ejecución. DLP está configurado. CASB tiene licencia. Se han implementado firewall y SSE. Algunas organizaciones han agregado un navegador empresarial. Cada una de esas herramientas está haciendo aquello para lo que fue diseñada. La categoría se encuentra en los espacios entre ellos.

EDR ve el proceso del navegador, no la compilación que contiene. Para un agente de punto final, un Shadow Builder que utiliza una plataforma de codificación de vibración parece una actividad de navegador normal y no maliciosa: la misma forma de telemetría que alguien que lee las noticias. Cuando un EDR moderno o un navegador empresarial ve más profundamente, solo lo hace en los dispositivos que posee la organización y dentro de los navegadores que administra. Las computadoras portátiles personales, las máquinas de contratistas, los dispositivos BYOD y las pestañas del navegador personal son invisibles por definición.

DLP mira canales enumerados. Puede señalar a un usuario que pega datos regulados en un chat de IA conocido. No puede ver una aplicación codificada por vibración que se conecta mediante programación a una herramienta de BI aprobada a través de API, moviendo datos de nube a nube, evitando físicamente el punto final por completo.

CASB se creó para Shadow IT, para proveedores de SaaS con identidades reconocibles. No puede distinguir fácilmente una población ilimitada de aplicaciones personalizadas alojadas en los subdominios de una plataforma de codificación de vibración de la plataforma misma. Toda la población tiende a registrarse como un proveedor de SaaS aprobado.

Firewall y SSE ven el tráfico hacia el dominio de la plataforma pero carecen del contexto de aplicación como objeto comercial. Y la mayoría de las implementaciones de SASE/SSE son parciales; incluso las más maduras abandonan el problema del dispositivo no administrado no resuelto.

Ninguna de estas herramientas está fallando. La categoría simplemente se ubica en los espacios que la arquitectura existente deja entre capas, generando fragmentos de señal que nunca se ensamblan en una imagen única y gobernable.

Donde la visibilidad realmente tiene que vivir

La codificación vibe de un extremo a otro es un evento de sesión web. La compilación es un evento del navegador. La concesión de OAuth que vincula la nueva aplicación a un sistema empresarial autorizado es un evento del navegador. Los datos sobre los que se basa la aplicación se mueven a lo largo de la sesión. La implementación es un evento del navegador: la acción de publicación que convierte la compilación en una aplicación activa en una URL pública es un clic dentro de la misma pestaña donde sucedió todo lo demás.

Cada paso ocurre en la capa de sesión. No adyacente a él. Dentro de él.

Por lo tanto, un control ubicado en la capa de sesión ve toda la ruta de construcción, no un fragmento de ella. La plataforma utilizada. Los sistemas corporativos conectados a él y a través de qué mecanismo. Los datos entran y salen. El evento de publicación que coloca la aplicación en Internet abierto. Atribuible a una persona específica y a una instancia de aplicación específica, independientemente del navegador utilizado o de la ruta de red que tomó el tráfico. Y, lo que es más importante, independientemente de si el dispositivo es una computadora portátil corporativa o la máquina personal de un contratista.

Que hacer esta semana

Cuatro movimientos. Ninguno de ellos es una compra de tecnología.

Comience con el descubrimiento. Pregunte directamente a los empleados qué han construido. La mayoría de los Shadow Builders están haciendo un trabajo útil y no ocultan nada; el encuadre importa. Un mensaje para toda la fuerza laboral: Si ha creado una herramienta utilizando una plataforma de desarrollo de IA, cuéntenosla. No estamos auditando. estamos inventariando – llega más lejos en la primera pasada que un memorando de política o un despliegue de herramientas.

Luego mapear. Para cada aplicación que aparezca, capture a qué sistemas corporativos está conectada, cómo (OAuth, clave API, carga manual – diferentes pistas de auditoría) y si es accesible públicamente. La accesibilidad al público es la señal más viable a corto plazo.

Establecer un camino sancionado. Dale a Shadow Builders un lugar para decírtelo. Nombre las plataformas aprobadas, defina categorías de datos aceptables y establezca un estándar mínimo de autenticación. Menor fricción que la alternativa, que es que no te dicen nada.

Y luego acepte que el trabajo no es un inventario único. Se siguen creando aplicaciones codificadas en Vibe; La imagen que construyas este mes estará incompleta el próximo mes. La postura madura es un descubrimiento continuo en la capa donde realmente ocurre la actividad.

La categoría seguirá madurando. Las plataformas seguirán recalibrando los valores predeterminados. Ninguna de esas adaptaciones está terminada. La exposición existe en la mayoría de las empresas en este momento.

Red Access es la plataforma de seguridad de capa de sesión sin agentes diseñada exactamente para esto: visibilidad y gobernanza de nivel SSE en la sesión misma, en cualquier navegador y dispositivo, incluidos los no administrados. Implementable en horas. Solicita tu auditoría gratuita.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

La mayoría de los programas de reparación nunca confirman que la solución realmente funcionó – CYBERDEFENSA.MX

Los equipos de seguridad nunca han tenido mejor visibilidad de sus entornos y nunca han sido peores a la hora de confirmar que lo que reparan permanece fijo.

El informe M-Trends 2026 de Mandiant sitúa el tiempo medio de explotación en un estimado negativo de siete días. El DBIR 2025 de Verizon sitúa el tiempo medio para remediar las vulnerabilidades de los dispositivos perimetrales en 32 días. Es comprensible que estas cifras hayan impulsado a la industria hacia una respuesta clara: priorizar mejor, parchear más rápido. Ese consejo es necesario. También está incompleto. Porque la pregunta que todavía no recibe suficiente atención es la siguiente: cuando aplicas el parche, ¿cómo sabes que funcionó?

Los mitos no cambiaron el problema. Cambió la velocidad y facilidad de explotación.

Las discusiones sobre el impacto de la IA se han centrado en la velocidad: el desarrollo de exploits es cada vez más barato, más rápido y menos dependiente de las habilidades humanas de élite.

Para la remediación, esto cambia lo que está en juego. Muchas correcciones se marcan como «remediadas» cuando lo que realmente sucedió fue un parche del proveedor que resultó ser evitable, o una solución alternativa que dependía de que los atacantes se comportaran de cierta manera. Esas solían ser apuestas bastante seguras. Ya no lo son. La cuestión ya no es la velocidad de la remediación. La pregunta es si su solución realmente eliminó la exposición o simplemente movió el ticket a «Listo».

Parche perfecto, pero aún vulnerable

No todas las exposiciones se pueden parchear. Una regla de firewall débil deja la puerta abierta, por ejemplo. Se descubrió que la regla de política fue reescrita y supuestamente aplicada. ¿Pero lo fue? Cuando se aplica un parche, obtienes confirmación. Cuando se establece un privilegio, o se configura una política EDR o una configuración SIEM, es necesario realizar una prueba para verificar que haya surtido efecto.

La costura organizacional donde las semanas desaparecen

Incluso con hallazgos validados y de alta señal, el retraso entre la identificación y la remediación es principalmente organizacional. Encuentras el riesgo. No eres dueño de la solución. Los equipos que lo poseen operan en diferentes cronogramas con diferentes prioridades. Los hallazgos no se consolidan en acciones que la ingeniería pueda ejecutar, por lo que la señal se pierde nuevamente.

En entornos híbridos y nativos de la nube, la propiedad se vuelve más confusa: una vulnerabilidad puede ubicarse en la capa de aplicación, la capa de infraestructura o en una dependencia de terceros. Y una vez que llega a algún lugar, la remediación pasa por cualquier proceso que el equipo ya utilice, cambia las ventanas para TI y DevOps, y acelera los compromisos para ingeniería. Los resultados de seguridad terminan compitiendo con lo que ya estaba en el cronograma y, por lo general, pierden. Los atacantes acelerados por IA no están esperando la siguiente ventana de cambio o el próximo sprint.

La consolidación y la automatización son necesarias. No son suficientes.

El arrastre operativo tiene soluciones reales. Consolide los hallazgos relacionados para que varios problemas validados que se remontan al mismo balanceador de carga mal configurado se conviertan en un ticket con un solo propietario. Automatice el enrutamiento, la asignación, el cumplimiento de SLA y las rutas de escalamiento. Aprovecha el flujo de trabajo de las hojas de cálculo y los mensajes de Slack.

Pero el rendimiento y la velocidad indican qué tan rápido se mueve el sistema, no si está funcionando. Puede enviar un ticket consolidado a un propietario confirmado en minutos, hacer cumplir el SLA, escalarlo según lo programado y aun así cerrar un ticket que no eliminó la exposición. Tal vez la solución alternativa no sobreviva a un cambio de configuración, la solución se implementó en tres de los cuatro sistemas afectados o el parche se aplicó exitosamente pero dejó intacta una mala configuración circundante.

El ticket dice «resuelto». La vía de ataque sigue abierta. Cuando la IA puede derivar y volver a derivar de forma autónoma cadenas de exploits como lo demostró Mythos, la falsa confianza es lo más costoso en su programa de seguridad.

La reválida es la disciplina que falta

La revalidación debería significar que el riesgo ya no existe. Una nueva prueba sólo valida que el ataque original no existe. Debe validar que el riesgo en sí no existe.

Cuando cada solución se vuelve a probar y los resultados son visibles tanto para los líderes de seguridad como de ingeniería, las soluciones parciales y las soluciones alternativas se marcan inmediatamente en lugar de permanecer en un panel. Crea un circuito de retroalimentación que hace que todo el sistema se autocorrija.

El flujo de trabajo de remediación que se mantiene en las condiciones actuales: hallazgos validados consolidados en acciones de reparación, enviados a propietarios confirmados, rastreados hasta el cierre y luego revalidados para confirmar que el riesgo subyacente ha desaparecido, no solo la ruta de ataque original. Plataforma de Pentera está diseñado para ese modelo operativo, conectando el flujo de trabajo de remediación con la validación posterior a la corrección para que los equipos puedan medir si el riesgo realmente se eliminó.

Tres preguntas que separan un sistema de una esperanza

  • ¿Cuál es su tiempo promedio para remediar un hallazgo validado y explotable? Si no puede responder esto, está midiendo la actividad, no los resultados.
  • Cuando se aplica una solución, ¿cómo se confirma que funcionó? Si la respuesta es «el ingeniero cerró el ticket», pregúntese cuántos de esos hallazgos solucionados sobrevivirían a una nueva prueba.
  • ¿Está midiendo tickets cerrados o riesgo cerrado? El rendimiento de los tickets le indica que el equipo está ocupado. No te dice que la exposición ha desaparecido. Los programas mejoran cuando consolidan los hallazgos sobre el riesgo subyacente y rastrean si ese riesgo realmente desaparece.

Las organizaciones que entiendan esto serán las que dejen de tratar la remediación como algo que sucede después de que se haya realizado el trabajo de seguridad y comiencen a tratarla como el lugar donde realmente se mide el trabajo de seguridad.

Nota: Este artículo ha sido escrito y contribuido de manera experta por Nimrod Zantkern Lavi, Director de Producto, Pentera.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

La puerta trasera que los atacantes conocen y que la mayoría de los equipos de seguridad aún no han cerrado – CYBERDEFENSA.MX

Cada herramienta de inteligencia artificial, automatización del flujo de trabajo y aplicación de productividad que sus empleados conectaron a Google o Microsoft este año dejaron algo atrás: un token OAuth persistente sin fecha de vencimiento, sin limpieza automática y, en la mayoría de las organizaciones, nadie lo mira. Tus controles perimetrales no lo ven. Tu MFA no lo detiene. Y cuando un atacante consigue uno, no necesita una contraseña.

Las concesiones de OAuth no caducan cuando los empleados se van. No se restablecen cuando cambian las contraseñas. Y en la mayoría de las organizaciones, nadie los vigila.

El modelo tenía sentido cuando un puñado de aplicaciones aprobadas por TI necesitaban acceso al calendario. No se sostiene cuando cada empleado conecta de forma independiente herramientas de inteligencia artificial, automatizaciones de flujo de trabajo y aplicaciones de productividad directamente a su entorno de Google o Microsoft, cada uno de los cuales recibe un token persistente y con alcance, sin vencimiento automático y sin visibilidad centralizada.

Eso no es una mala configuración. Así es como está diseñado para funcionar OAuth. La brecha es que la mayoría de los programas de seguridad no se crearon para tenerlo en cuenta a escala.

Los CISO saben que es un problema. La mayoría no lo está resolviendo.

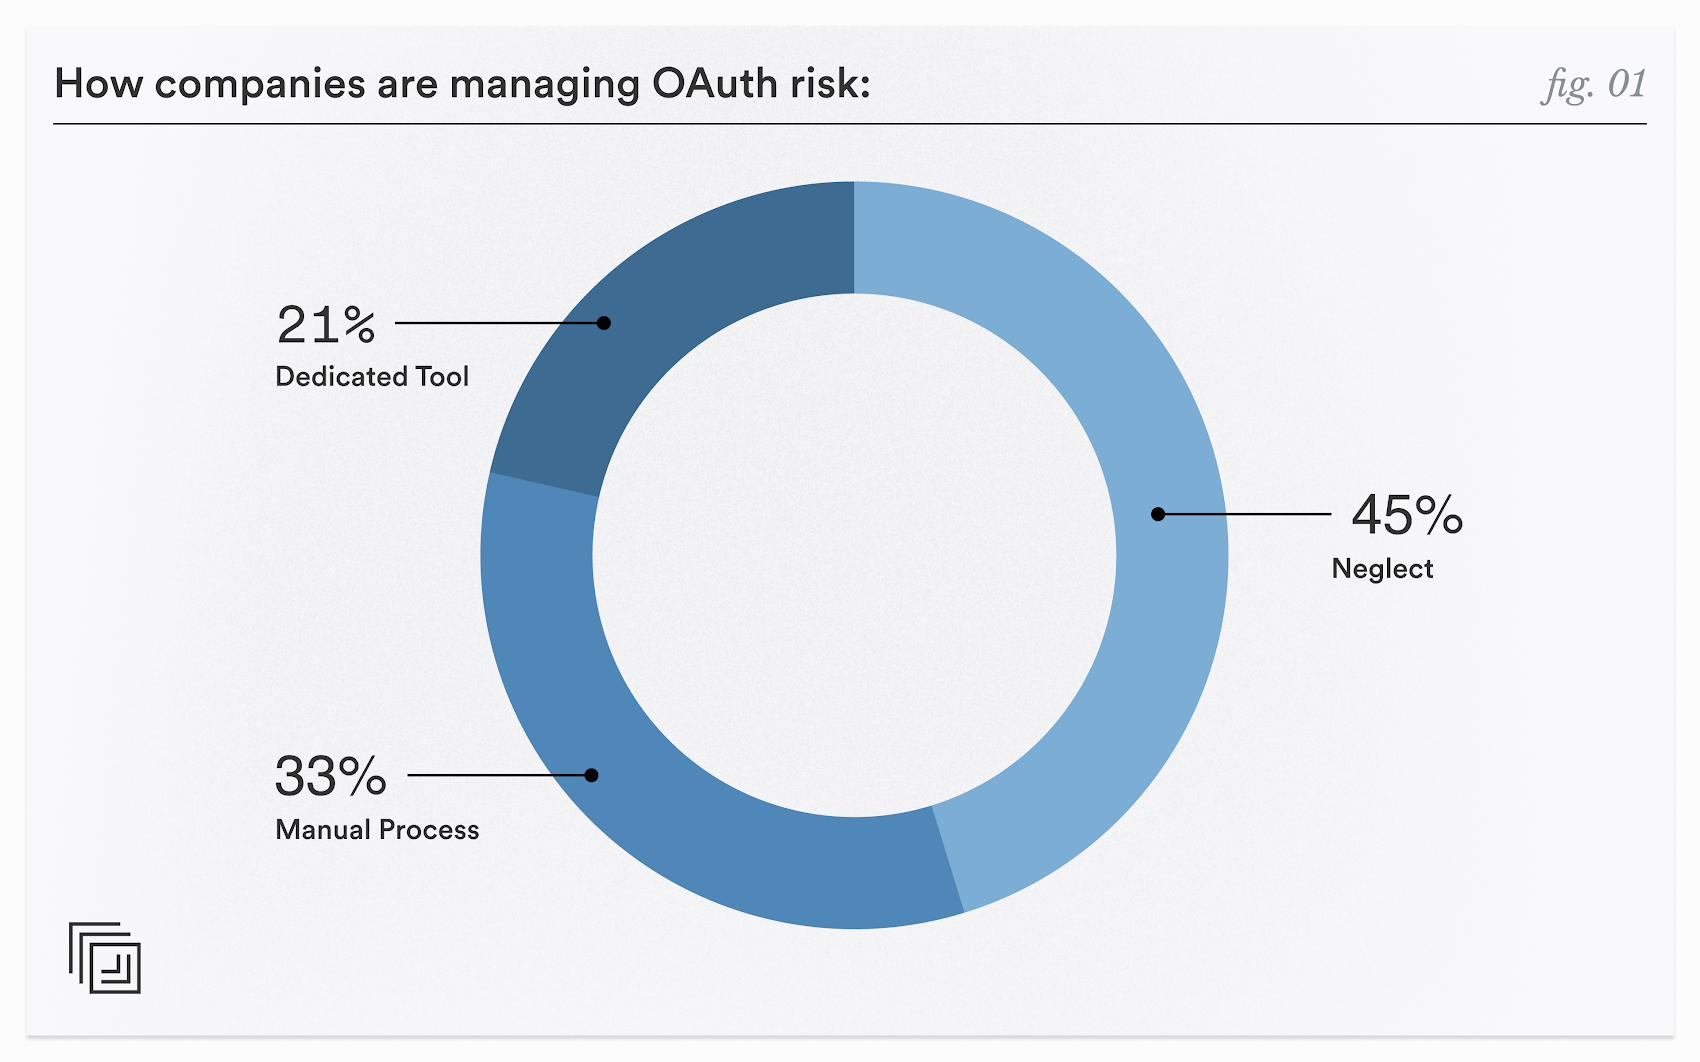
Nueva investigación de Material Security cuantifica la brecha entre conciencia y acción. El 80% de los líderes de seguridad consideran que OAuth no administrado representa un riesgo crítico o significativo. La mayoría lo ha dicho durante años.

Pero la conciencia no se traduce directamente en capacidad. Una parte sustancial de las organizaciones (45%) no está haciendo nada para monitorear las subvenciones de OAuth a escala. Muchos del resto (33%) ejecutan procesos manuales: rastrean las concesiones en hojas de cálculo, revisan los permisos ad hoc y dependen de los empleados para detectar comportamientos inusuales en las aplicaciones.

Las hojas de cálculo no son una capacidad de respuesta a amenazas. Son un registro de cuánta exposición una organización no sabe que tiene.

No es un riesgo teórico.

El argumento a favor de la visibilidad de OAuth a menudo se formula como si los empleados canalizaran información confidencial a herramientas de terceros sin visibilidad de TI. Ese es un problema real, pero es el más pequeño. El problema más apremiante es que las concesiones de OAuth son un vector de ataque activo. El incidente de deriva lo hace concreto.

Drift, una plataforma de participación de ventas adquirida por Salesloft, mantuvo integraciones de OAuth con instancias de Salesforce en cientos de organizaciones de clientes. Un actor de amenazas rastreado por la Unidad 42 de Palo Alto como UNC6395 obtuvo tokens de actualización de OAuth válidos (probablemente a través de campañas de phishing anteriores) y los utilizó para acceder a entornos de Salesforce que pertenecen a más de 700 organizaciones.

La estructura del ataque es una advertencia: los tokens eran legítimos, la integración era legítima. Desde la perspectiva de cualquier control perimetral, no pasaba nada. MFA se omitió por completo porque el atacante no estaba iniciando sesión; estaba presentando un token cuyo uso ya se había concedido a Drift. Una vez dentro, UNC6395 exportó datos sistemáticamente y los revisó en busca de credenciales: claves de acceso de AWS, tokens Snowflake, contraseñas.

Cloudflare, PagerDuty y decenas más se vieron afectados. Aún se está evaluando el alcance total.

El incidente de Drift no fue un ataque de una aplicación desconocida y sospechosa. fue un ataque a través de uno de confianza. La lección no es que las organizaciones deban restringir las integraciones de OAuth; es que confiar en una aplicación en el momento de la instalación no significa que siga siendo confiable, y que las concesiones de OAuth necesitan un monitoreo activo y continuo en lugar de una aceptación pasiva.

Cómo debe ser realmente el monitoreo

La generación actual de herramientas de seguridad de OAuth aborda el riesgo de OAuth en el punto de instalación. Comprueban si el alcance del permiso solicitado es excesivo. Pueden marcar aplicaciones de proveedores con mala reputación. Eso es útil, pero no suficiente. En el caso de Drift, una aplicación legítima cuyas credenciales fueron posteriormente robadas y utilizadas como arma, no detecta nada.

Para empezar, los niveles de confianza de los proveedores y el alcance de las aplicaciones son importantes, pero sólo cuentan una parte de la historia. Monitorear el comportamiento real de la aplicación (las llamadas a la API que realiza, las acciones que realiza) es fundamental para comprender qué es la aplicación. de hecho haciendo, no sólo lo que podría hacer. E incluso entonces, sin una visibilidad profunda de las cuentas a las que está vinculada la aplicación, todavía estás operando medio ciego. Una aplicación riesgosa vinculada a la cuenta de un pasante es una cosa; la misma aplicación utilizada por un VIP con acceso a innumerables correos electrónicos, archivos y sistemas confidenciales es otra completamente distinta.

El ataque Drift no involucró una aplicación sospechosa que solicitara permisos inusuales durante la instalación. Se trataba de una aplicación legítima cuyas credenciales fueron posteriormente comprometidas y utilizadas como arma. Una herramienta que sólo evalúa la subvención en el momento de su creación no habría visto nada malo. El riesgo se materializó más tarde, cuando el token fue robado y utilizado por un actor completamente diferente.

La seguridad efectiva de OAuth requiere:

  • Monitoreo continuo del comportamiento, no revisión puntual. ¿Qué hace realmente la aplicación después de que se le ha concedido acceso? La supervisión de las llamadas API que realiza una aplicación conectada a OAuth a lo largo del tiempo revela anomalías que ninguna revisión de permisos estáticos puede detectar: ​​picos repentinos en el acceso a los datos, consultas de tipos de datos inusuales y acceso en horas inesperadas.
  • Evaluación del radio de explosión. Una concesión de OAuth conectada a una cuenta con acceso de lectura a miles de documentos confidenciales y años de historial de correo electrónico es categóricamente diferente de la misma concesión en una cuenta recién aprovisionada con exposición limitada. El alcance de la cuenta del usuario determina el impacto potencial de una conexión OAuth comprometida o maliciosa. La puntuación de riesgo debería reflejar eso.
  • Respuesta graduada ajustada a la tolerancia al riesgo organizacional. Una aplicación obviamente maliciosa (proveedor desconocido, permisos amplios, comportamiento anómalo de la API desde el primer día) no debería permanecer en el entorno mientras un ticket pasa por una cola. Debe revocarse inmediatamente. Una integración de misión crítica de un proveedor importante que muestra anomalías leves justifica una revisión humana antes de tomar cualquier medida. La capa de respuesta debe ser lo suficientemente inteligente como para notar la diferencia.

Agente de corrección de amenazas OAuth del material

Seguridad material Agente de corrección de amenazas de OAuth se basa en este modelo más completo de riesgo de OAuth. El agente se ejecuta continuamente en el entorno de Google Workspace de una organización y monitorea cada aplicación conectada a OAuth, no solo las nuevas en el momento de la concesión.

Para cada aplicación conectada, el agente evalúa tres factores juntos:

  • Análisis de alcance y confianza de los proveedores – la línea de base estándar en la que se detienen la mayoría de las herramientas
  • Monitoreo del comportamiento de llamadas API reales realizado por la aplicación a lo largo del tiempo, lo que revela anomalías frente al comportamiento esperado
  • Evaluación del radio de explosión según los niveles de acceso y la exposición de datos de las cuentas a las que está conectada la aplicación

Estos datos se combinan en una señal de riesgo que refleja tanto la probabilidad de un problema como su impacto potencial. Cuando el agente identifica una subvención de alto riesgo, puede actuar de inmediato y revocar el token antes de que se produzca algún daño. Para situaciones de menor certeza que involucran aplicaciones de misión crítica, presenta el hallazgo al equipo de seguridad con contexto completo: qué es la aplicación, qué ha estado haciendo, a qué tiene acceso y cuál es la puntuación de riesgo.

Las organizaciones configuran sus propios umbrales: cuánto riesgo desencadena la remediación automatizada y dónde está el límite para exigir la aprobación humana. El agente está diseñado para mantener a los equipos de seguridad informados sobre las decisiones que importan y fuera de control sobre las que no lo son.

Cerrando la puerta trasera

Las concesiones de OAuth son la forma predeterminada en que las aplicaciones de terceros y las herramientas de inteligencia artificial se conectan al espacio de trabajo empresarial. Eso no va a cambiar. La cantidad de subvenciones en la mayoría de los entornos seguirá creciendo a medida que se acelere la adopción de la IA. Decir a los empleados que no pueden usar herramientas de inteligencia artificial no es una postura de seguridad viable para la mayoría de las organizaciones, y no abordaría la amenaza que representan las aplicaciones que son legítimas en el momento de la instalación y maliciosas más adelante.

La respuesta no es menos concesiones de OAuth. Es una mejor visibilidad de los que existen, un monitoreo continuo de su comportamiento y la capacidad operativa para responder lo suficientemente rápido y lo suficientemente inteligente como para evitar interrumpir las integraciones que mantienen el negocio en funcionamiento.

Para los equipos de seguridad que desean visibilidad de lo que realmente está conectado a su entorno y la capacidad de responder cuando algo cambia, comuníquese con Seguridad material para una demostración del Agente de corrección de amenazas de OAuth.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

Qué buscar en una plataforma de gestión de exposición (y en qué se equivoca la mayoría) – CYBERDEFENSA.MX

Cada equipo de seguridad tiene una versión de la misma historia. El trimestre finaliza con cientos de vulnerabilidades cerradas. Los salpicaderos están llenos de verde. Entonces alguien en una reunión de liderazgo pregunta: «Entonces, ¿estamos realmente más seguros ahora?»

Grillos.

La sala se queda en silencio porque una respuesta honesta requiere contexto, algo que los recuentos de parches y las puntuaciones CVSS nunca fueron diseñados para proporcionar. La gestión de la exposición se creó para proporcionar este contexto: cerrar la brecha entre los esfuerzos de remediación y la reducción real del riesgo. El mercado ha respondido con una inundación de plataformas afirmando entregarlo. Sin embargo, la pregunta que se hacen los líderes de seguridad es: ¿Qué plataforma de gestión de exposición realmente lo proporciona?

En este artículo, desglosaré los cuatro enfoques dominantes para la gestión de la exposición, explicaré lo que cada uno puede ofrecer y lo que no, y expondré cinco criterios de evaluación que le ayudarán a separar las plataformas creadas para reducir el riesgo de tu negocio único y el medio ambiente desde plataformas creadas para informar sobre los riesgos en la naturaleza.

Cuatro enfoques, cuatro arquitecturas

La mayoría de las plataformas de gestión de exposición se clasifican en una de cuatro categorías, cada una de las cuales está determinada por cómo el proveedor construyó (o armó) la plataforma y cómo procesa los datos.

  1. Plataformas de cartera cosidas son producto de adquisición(es). Un proveedor compra soluciones puntuales (seguridad en la nube, escaneo de vulnerabilidades, análisis de identidad, etc.) y las agrupa bajo su propia marca. En estas plataformas, cada producto conserva su propio modelo de datos y descubre su propio subconjunto de exposiciones. Luego, el proveedor puede unificar las exposiciones en una consola compartida, y eso puede parecer una integración. Pero en la práctica, cada módulo todavía opera con sus propios datos y produce sus propios hallazgos, con poca correlación o interconexión entre ellos.
  2. Plataformas de agregación de datos ingiera los resultados de sus escáneres existentes y herramientas de terceros. Luego normalizan los datos y los presentan en una interfaz unificada. Estas plataformas sólo pueden funcionar con lo que reciben. Eso significa que si los hallazgos ingeridos están desconectados, no hay forma de correlacionar cómo una exposición podría permitir la siguiente.
  3. Plataformas especializadas de dominio único Profundice en un área: configuraciones erróneas de la nube, vulnerabilidades de red, exposiciones de identidad y superficie de ataque externo. Ofrecen resultados sólidos, pero sólo en su ámbito específico de especialización. Se topan con desafíos cuando las exposiciones en un dominio se encadenan con exposiciones en otro dominio, y la plataforma no tiene forma de modelar esa relación.
  4. Plataformas integradas se crean desde cero para descubrir y correlacionar múltiples tipos de exposición (credenciales, configuraciones incorrectas, CVE, problemas de identidad, configuraciones de nube) en el mismo motor. La plataforma crea un gemelo digital del entorno y mapea cómo los atacantes pueden moverse lateralmente de una exposición a la siguiente, a través de límites locales, de nube e híbridos.

Cinco preguntas que revelan lo que realmente puede hacer una plataforma

La arquitectura detrás de cada uno de los cuatro enfoques tiene consecuencias reales sobre lo que su equipo puede ver, validar y actuar. ¿Cómo se nota la diferencia cuando se evalúa? Comience por hacer estas cinco preguntas:

1. ¿Cuántos tipos de exposición puede descubrir y con qué profundidad analiza cada uno de ellos?

Los CVE representan aproximadamente el 25% de las exposiciones que explotan los atacantes. Las configuraciones erróneas, las credenciales almacenadas en caché, los permisos excesivos y las debilidades de identidad constituyen el resto. Las carteras unidas se limitan a aquello para lo que se creó cada producto adquirido. Los agregadores sólo pueden normalizar lo que ofrecen sus feeds. Las plataformas de dominio único cubren sólo una porción del pastel. Una plataforma integrada debería cubrir tanto los existentes como (especialmente) emergente tipos de exposición, como cargas de trabajo de IA e identidades de máquinas, de forma nativa.

Y la cobertura por sí sola no le dice lo suficiente. Lo que realmente sabe la plataforma cada exposición importa tanto. Una plataforma que ingiere hallazgos de herramientas de terceros se limita a los metadatos que esas herramientas recopilan: sus condiciones de explotabilidad, su orientación de remediación, su investigación. Una plataforma que descubre exposiciones controla de forma nativa cada capa de información para cada hallazgo, desde la explotabilidad hasta la reparación. Si su plataforma no puede ver ciertos tipos de exposición, tiene puntos ciegos. Si los ve pero le falta profundidad, estás trabajando con ruido.

2. ¿Puede mapear rutas de ataque entre entornos?

Algunos productos cosidos muestran rutas de ataque. Esas rutas se derivan de la topología de la red y se basan únicamente en la conectividad. La plataforma nunca modela cómo un atacante se movería lateralmente de una exposición a la siguiente. Los agregadores no producen ninguna ruta, solo listas normalizadas de hallazgos desconectados.

La verdadera prueba es si la plataforma puede trazar caminos a través de los límites del entorno. Un atacante que captura las credenciales de la nube localmente puede eludir todas las defensas nativas de la nube, porque el camino comenzó fuera de la visibilidad de la plataforma de la nube. Una vulnerabilidad externa puede parecer de baja prioridad de forma aislada, pero si se asigna a una entidad interna con un camino hacia un activo crítico, es una emergencia. La mayoría de las plataformas no pueden establecer esas conexiones. Exploran cada entorno por sí solo y dejan inexplorados los espacios entre ellos.

3. ¿Valida la explotabilidad?

La mayoría de las plataformas verifican una o dos condiciones por exposición, limitadas por los metadatos que almacenan para cada hallazgo y la información que recopilan de cada entidad en su entorno. Pero la verdadera validación significa probar múltiples condiciones: ¿la biblioteca vulnerable está cargada por un proceso en ejecución? ¿El puerto está abierto y accesible? La plataforma debe ofrecer respuestas binarias (explotables o no, alcanzables o no, camino a activos críticos o no), todas ellas basadas en su entorno real, no en suposiciones generales.

4. ¿Tiene en cuenta los controles de seguridad?

Una vulnerabilidad CVSS 9.8 bloqueada por un firewall no se puede utilizar para movimiento lateral… porque está bloqueada. Una exposición de identidad 5.5 con una ruta directa a un controlador de dominio es una emergencia. Las plataformas que ignoran los firewalls, MFA, EDR y la segmentación pueden hacer que su equipo persiga hallazgos que no conllevan ningún riesgo real y pierda aquellos que realmente amenazan sus activos críticos. Si los controles de seguridad no forman parte del análisis de la ruta de ataque, su priorización le indicará la dirección equivocada y seguirá estando expuesto.

5. ¿Cómo prioriza?

La priorización debería responder a una pregunta: ¿Esta exposición pone en riesgo un activo crítico? La clasificación basada en puntuaciones ignora su entorno único. La clasificación basada en etiquetas de activos ignora los activos en el radio de explosión de una exposición. La clasificación de la ruta supuesta nunca valida la explotabilidad. Los tres pueden abrumar a los equipos de TI porque ninguno de ellos conecta los hallazgos con lo que la empresa realmente necesita proteger.

La priorización efectiva comienza con sus activos críticos y avanza hacia atrás. La plataforma debe demostrar que la exposición es explotable, que un atacante puede alcanzarla y que el camino conduce a algo que la empresa no puede permitirse perder. Cuando una plataforma mapea todo eso en un gráfico, surgen puntos de estrangulamiento: lugares donde una solución elimina múltiples rutas de ataque. En entornos de grandes empresas, eso reduce la lista de prioridades a aproximadamente el 2% de todas las exposiciones.

Lo que esto significa para su equipo

La elección de la arquitectura de la plataforma determina qué tan seguro será su entorno y cómo su equipo dedica su tiempo a llegar allí. Las plataformas unidas y agregadas pueden hacer que los equipos tengan que luchar para conciliar sus hallazgos entre herramientas, pelear con TI por soluciones que pueden no reducir el riesgo y perseguir exposiciones que conducen a callejones sin salida. Las plataformas de dominio único brindan profundidad en un área pero dejan puntos ciegos en el resto de la superficie de ataque.

Un enfoque integrado elimina esos gastos generales. Correlaciona las exposiciones con rutas de ataque validadas, tiene en cuenta los controles que tiene implementados e identifica las soluciones que eliminan el mayor riesgo con la menor cantidad de acciones. Cuando una remediación cierra un cuello de botella, las plataformas de gestión de exposición continua actualizan el gráfico en tiempo real. De esa manera, sabrá que las exposiciones que antes parecían urgentes ahora no conducen a ninguna parte y su cola de prioridades siempre refleja el riesgo actual.

Cuando su plataforma de gestión de exposición pueda validar la explotabilidad, modelar controles de seguridad y mapear cada ruta viable hacia sus activos críticos, podrá responder la pregunta que aparece al principio de este artículo (¿Estamos realmente más seguros?) con un honesto ¡Sí!.

Nota: Este artículo fue escrito cuidadosamente y contribuido para nuestra audiencia por Maya Malevich, directora de marketing de productos de XM Cyber.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

Mythos cambió las matemáticas sobre el descubrimiento de vulnerabilidades. La mayoría de los equipos no están preparados para la parte de remediación

Claude Mythos Preview de Anthropic ha dominado las discusiones sobre seguridad desde su anuncio el 7 de abril. Los primeros informes describen un poderoso sistema de inteligencia artificial centrado en la ciberseguridad capaz de identificar vulnerabilidades a escala y plantear serias dudas sobre la rapidez con la que las organizaciones pueden validar, priorizar y remediar lo que encuentran.

El debate que siguió se centró principalmente en las preguntas correctas: ¿Se trata de un cambio radical o de un avance gradual? ¿Restringir el acceso a Microsoft, Apple, AWS y JPMorgan realmente reduce el riesgo, o simplemente concentra la ventaja defensiva entre los que ya están bien defendidos? ¿Qué sucede cuando los adversarios (actores estatales, empresas criminales) crean capacidades equivalentes?

Estos son importantes. Pero hay un problema operativo más silencioso que está recibiendo menos atención y es el que realmente determinará si la mayoría de las organizaciones sobrevivirán a este cambio.

La brecha entre el descubrimiento y la remediación

El anuncio de Mythos y la conversación más amplia sobre seguridad de la IA que inició tiene que ver en gran medida con descubrimiento vulnerabilidades más rápido. Eso es valioso. Pero encontrar una vulnerabilidad y fijación Son dos flujos de trabajo completamente diferentes, y la brecha entre ellos es donde la mayoría de los programas de seguridad desaparecen silenciosamente. Esa es exactamente la brecha PlexTrac Fue construido para cerrar.

Considere lo que normalmente sucede después de que una prueba de penetración o un análisis de vulnerabilidad revela un hallazgo crítico: entra en una hoja de cálculo, un ticket o un informe en PDF que llega a la bandeja de entrada de alguien. El equipo de seguridad lo sabe. El equipo de ingeniería puede que lo sepa o no. La propiedad de la remediación es ambigua. No existe una forma clara de rastrear si el parche realmente se envió, si se le quitó prioridad o si alguna vez se programó una nueva prueba. Mientras tanto, los hallazgos lo son.

Los modelos de IA como Mythos acelerarán la aporte lado de este oleoducto dramáticamente. Pueden descubrir vulnerabilidades a un ritmo y profundidad que los equipos rojos humanos simplemente no pueden igualar. Pero si la infraestructura organizacional para clasificar, priorizar, comunicar y verificar las soluciones no ha seguido el ritmo, un descubrimiento más rápido sólo significa una acumulación de problemas críticos sin resolver que crece más rápidamente.

Éste es el problema que un modelo como Mythos en realidad agudiza. Si su proceso de pentest actual tarda tres semanas en revelar diez hallazgos de alta gravedad, y la remediación ya está luchando por mantenerse al día, ¿qué sucede cuando esa misma área de superficie se escanea continuamente y genera hallazgos a un ritmo diez veces mayor?

El problema del falso positivo de Schneier es real

Bruce Schneier planteó un punto importante en su artículo: no conocemos la tasa de falsos positivos de Mythos en la producción sin filtrar. Anthropic informa un 89% de acuerdo de gravedad con los contratistas humanos en los hallazgos que exhibido—Pero esa es una muestra seleccionada, no una distribución completa. Los sistemas de inteligencia artificial que detectan casi todos los errores reales también tienden a generar vulnerabilidades que parecen plausibles en el código parcheado o corregido.

Esto es importante desde el punto de vista operativo. Una herramienta que genera falsos positivos a escala que suenan muy confiables no reduce la carga del equipo de seguridad, sino que la aumenta. Cada hallazgo crítico espurio que debe ser evaluado y descartado es tiempo que un ingeniero de seguridad no dedica a uno real. El valor del descubrimiento de vulnerabilidades asistido por IA solo se materializa si los hallazgos que surgen de él pueden evaluarse de manera eficiente, contextualizarse frente al riesgo comercial real y enviarse a las personas adecuadas.

Cómo luce realmente el problema de la infraestructura

Los equipos mejor posicionados para absorber la velocidad de descubrimiento de la era de los Mitos son los que ya tienen tres cosas en su lugar:

Gestión centralizada de hallazgos. Ni un sistema de tickets, ni un tablero JIRA adjunto a una hoja de cálculo. Un lugar especialmente diseñado donde los hallazgos de vulnerabilidades de múltiples fuentes (resultados del escáner, informes de pentest, interacciones del equipo rojo) se encuentran en un formato normalizado y consultable. Sin esto, la integración de los hallazgos generados por la IA sólo añade otro silo de datos.

Priorización contextualizada del riesgo. Las puntuaciones CVSS sin procesar son un punto de partida, no una decisión. Un hallazgo crítico en un sistema interno y aislado no es el mismo riesgo que el mismo hallazgo en una API orientada al cliente. Las organizaciones que solo pueden ordenar por puntuación de gravedad se verán abrumadas cuando el descubrimiento de IA comience a producir hallazgos en volumen; Las organizaciones que pueden calificar según la criticidad de los activos, el impacto comercial y el contexto de exposición pueden realizar una clasificación inteligente.

Remediación dinámica basada en riesgos mediante puntuación configurable

Seguimiento de remediación de circuito cerrado. Aquí es donde la mayoría de los programas realmente fallan. Un hallazgo que no se verifica como solucionado es solo un pasivo que tiene un nombre. Las pruebas continuas, los flujos de trabajo de corrección estructurados y las transferencias claras de propiedad no son características interesantes: son la diferencia entre un programa de seguridad que mejora con el tiempo y uno que simplemente acumula riesgos documentados.

PlexTrac es una plataforma de gestión de exposición e informes pentest que se ha estado construyendo exactamente en esta dirección: datos de hallazgos centralizados, priorización de riesgos contextuales y flujos de trabajo de remediación estructurados.

Mythos (y herramientas similares) serán muy buenos para indicarle que su casa tiene problemas estructurales. PlexTrac es la capa operativa que garantiza que esos problemas realmente se solucionen, se asigne al contratista adecuado y alguien verifique el trabajo antes de cerrarlo. Ambos son necesarios. La mayoría de las organizaciones han invertido en el equivalente de mejores inspecciones de viviendas y al mismo tiempo han permitido que el sistema de seguimiento de reparaciones permanezca en un documento de Google compartido.

El problema de acceso que Schneier identificó también es un problema de flujo de trabajo

Una crítica al Proyecto Glasswing es que concentrar el acceso a Mythos entre 50 grandes proveedores significa que las organizaciones mejor equipadas para actuar sobre los hallazgos los obtienen primero. Las empresas Fortune 500, como señaló el artículo de Fortune del ex director cibernético nacional, están mejor posicionadas para absorber y remediar; son las PYME, los operadores de infraestructura regional y los sistemas industriales especializados los que están más expuestos y cuentan con menos recursos.

Se trata de un problema estructural de acceso que las políticas tendrán que abordar. Pero también implica un problema de flujo de trabajo: incluso si se democratizara el acceso, muchas organizaciones más pequeñas no tienen la infraestructura operativa para convertir los hallazgos de seguridad generados por IA en soluciones ejecutadas. Las herramientas que reducen los gastos generales de ese proceso (informes más rápidos, comunicación de hallazgos más clara, transferencias de remediación con menor fricción) son posiblemente más importantes para esas organizaciones que para las empresas que ya pueden dedicar personal al problema.

La conclusión práctica

El momento Mythos es una función forzada útil. No porque signifique que sus sistemas definitivamente estarán comprometidos mañana, sino porque hace visible una brecha que ha estado creciendo silenciosamente durante años: los equipos de seguridad están mejorando en la búsqueda de problemas, mientras que la maquinaria organizacional para solucionarlos ha evolucionado mucho más lentamente.

La respuesta correcta no es el pánico y no es esperar a ver si el acceso a Glasswing eventualmente se expande para incluirlo a usted. Está tomando el anuncio de Mythos como un aviso para auditar su propio proceso de remediación: ¿Cuánto tiempo lleva un hallazgo crítico pasar del descubrimiento a la solución verificada? ¿Cuántos hallazgos abiertos de alta gravedad se encuentran actualmente en algún estado ambiguo de «estar trabajando»? ¿Puede realmente volver a realizar la prueba después de la corrección o simplemente confía en que el ticket de ingeniería se cerró?

Esas preguntas no requieren acceso a Mythos para responder. Y para la mayoría de los equipos, las respuestas serán más incómodas que cualquier cosa del documento técnico de 245 páginas de Anthropic.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.
Por qué la mayoría de las implementaciones de IA se estancan después de la demostración – CYBERDEFENSA.MX

La forma más rápida de enamorarse de una herramienta de inteligencia artificial es ver la demostración.

Todo avanza rápidamente. Indica que aterriza limpiamente. El sistema produce resultados impresionantes en segundos. Se siente como el comienzo de una nueva era para tu equipo.

Pero la mayoría de las iniciativas de IA no fracasan por culpa de una mala tecnología. Se estancan porque lo que funcionó en la demostración no sobrevive al contacto con operaciones reales. La brecha entre una manifestación controlada y la realidad del día a día es donde los equipos tienen problemas.

La mayoría de las demostraciones de productos de IA están diseñadas para resaltar el potencial, no la fricción. Utilizan datos limpios, entradas predecibles, indicaciones cuidadosamente elaboradas y casos de uso bien comprendidos. Los entornos de producción no se ven así. En operaciones reales, los datos son confusos, las entradas son inconsistentes, los sistemas están fragmentados y el contexto está incompleto. La latencia importa. Los casos extremos rápidamente superan en número a los ideales. Esta es la razón por la que los equipos suelen ver un estallido inicial de entusiasmo seguido de una desaceleración una vez que intentan implementar la IA de manera más amplia.

Lo que realmente se rompe en la producción.

Una vez que la IA pasa de la demostración a la implementación, tienden a surgir algunos desafíos específicos.

La calidad de los datos se convierte en un problema real. En entornos de seguridad y TI, Los datos a menudo se distribuyen en múltiples herramientas con diferentes formatos. y distintos niveles de confiabilidad. Un modelo que funciona bien con datos de demostración limpios puede tener problemas cuando recibe entradas ruidosas o incompletas.

La latencia se vuelve visible. Un modelo que se siente rápido de forma aislada puede introducir retrasos significativos cuando se integra en flujos de trabajo de varios pasos que se ejecutan a escala.

Los casos extremos empiezan a importar. Los flujos de trabajo de producción incluyen excepciones, escenarios inusuales y comportamiento impredecible del usuario. Los sistemas que manejan bien casos comunes pueden fallar rápidamente cuando se enfrentan a la complejidad del mundo real.

La integración se convierte en un factor limitante. La mayor parte del trabajo operativo requiere la coordinación entre múltiples sistemas. Si una herramienta de IA no puede conectarse profundamente con esos flujos de trabajo, su impacto sigue siendo limitado independientemente de cuán capaz sea el modelo subyacente.

La gobernanza es donde se acaba el entusiasmo

Más allá de los desafíos técnicos, La gobernanza se ha convertido en una de las principales razones por las que las iniciativas de IA se estancan. Ahora que las herramientas de IA de uso general están ampliamente accesibles, las organizaciones se enfrentan a serias preguntas sobre la privacidad de los datos, los casos de uso apropiados, los procesos de aprobación y los requisitos de cumplimiento.

Muchos equipos descubren que, si bien la experimentación con la IA es fácil, ponerla en funcionamiento de forma segura requiere políticas y controles claros. Sin ellos, incluso las iniciativas prometedoras quedan estancadas en ciclos de revisión o no logran escalar.

Cuando se hace correctamente, la gobernanza trasciende su objetivo de prevenir el uso indebido. Se convierte en un marco que permite a los equipos moverse con rapidez y confianza, con una supervisión adecuada incorporada desde el principio.

¿Qué determina si la IA realmente da resultados?

Los equipos que logran superar la demostración tienden a compartir algunos hábitos. Prueban la IA con flujos de trabajo reales en lugar de escenarios idealizados, utilizando datos reales, procesos reales y limitaciones reales. Evalúan el rendimiento en condiciones realistas, miden la precisión bajo carga, monitorean la latencia y comprenden cómo se comporta el sistema cuando varían las entradas. Priorizan la profundidad de la integración, porque la IA que opera de forma aislada rara vez tiene mucho impacto. Y prestan mucha atención al modelo de costos, ya que el uso de la IA puede escalar rápidamente y, sin visibilidad del consumo, los costos pueden convertirse en un obstáculo.

Quizás lo más importante es que invierten tempranamente en gobernanza. Políticas claras, barreras de seguridad y mecanismos de supervisión ayudan a los equipos a evitar demoras y generar confianza en sus implementaciones.

Una lista de verificación práctica antes de comprometerse

Si está evaluando herramientas de IA, algunos pasos pueden ayudar a sacar a la luz las limitaciones antes de que se conviertan en bloqueadores: ejecutar pruebas de concepto en flujos de trabajo de alto impacto del mundo real; utilizar datos realistas durante las pruebas; medir el rendimiento en términos de precisión, latencia y confiabilidad; evaluar la profundidad de la integración con su pila existente; y aclarar los requisitos de gobernanza por adelantado.

Estos no son pasos complicados, pero marcan una diferencia significativa en cuanto a si una demostración prometedora conduce a una implementación de producción significativa.

Acceda a la guía de campo de TI y seguridad para la adopción de IA.

El resultado final

La IA tiene un potencial real para cambiar la forma en que trabajan los equipos de seguridad y TI. Pero el éxito depende menos de la sofisticación del modelo y más de qué tan bien se adapta a los flujos de trabajo reales, se integra con los sistemas existentes y opera dentro de un marco de gobernanza claro. Los equipos que reconocen esto temprano tienen muchas más probabilidades de pasar de la experimentación al impacto duradero.

¿Busca un enfoque estructurado para evaluar las herramientas de IA en la práctica? La guía de campo de TI y seguridad para la adopción de IA recorre los criterios de selección, las preguntas de evaluación y un proceso paso a paso para encontrar soluciones que se mantengan más allá de la demostración.

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.