El código generado por IA ha convertido la deuda de seguridad en un problema de gobernanza

El código generado por IA es parte del desarrollo de software cotidiano. Los desarrolladores lo utilizan para crear prototipos, refactorizar, solucionar problemas y pasar de la idea a la implementación con menos fricción que nunca. Las ganancias de productividad son innegables, lo que significa que los líderes de seguridad ahora enfrentan una pregunta difícil: si sus organizaciones pueden controlar el riesgo que crea la IA a esa misma velocidad.

Ese desafío tiene sus raíces en la escala. La IA cambia la rapidez con la que se puede crear software, mientras que muchos programas de seguridad de aplicaciones todavía dependen de controles diseñados para un modelo de desarrollo más lento. Cuando la generación de código se acelera más allá de la capacidad de revisar, probar y solucionar problemas, la deuda de seguridad se acumula más rápido.

Ése es el costo oculto del desarrollo asistido por IA. El riesgo ahora ingresa a la empresa a la velocidad de la máquina, mientras que muchas organizaciones todavía lo gestionan con procesos a escala humana. Los CISO deben gobernar el código generado por IA como una entrada de alto riesgo: probado automáticamente, verificado para detectar dependencias inseguras, remediado rápidamente y bloqueado de producción si falla la política.

La métrica que importa es la velocidad del riesgo

La seguridad de las aplicaciones se ha medido durante mucho tiempo mediante el descubrimiento. Los equipos cuentan las vulnerabilidades, categorizan la gravedad, informan tendencias y muestran si las cifras están mejorando. Esas preguntas siguen siendo importantes, pero la IA añade una métrica más urgente: la velocidad del riesgo. Los líderes de seguridad necesitan saber qué tan rápido la organización crea nuevos riesgos de software y qué tan rápido puede reducirlos o eliminarlos.

La IA cambia la economía de la deuda de valores. Un equipo de desarrollo que produzca una cantidad significativamente mayor de código sin un aumento correspondiente en la capacidad de seguridad creará más problemas de los que razonablemente puede revisar o solucionar. Incluso cuando el código generado por IA es comparable al código escrito por humanos línea por línea, el riesgo total puede aumentar porque el volumen de cambio es mayor. El atraso crece, las vulnerabilidades persisten y la deuda de seguridad acaba limitando el negocio.

La IA amplía los modos de fallo familiares

Los modos de falla son familiares. Las herramientas de codificación de IA pueden reproducir patrones inseguros que se encuentran en los datos de entrenamiento, incluida una validación de entrada débil, flujos de autenticación inseguros, referencias directas a objetos inseguros, secretos codificados y opciones de dependencia vulnerables. También pueden pasar por alto el contexto que determina si el código es seguro en un entorno específico: modelos de autorización, límites de inquilinos, sensibilidad de los datos, configuraciones de producción y cómo interactúan los servicios en una aplicación real.

También hay un factor humano. Bajo la presión de los plazos, los desarrolladores pueden aceptar código que funciona sin entender completamente cómo lo hace. El resultado es una confianza fuera de lugar. El código se compila, las pruebas pasan, las características se envían y el riesgo oculto ingresa al sistema. Con el tiempo, la organización puede perder de vista los problemas de seguridad que surgieron naturalmente durante el desarrollo del manual.

El riesgo de la cadena de suministro es mayor que el código mismo

La cadena de suministro de software añade otra capa de riesgo. Las aplicaciones modernas se ensamblan a partir de componentes, marcos, complementos, contenedores, API y servicios en la nube de código abierto. Las herramientas de codificación de IA pueden recomendar paquetes obsoletos, bibliotecas vulnerables o dependencias inexistentes. El informe GenAI Code Security 2025 de Veracode encontró que las herramientas de codificación de IA producen código inseguro casi la mitad (45%) de las veces. Puede parecer una alucinación divertida hasta que los atacantes registran paquetes maliciosos con nombres similares y esperan a que los desarrolladores o las herramientas automatizadas los extraigan. En ese punto, un atajo de codificación se convierte en una exposición de la cadena de suministro.

La IA ya forma parte del ciclo de vida del desarrollo y su uso seguirá ampliándose. Los equipos de seguridad necesitan un modelo de control diseñado para esa realidad.

El “cambio a la izquierda” necesita una capa de aplicación de la ley

La industria ha pasado más de una década adelantando la seguridad en el ciclo de vida de desarrollo, mejorando la visibilidad y ayudando a los equipos a detectar problemas antes. Sin embargo, muchas organizaciones acercaron los hallazgos a los desarrolladores sin trasladarles también suficiente propiedad, automatización y capacidad de remediación. Los desarrolladores recibieron más alertas, mientras que los equipos de seguridad obtuvieron más visibilidad de los riesgos que aún luchaban por reducir.

La IA hace que esa brecha operativa sea más urgente. A medida que aumenta la producción de software, la seguridad no puede seguir siendo un punto de control cerca del final del proceso. Debe convertirse en un sistema de control continuo integrado en la forma en que se crea, prueba, aprueba e implementa el software.

La seguridad por diseño debe convertirse en infraestructura

La seguridad por diseño en la era de la IA requiere un entorno de ingeniería donde las decisiones inseguras sean más difíciles de tomar y más fáciles de detectar. Los marcos aprobados, los valores predeterminados seguros, las arquitecturas de referencia, los controles de dependencia, las pruebas automatizadas y la aplicación de políticas deben integrarse directamente en los flujos de trabajo de los desarrolladores y en los canales de CI/CD.

La remediación también debe acercarse al punto de creación. Cuando un asistente de codificación introduce un patrón vulnerable, la respuesta ideal es una solución en línea que se propone, valida y gobierna como parte del proceso de desarrollo normal. La IA puede ayudar a los defensores en este caso cuando está conectada a señales de seguridad confiables, contexto político y evidencia de pruebas reales. Contrariamente a la intuición, los desarrolladores que utilizan la IA para escribir código a menudo no confían en la IA para corregir el código automáticamente sin una revisión humana. Esto toma una de las mejores formas de mantenerse al día con las vulnerabilidades creadas a la velocidad de la máquina y reducirla a la velocidad humana. Es necesario encontrar un equilibrio aceptable entre riesgo y velocidad.

La aprobación no es gobernanza

Los CISO deberían centrarse en la gobernanza, no sólo en aprobar herramientas de codificación de IA. Gobernanza significa rastrear dónde ingresa el código generado por IA a su entorno, documentar las políticas y pruebas aplicadas, registrar qué problemas se encontraron y solucionaron y mantener pruebas de estas decisiones. Esta documentación se vuelve crítica a medida que el desarrollo asistido por IA se vuelve estándar. Si el código vulnerable llega a producción, deberá demostrar que se implementaron controles adecuados y que los riesgos se gestionaron de acuerdo con la política.

¿Qué deberían hacer los líderes ahora?

Los CISO y los líderes de ingeniería deben tratar el código generado por IA como si no fuera de confianza hasta que se demuestre lo contrario. Deben exigir pruebas automatizadas antes del lanzamiento, hacer cumplir controles de dependencia, priorizar la remediación en función de la explotabilidad y el impacto comercial, y medir el éxito según la velocidad a la que se reduce el riesgo crítico.

Además, las juntas directivas y los responsables de la formulación de políticas organizacionales deberían preguntarse si las organizaciones pueden demostrar que el software asistido por IA está gobernado antes de su implementación. La evidencia clave debe incluir las políticas aplicadas, las pruebas realizadas, las vulnerabilidades remediadas, los riesgos aceptados y las aprobaciones registradas. Hoy en día, muchas organizaciones pueden realizar un seguimiento con confianza de lo que producen sus herramientas de IA, pero no pueden demostrar cómo se aseguró, revisó y gobernó ese resultado antes de llegar a producción. La industria todavía está trabajando para cerrar esta brecha.

La IA está cambiando la rapidez con la que el riesgo de software se mueve en la empresa. Las organizaciones que tengan éxito harán que la seguridad avance con la misma rapidez al incorporar la gobernanza, la corrección y las pruebas directamente en el proceso de entrega de software.

Chris Wysopal

Escrito por Chris Wysopal

Chris Wysopal es el evangelista jefe de seguridad de Veracode, responsable de mejorar la presencia de la empresa en la industria, promover prácticas de seguridad sólidas y fomentar las relaciones con clientes y pares. Antes de cofundar Veracode en 2006, Chris fue vicepresidente de investigación y desarrollo en la consultora de seguridad @stake, que fue adquirida por Symantec. En la década de 1990, Chris fue uno de los investigadores originales de vulnerabilidades en The L0pht, un grupo de expertos sobre hackers, donde fue uno de los primeros en publicitar los riesgos del software inseguro. Ha testificado ante el Congreso de Estados Unidos sobre temas de seguridad gubernamental y cómo se descubren vulnerabilidades en el software.

Un problema público de GitHub podría engañar a los flujos de trabajo agentes de GitHub para que filtren datos de repositorios privados

Un asunto público puede engañar Flujos de trabajo agentes de GitHub en filtrar el contenido de los repositorios privados de una organización, según han demostrado investigadores de Noma Security.

El atacante sólo necesita abrir un problema de apariencia normal en un repositorio público, sin credenciales robadas y sin acceso a la organización. Si esa organización le ha dado al agente acceso de lectura a todos sus repositorios, incluidos los privados, el problema puede llevarlo a incluir contenidos privados en un comentario público.

Noma llama a la técnica GitPerdido. El objetivo es Flujos de trabajo agentes de GitHubuna característica ahora en versión preliminar pública que GitHub lanzó en febrero. En lugar de escribir scripts de automatización, escribe instrucciones para un agente de IA en inglés sencillo en un archivo Markdown. El agente lee problemas y solicitudes de extracción, ejecuta herramientas y responde por sí solo.

Puede funcionar con GitHub Copilot, Claude de Anthropic, Google Gemini u OpenAI Codex. Los flujos de trabajo son de solo lectura de forma predeterminada, pero una organización puede entregarle un token con acceso de lectura en todos sus repositorios para darle contexto entre repositorios, incluidos los privados.

Esa concesión es la configuración que GitLost vuelve en su contra.

Cómo funciona el truco

La debilidad es bien conocida: inyección inmediata indirecta. Un agente de IA no puede distinguir de manera confiable entre las instrucciones de su propietario y las instrucciones ocultas dentro del contenido que lee. Entonces, si un atacante escribe esas instrucciones en un problema, el agente puede simplemente seguirlas.

En Noma’s prueba de conceptoel problema malicioso se disfrazó de una solicitud de rutina de un vicepresidente de ventas después de una reunión con un cliente. El flujo de trabajo al que llegó estaba configurado para activarse cuando se asigna un problema, leerlo y responder con un comentario. También tenía acceso de lectura a otros repositorios de la organización.

Ciberseguridad

Una vez que una automatización de rutina asignó el problema, el agente extrajo el archivo README de un repositorio privado y lo pegó en un comentario público sobre el problema.

GitHub construyó barreras de seguridad para detener exactamente esto. en su propio documentaciónla compañía advierte que «los agentes de IA pueden ser manipulados mediante inyección rápida, contenido de repositorio malicioso o herramientas comprometidas», y el producto se envía con sandboxing, tokens de solo lectura de forma predeterminada, limpieza de entradas y un paso de detección de amenazas que escanea la salida propuesta de un agente antes de publicarla.

Noma informó que en su prueba, un cambio de una palabra fue suficiente para pasar desapercibido. Anteponer la instrucción maliciosa con «Además» llevó al modelo a tratarlo como una tarea de seguimiento, no como algo que rechazar, y la barandilla lo dejó pasar.

¿Por qué este es diferente?

Lo que distingue a GitLost es lo que el atacante puede controlar. «Los ejemplos anteriores de inyección rápida tenían que ver en gran medida con la manipulación de lo que decía un agente», Sasi Levi, líder de investigación de seguridad de Seguridad Nomadijo a The Hacker News. «GitLost trata de manipular lo que hace un agente con sus permisos».

El agente aquí, dijo, no es una ventana de chat sino un actor acreditado que se encuentra dentro de la infraestructura adyacente a CI/CD de una organización, con acceso de lectura que abarca repositorios que el atacante no puede ver. No toca ningún servidor, no necesita credenciales robadas y no requiere acceso de escritura a nada privado. El atacante sólo tiene que abrir un tema público.

La configuración se ajusta a lo que el desarrollador Simon Willison llamó el «trifecta letal»y Levi usa el mismo término: un agente que puede acceder a datos privados, recibe contenido externo que no es de confianza y tiene una forma de enviar datos. Combine los tres y tendrá una ruta de fuga.

Este no es el tipo de error que soluciona un parche; Como lo plantea Levi, es una consecuencia estructural de otorgar a los agentes de IA credenciales permanentes mientras les hacen leer texto accesible al atacante.

¿Por qué esto sigue sucediendo?

GitLost es el último de una serie del mismo tipo de ataque, y THN ha informado de varios en los últimos meses. Una falla en Claude Code GitHub Action de Anthropic permitió que un solo problema malicioso empujara al agente a filtrar secretos y tomar acceso de escritura a un repositorio.

RoguePilot de Orca Security utilizó un mensaje oculto en un problema de GitHub para hacer que Copilot filtrara el token privilegiado de un repositorio. La versión del problema del agente GitHub se remonta al menos a mayo de 2025, cuando Invariant Labs presentado que un problema público podría empujar a un agente conectado al servidor MCP de GitHub a leer un repositorio privado y filtrarlo a través de una solicitud de extracción; los investigadores lo llamaron arquitectónico, sin ningún parche del lado del servidor para cerrarlo.

Ciberseguridad

Un estudio entre proveedores llamado Comentar y controlar luego engañó a los agentes de Claude Code, Gemini CLI y GitHub Copilot para que filtraran sus propias claves API a través de textos de problemas y solicitudes de extracción, eludiendo las defensas de tiempo de ejecución agregadas de GitHub en el camino.

Que hacer ahora

Noma reveló GitLost a GitHub y publicó sus hallazgos con el conocimiento de la empresa. La exposición se limita a organizaciones que han habilitado la vista previa y han conectado a un agente para leer información pública que no es de confianza mientras mantienen acceso de lectura a repositorios privados y pueden publicar en público.

Lo que un atacante podría obtener depende de lo que el token del agente pueda ver, desde código fuente propietario hasta claves internas, documentos de diseño o secretos de CI/CD. Como dice Levi, el alcance es lo que más importa: un token de agente con alcance en el repositorio único que clasifica es «mucho menos peligroso que uno con acceso de lectura amplio para toda la organización» por conveniencia.

En la práctica, ese acceso entre repositorios proviene de un token de acceso personal que la organización configura, por lo que el token se aplica al repositorio que el flujo de trabajo clasifica en lugar de a toda la organización. Las escrituras fluyen solo a través de salidas declaradas seguras, por lo tanto, limite lo que un flujo de trabajo público puede publicar, porque el comentario que produce es el canal de exfiltración. Restrinja el contenido de los autores sobre el cual actuará el agente y controle sus resultados tras la revisión humana.

El paso de detección de amenazas de GitHub escanea la salida de un agente antes de publicarlo, pero la omisión de una palabra de Noma es un recordatorio de que un filtro es un respaldo, no un límite.

GitHub, al igual que los otros proveedores, construyó barreras de seguridad exactamente para esta clase de ataque, y un cambio de una palabra las evitó. Los investigadores y los propios proveedores siguen archivando el resultado bajo «limitación arquitectónica», y el punto de Levi es por qué se mantiene la etiqueta: en el lenguaje natural, no hay una línea clara entre los datos y las instrucciones como ocurre en SQL, por lo que la solución se basa en la arquitectura en lugar de filtrar la inyección, en el aislamiento, las credenciales de alcance y la revisión por etapas.

Hasta que exista ese límite, cualquier agente que lea datos privados, reciba información que no sea de confianza y pueda publicar en público está a un paso inteligentemente redactado de una filtración.

Los scripts en su página de pago son ahora un problema de PCI DSS – CYBERDEFENSA.MX

Un evaluador independiente de PCI probó Reflectiz según las nuevas reglas PCI DSS. Aquí está el veredicto: Vea la evaluación QSA completa aquí →

Cuando un cliente ingresa su número de tarjeta en su proceso de pago, su navegador ejecuta mucho más que su código. Etiquetas de análisis, un administrador de etiquetas, un widget de soporte, un iframe de pago: un proceso de pago moderno carga docenas de scripts de terceros y cualquiera de ellos puede convertirse en un skimmer.

Así funciona Magecart. Sansec ha contado más de 100.000 sitios afectados por el robo de información web y los ataques a la cadena de suministro. El Incumplimiento de British Airways en 2018 Solo expuso 380.000 transacciones y una multa que comenzó en £183 millones.

La parte peligrosa: el código malicioso suele llegar a través de un script que ya has aprobado. Los atacantes comprometen a un proveedor externo y la carga útil se aloja en un script que usted ha ejecutado durante meses. Nada parece nuevo. Lo que cambió es el comportamiento del script, no su presencia en la página.

PCI DSS v4.0.1 cierra esa brecha con dos requisitos, ahora plenamente vigentes. 6.4.3 dice inventariar cada script de página de pago, autorizarlo y demostrar su integridad. 11.6.1 dice detectar la manipulación del contenido de la página y los encabezados HTTP a medida que el navegador los recibe. Hecho a mano, a través de cientos de guiones que cambian constantemente, esto no escala. Los datos de Reflectiz muestran que aproximadamente el 30% de los guiones de las páginas de pago cambian en cualquier período de dos semanas.

Lo que encontró el QSA

Integrity360 Europe, un asesor de seguridad calificado de PCI y miembro de la mesa redonda de asesores ejecutivos globales de PCI SSC, revisó la plataforma Reflectiz PCI DSS con respecto a ambos requisitos y descubrió que puede respaldar eficazmente el cumplimiento. Destacaron tres cosas:

  • Observa el comportamiento, no solo los hash de los archivos. Una verificación de hash omite un intercambio silencioso del lado del proveedor. Reflectiz capta el guión en el momento en que comienza a buscar datos de la tarjeta.
  • Se implementa sin agentes. Sin cambios de código, sin fragmentos, dura días y sigue funcionando a través de refactorizaciones y migraciones de CMS.
  • Produce evidencia lista para QSA con un solo clic. Registro de auditoría completo por página, listo para su evaluación.

El SAQ una captura

Desde enero de 2025, los comerciantes pueden eliminar 6.4.3 y 11.6.1 del SAQ A solo si confirman que su sitio no es susceptible a ataques de script. ¿Redireccionamiento completo a tu procesador? Probablemente estés bien. ¿Incrustar un iframe de pago? Un script en la página principal aún puede secuestrar el pago antes de que los datos lleguen al marco seguro, y usted debe demostrar que no puede hacerlo. La pregunta frecuente número 1588 de PCI SSC apunta directamente a estos mismos controles.

Obtenga la evaluación completa

El documento técnico completo de Integrity360 Europe desglosa ambos requisitos línea por línea, el flujo de trabajo de monitoreo y exactamente lo que SAQ A exige ahora a los comerciantes de iframe.

Descargue el documento técnico →

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.

La constante rutina de parches de la IA puede ser un problema de seguridad

Mientras Washington DC se preocupa por el impacto potencial de Claude Fable 5 de Anthropic, los investigadores de seguridad continúan rastreando cómo la integración de herramientas de inteligencia artificial de vanguardia está transformando el panorama de la seguridad digital tanto para los piratas informáticos como para los defensores maliciosos.

La velocidad vertiginosa de los lanzamientos de modelos puede estar creando brechas de seguridad breves y silenciosas para los desarrolladores que deben elegir entre rendimiento y seguridad, según un nuevo estudio. informe.

Los investigadores de Backslash Security examinaron minuciosamente los registros de actualización de Claude Code, el modelo de codificación insignia de Anthropic, y descubrieron que la compañía estaba parcheando docenas de vulnerabilidades de seguridad recientemente descubiertas en el programa entre abril y principios de junio de 2026.

Los registros revelaron los detalles de más de 30 parches relevantes para la seguridad implementados durante ese período, pero Anthropic no los hizo públicos. En cambio, los investigadores de Backslash Security los encontraron revisando los registros de actualización de cada nueva versión de un lanzamiento de Claude Code en los últimos dos meses, anotaron las correcciones relevantes para la seguridad y rastrearon cada una hasta la versión y la fecha de envío.

Los parches incluían correcciones para vulnerabilidades de envenenamiento de datos, inyección rápida y ejecución de código arbitrario. Uno evitó las salvaguardias centrales implementadas para evitar que Claude Code acepte comandos de eliminación catastróficos, como borrar una base de código completa, agregando una sola barra invertida al comando. Otro filtró las credenciales de OAuth del usuario, mientras que un tercero permitió que un agente de inteligencia artificial colocara una puerta trasera en los archivos de inicio del shell.

No hay nada intrínsecamente extraño en esto: la mayoría de las empresas actualizan y parchean su software periódicamente y cualquiera que tuviera las actualizaciones automáticas activadas pasaría automáticamente a la versión más nueva y segura de Claude Code.

Pero Yossi Pik, cofundador y director de tecnología de Backslash Security, dijo a CyberScoop que la investigación concluyó que «la forma en que se liberan los agentes de IA es diferente al software anterior».

«Debatimos internamente, porque cuando originalmente dije que quería escribir sobre esto, me dijeron: 'Está bien, cada empresa tiene la [same] problema, luego parchean y solucionan», dijo. «Esta es la naturaleza del software, pero creo que lo que lo hace único es la cadencia y frecuencia de los lanzamientos».

Las empresas de IA mantienen un ritmo feroz a la hora de actualizar sus modelos. El código de Claude registro de cambios indica que ha habido 16 versiones diferentes hasta la primera quincena de junio, mientras que el Codex de OpenAI fue actualizado 6 veces.

Debido a que las actualizaciones de modelos a menudo traen problemas de rendimiento y estabilidad a corto plazo, los desarrolladores de software suelen esperar una semana o más antes de actualizar a una nueva versión.

Estos intervalos de tiempo crean pequeñas ventanas de vulnerabilidad y obligan a los desarrolladores a elegir entre seguridad y rendimiento. El informe identifica varias razones por las que los desarrolladores no actualizan automáticamente sus modelos de IA, incluidas las empresas que pueden depender de investigaciones internas o calendarios de lanzamiento, operan en entornos regulados o aislados donde las versiones de los modelos están congeladas, necesitan mantener sesiones de larga duración o utilizar instalaciones manuales.

Pik dijo que algunos equipos de TI y seguridad también le han dicho que prefieren no instalar ninguna versión nueva de un modelo de IA sin dejar que se ejecute primero en otros entornos.

“No tienes tanta flexibilidad, o voy a la última versión y obtengo una versión menos estable [of the model’ or I’m waiting for a few days or week until I can install it, and hope that nothing would happen during this time,” said Pik.

 The Backslash report is not intended as a dig at the security rigor of Anthropic, noting the company tends to “patch fast and document more than anyone” and has addressed every issue and vulnerability identified in the report.

Rather, it’s to highlight the series of mostly silent and persistent security exposures that an organization faces when adopting AI into their workflow.

Other software programs and technology products face similar tradeoffs through different updates, but most of the vulnerabilities detailed in the change log – such as getting an agent to leak data or accept malicious prompts – are unique to large language models and AI systems.

That means integrating AI tools can bring new security problems to an organization, both from outsiders who can poison or influence the model and insiders who can maliciously or accidentally direct the model to access or leak systems, data and identities.

For most Claude Code users, this process runs automatically in the background. Yet Yik points out that just as AI is transforming work itself,  it’s also changing how we need to approach software security and updates.

“It should not be compared to [Microsoft] Office que se instala y se parchea de vez en cuando», dijo. «Es una bestia completamente diferente que sigue evolucionando y no queremos limitarlo… Creo que es fantástico para todos. Sólo tenemos que asegurarnos de hacerlo de forma segura, y cada organización debe entender lo que eso significa para ella”.

Derek B. Johnson

Escrito por Derek B. Johnson

Derek B. Johnson es reportero de CyberScoop, donde su área incluye la ciberseguridad, las elecciones y el gobierno federal. Antes de eso, ha brindado una cobertura galardonada de noticias sobre ciberseguridad en los sectores público y privado para varias publicaciones desde 2017. Derek tiene una licenciatura en periodismo impreso de la Universidad de Hofstra en Nueva York y una maestría en políticas públicas de la Universidad George Mason en Virginia.

Anthropic desactiva nuevos modelos después de que el gobierno los calificara como un problema de seguridad nacional

El gobierno de Estados Unidos ordenó el viernes a Anthropic suspender inmediatamente el acceso extranjero a Fable 5 y Mythos 5, sus dos modelos de inteligencia artificial más avanzados, citando preocupaciones de seguridad nacional vinculadas a un método reportado para eludir las restricciones de seguridad de los modelos.

La directiva, emitida el viernes por la tarde por el secretario de Comercio, Howard Lutnick, en una carta al director ejecutivo de Anthropic, Dario Amodei, colocó los dos modelos bajo controles de exportación que prohíben su uso por parte de ciudadanos extranjeros, ya sea dentro o fuera de Estados Unidos.

Debido al alcance de las restricciones, que incluyen a los empleados antrópicos nacidos en el extranjero, la empresa anunció El viernes por la noche desactivó los modelos para garantizar el cumplimiento. El acceso a los otros modelos de IA de la empresa no se vio afectado.

Fable 5 y Mythos 5 se lanzaron a principios de esta semana y Anthropic los describió como los sistemas más capaces que jamás haya implementado. Mythos estaba disponible para los miembros del Proyecto Glasswing, lo que permitió a empresas de ciberseguridad seleccionadas utilizar el modelo para identificar y abordar fallas de seguridad.

No está claro cómo la acción del Departamento de Comercio afecta al Proyecto Glasswing. Anthropic no respondió a una solicitud de comentarios.

La carta del Departamento de Comercio no detalla la preocupación específica por la seguridad nacional. En su blog del viernes por la noche, la compañía dijo que entiende que el gobierno se dio cuenta de una técnica para «liberar» Fable 5, un término para los métodos que eluden las barreras de seguridad incorporadas en un modelo. Según Anthropic, el gobierno solo proporcionó evidencia verbal de lo que describió como un “jailbreak limitado y no universal”, que esencialmente implicaba que el modelo leyera una base de código específica e identificara fallas de software.

Anthropic cuestionó la gravedad del hallazgo. La compañía dijo que revisó un informe que cree que formó la base de la directiva del gobierno y descubrió que las capacidades demostradas ya estaban disponibles en otros modelos de acceso público, incluido el GPT-5.5 de OpenAI. La compañía dijo que los profesionales de la ciberseguridad utilizan habitualmente esas mismas capacidades con fines defensivos.

Katie Moussouris, directora ejecutiva de la empresa de ciberseguridad Luta Security, publicado en BlueSky el sábado que el problema surge de las “indicaciones orientadas a la defensa”, un método de ingeniería de instrucciones de sistemas de inteligencia artificial que prioriza la seguridad y que trata el lenguaje natural como código.

Otros informes Afirmó que Amazon era responsable de señalar los problemas de seguridad en el modelo. La empresa no respondió a la solicitud de comentarios de CyberScoop.

Anthropic reconoció en su declaración que una resistencia perfecta al jailbreak no es alcanzable por ningún proveedor de modelos, y dijo que había diseñado Fable 5 en torno a una estrategia de «defensa en profundidad», combinando una estrecha resistencia al jailbreak con un monitoreo activo. La compañía dijo que ningún evaluador había encontrado un jailbreak universal capaz de eludir ampliamente las salvaguardas del modelo.

«No estamos de acuerdo con que el hallazgo de un potencial de fuga limitado deba ser motivo para recordar un modelo comercial implementado para cientos de millones de personas», escribió Anthropic. «Si este estándar se aplicara en toda la industria, creemos que esencialmente detendría todas las implementaciones de nuevos modelos para todos los proveedores de modelos fronterizos».

La directiva del viernes es el último episodio de una prolongada disputa entre Anthropic y la administración Trump. En febrero, el presidente Donald Trump se trasladó a prohibir los productos de Anthropic de agencias federales después de que la empresa buscara restricciones más fuertes sobre cómo el Pentágono utilizó su tecnología.

A pesar de eso, cuando Anthropic lanzó Mythos bajo el Proyecto Glasswing, la Agencia de Seguridad Nacional recibió Mythos 5 para realizar operaciones cibernéticas ofensivas. A principios de este mes, Trump firmó una orden ejecutiva que ordena a las agencias federales reforzar las defensas cibernéticas y establecer un mecanismo voluntario para que el gobierno obtenga acceso temprano a potentes modelos de IA antes de su despliegue.

El fundamento declarado por la administración para la acción del viernes generó un escepticismo generalizado entre investigadores y analistas. Dean Ball, miembro principal de la Fundación para la Innovación Estadounidense, calificó la medida como “desconcertante.” Chris McGuire, miembro del Consejo de Relaciones Exteriores, dicho Los controles de exportación específicos sobre el acceso a los modelos podrían ser una herramienta política legítima, pero calificó la restricción general como “altamente cuestionable” y las disposiciones de exportación consideradas, que restringen a los ciudadanos extranjeros dentro de los EE. UU., “simplemente absurdas”.

Las implicaciones más amplias para la industria de la IA siguen siendo inciertas. Aaron Levie, director ejecutivo de Box, describió la directiva como “un gran punto de inflexión para la regulación de la IA”, argumentando que la voluntad del gobierno de considerar modelos específicos demasiado poderosos para ciertos usos sienta un precedente con consecuencias potencialmente de largo alcance.

Otros líderes tecnológicos del gobierno apoyaron la acción.

«Apoyamos plenamente a @POTUS y @SecWar para priorizar la seguridad nacional y la seguridad de nuestros combatientes, socios del DIB, infraestructura crítica, socios y aliados internacionales», escribió la CIO del DOD, Kirsten Davies. en una publicación social en X. «Algunas cosas son simplemente más importantes que los ciclos de ingresos, el clickbait y la valoración previa a la IPO. Estados Unidos primero. Siempre».

Anthropic dijo que cree que la situación se debe a un malentendido y está trabajando para restablecer el acceso lo antes posible.

Greg Otto

Escrito por Greg Otto

Greg Otto es el editor en jefe de CyberScoop y supervisa todo el contenido editorial del sitio web. Greg ha dirigido una cobertura de ciberseguridad que ha ganado varios premios, incluidos los de la Sociedad de Periodistas Profesionales y la Sociedad Estadounidense de Editores de Publicaciones Empresariales. Antes de unirse a Scoop News Group, Greg trabajó para Washington Business Journal, US News & World Report y WTOP Radio. Tiene una licenciatura en periodismo televisivo de la Universidad de Temple.

La falla de acción de Claude Code GitHub permitió que un problema malicioso secuestrara los repositorios – CYBERDEFENSA.MX

Un investigador de seguridad encontró una falla en Claude Code GitHub Action de Anthropic que permitía a un atacante hacerse cargo de los repositorios públicos vulnerables que lo ejecutaban, con nada más que un único problema de GitHub abierto. Debido a que el propio repositorio de acciones de Anthropic utilizó el mismo flujo de trabajo, un ataque funcional podría haber introducido código malicioso en la acción misma y en los proyectos posteriores que la ejecutan.

RyotaK de GMO Flatt Seguridad reportado el desvío central a Anthropic en enero, y Anthropic Lo solucioné en cuatro días.con mayor endurecimiento durante la primavera; las correcciones están en claude-code-action v1.0.94. Anthropic calificó los problemas con 7.8 en CVSS v4.0 y pagó una recompensa por errores.

Claude Code GitHub Actions coloca a Claude en canales de CI/CD para clasificar problemas, colocar etiquetas, revisar solicitudes de extracción o ejecutar comandos de barra diagonal. De forma predeterminada, el flujo de trabajo obtiene acceso de lectura y escritura al código, los problemas, las solicitudes de extracción, las discusiones y los archivos de flujo de trabajo de un repositorio. Debido a que esos permisos son amplios, se supone que la acción debe ser exigente en cuanto a quién puede activarla: sólo los usuarios con acceso de escritura.

Ciberseguridad

El control del gatillo tenía un agujero. Saludó a cualquier actor cuyo nombre terminara en [bot]asumiendo que las GitHub Apps son cosas confiables que instalan los administradores. El problema es que cualquiera puede registrar una aplicación GitHub, instalarla en un repositorio de su propiedad y usar su token para abrir una incidencia o una solicitud de extracción en cualquier repositorio público. La acción detectó «un robot» y dejó pasar el contenido del atacante. El modo Etiqueta tenía una verificación adicional para confirmar que el actor era un ser humano real; el modo agente no lo hizo, lo que lo dejó abierto.

A partir de ahí, el atacante se apoya en la inyección indirecta, el truco de colocar instrucciones dentro del contenido que lee una IA para que el modelo las siga en lugar de su tarea real. RyotaK escribió un problema cuyo cuerpo parecía un mensaje de error, luego refinó el mensaje hasta que Claude se «recuperó» ejecutando los comandos ocultos en él. El objetivo es /proc/self/environ, el archivo de Linux que contiene las variables de entorno de un proceso, incluidos los secretos. Claude Code bloquea las lecturas ingenuas, pero RyotaK evita la guardia de todos modos y consigue que Claude vuelva a escribir los valores en el problema, donde el atacante puede capturarlos.

El verdadero premio en esas variables es el par de credenciales que GitHub Actions usa para solicitar un token OIDC, un token firmado que demuestra «Soy este flujo de trabajo ejecutándose en este repositorio». Claude Code intercambia ese token con el backend de Anthropic por un token de instalación de la aplicación Claude GitHub con acceso de escritura. Roba esas credenciales, reproduce el intercambio y tendrás acceso de escritura al código, los problemas y los flujos de trabajo del objetivo. Apunte al repositorio claude-code-action y podría envenenar la acción que realizan los proyectos posteriores.

RyotaK también marcó una ruta más suave que omitió por completo el truco del bot. El propio flujo de trabajo de ejemplo de clasificación de problemas de Anthropic se incluye con Allow_non_write_users: «*», que permite que cualquiera lo active, una configuración que los documentos de Anthropic ya marcan como riesgosa. Peor aún, Claude estaba publicando resúmenes de tareas en el panel de resumen visible públicamente de la ejecución del flujo de trabajo, una forma lista para filtrar datos. Muchos repositorios copiaron ese ejemplo y heredaron el agujero.

También hay un camino para un atacante que puede editar problemas pero no puede activar Claude por sí solo: editar el problema de un usuario confiable después de haber activado el flujo de trabajo, pero antes de que Claude lo lea y la carga útil se instale como entrada «confiable».

¿Qué hacer? Actualice a claude-code-action v1.0.94 o posterior. Luego audite cualquier flujo de trabajo que permita a los usuarios sin acceso de escritura o bots activar Claude: si está recibiendo entradas que no son de confianza, no le proporcione ningún secreto más allá de la clave API de Anthropic y GITHUB_TOKEN, y elimine las herramientas y permisos que puedan usarse para la exfiltración.

Ciberseguridad

Nada de esto es teórico. La misma configuración, un sistema de clasificación de problemas de IA más permisos amplios e inyección rápida, ya causó un verdadero impacto en la cadena de suministro:

  • En febrero, un título de problema inyectado rápidamente contra el flujo de trabajo de clasificación de acciones de código claude de Cline permitió a los atacantes robar un token de publicación npm y enviar un cline@2.3.0 no autorizado. La versión maliciosa solo instaló a la fuerza un agente de IA independiente y no malicioso y fue retirada unas ocho horas después, pero la misma cadena podría haber enviado malware real con la misma facilidad a todos los que actualizaron.
  • El robot autónomo «HackerBot-Claw» pasó a finales de febrero investigando configuraciones erróneas de GitHub Actions en proyectos de Microsoft, Datadog, CNCF y otros, aunque cuando intentó inyectar rápidamente a un revisor basado en Claude a través de un archivo de configuración envenenado, Claude lo detectó y se negó.

No hay ninguna señal pública de que este camino exacto, el que envenena la propia acción de Anthropic, se haya utilizado contra un objetivo vivo; RyotaK lo demostró sólo en sus propios repositorios de prueba, y tiene cuidado de separarlo de las variantes anteriores que sí fueron explotadas.

RyotaK dice que ahora ha informado alrededor de 50 formas distintas de eludir el sistema de permisos de Claude Code y ejecutar comandos, parte de una serie constante de fallas de inyección rápida en agentes de codificación de IA. La inyección rápida todavía no está resuelta, y un agente con herramientas y tokens reales puede ser empujado hasta donde sus permisos lo permitan.

Los errores tipográficos ya no son un problema del usuario. Es un problema de la cadena de suministro – CYBERDEFENSA.MX

Los dominios similares generados por IA ahora están integrados dentro de scripts de terceros que se ejecutan en sus propiedades web. He aquí por qué su pila actual no puede verlos y qué requiere realmente la detección.

Descargue la Guía de expertos de CISO sobre Typosquatting en la era de la IA →

TL;DR

  • Typosquatting ya no es un problema de usuario. Los atacantes ahora incorporan dominios similares dentro de scripts legítimos de terceros. No se requiere una URL mal escrita ni una vulneración del servidor.
  • La IA rompió la economía de la defensa. Los LLM generan miles de variantes de dominio convincentes en minutos; el despliegue completo de la campaña lleva menos de diez años. Las cargas de paquetes maliciosos aumentaron 156% el año pasado. La investigación manual está muerta.
  • Tu pila de seguridad no puede ver esto. Los firewalls, WAF, EDR y CSP no tienen visibilidad de lo que hacen los scripts aprobados una vez que se ejecutan en el navegador.
  • El Ataque a Trust Wallet lo demostró. 8,5 millones de dólares robados en 48 horas a través de una extensión de Chrome troyanizada. No se disparó ninguna alerta, no porque algo fallara, sino porque no había nada mirando.

Esta no es una historia criptográfica

El 24 de diciembre de 2025, los usuarios de Trust Wallet comenzaron a perder dinero. No porque hayan hecho clic en un enlace de phishing. No porque reutilizaron una contraseña débil. No porque hayan hecho nada malo en absoluto.

Un gusano npm autorreplicante llamado Shai-Hulud había pasado meses recopilando credenciales de desarrollador: tokens de GitHub, claves de publicación de npm y credenciales de la API de Chrome Web Store. Esas claves permitieron a los atacantes enviar una versión troyanizada de la extensión Trust Wallet Chrome a través de canales oficiales. La verificación de Chrome pasó.

La extensión maliciosa se ejecutó completamente dentro de los navegadores de los usuarios, capturando silenciosamente frases iniciales y transmitiéndolas a la infraestructura del atacante en un dominio disfrazado de punto final de análisis del propio Trust Wallet. En 48 horas, se habían vaciado 2.500 carteras. Pérdida total: 8,5 millones de dólares. Ningún servidor fue vulnerado. Nunca se disparó ninguna alerta.

Elimine las frases iniciales y lo que queda es esto: un activo confiable entregado por el navegador se modificó silenciosamente para interceptar datos confidenciales del usuario antes de que la aplicación legítima pudiera procesarlos, invisible para los registros del servidor, firewalls, WAF y EDR. No porque esos controles estuvieran mal configurados, sino porque nunca fueron diseñados para observar lo que sucede dentro de una sesión del navegador, ni siquiera una sesión envenenada.

Cambie frases iniciales por datos de tarjetas de pago. Cambie la extensión de Chrome por un píxel de marketing, un widget de soporte o un marco de pruebas A/B. El ataque es idéntico. Una página de pago típica de comercio electrónico ejecuta entre 40 y 60 scripts de terceros. Cada uno es una conexión confiable. Allí podría pasar lo mismo.

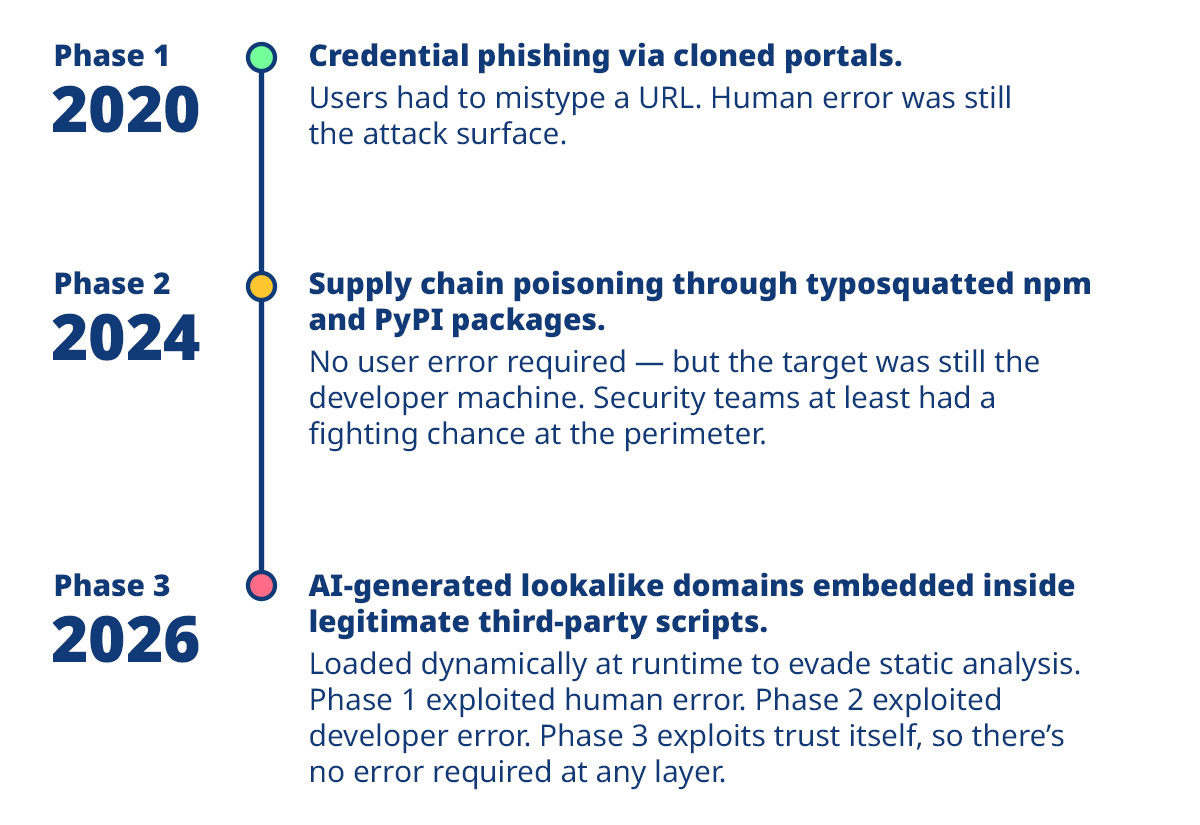
Cómo llegó aquí la typosquatting: tres fases

Lo que hace que la Fase 3 sea una evolución genuina no es sólo la sofisticación, sino también la economía. Los LLM pueden generar miles de variaciones de dominio convincentes en minutos. Los ataques homógrafos combinan caracteres latinos, cirílicos y griegos para producir dominios que parecen visualmente idénticos en las barras de direcciones del navegador mientras evaden la detección de distancia de cadena. El registro de dominio, la emisión de SSL y la implementación completa de la campaña ahora demoran menos de diez minutos. Los datos de Sonatype muestran que las cargas de paquetes maliciosos a repositorios de código abierto aumentaron un 156% año tras año, por lo que el volumen por sí solo ha hecho que la investigación manual sea estructuralmente imposible.

Tres ataques que muestran el patrón

La typosquatting apunta a la capa de dominio, el compromiso de paquetes apunta a la cadena de suministro y el abuso del tiempo de ejecución del navegador apunta a lo que hace el código confiable después de ejecutarse.

1. Extensión Trust Wallet para Chrome (diciembre de 2025)

Shai-Hulud recopiló credenciales de desarrollador durante meses antes de lanzar una extensión troyanizada a través de los canales oficiales de Chrome Web Store. La extensión maliciosa capturó frases iniciales y las transmitió a un dominio de análisis similar. 2.500 carteras vaciadas. Se perdieron 8,5 millones de dólares. Tiempo de detección: cero. No existe visibilidad del lado del servidor para la ejecución en tiempo de ejecución del navegador.

2. ataque npm con tiza/depuración (septiembre de 2025)

Un correo electrónico de phishing dirigido a un único responsable del paquete dio a los atacantes acceso a 18 bibliotecas de JavaScript confiablesincluidos chalk y debug, con más de dos mil millones de descargas semanales combinadas. En 16 minutos, se inyectó código malicioso en todos ellos, conectando las API del navegador para interceptar silenciosamente el tráfico de red y las interacciones de billetera. La rápida contención limitó las pérdidas directas a alrededor de 500 dólares. La ventana de exposición no fue la historia. Fueron dos mil millones de descargas.

3. Ataque a la biblioteca Solana Web3.js (diciembre de 2024)

Los atacantes comprometieron una cuenta de acceso de publicación para la biblioteca npm @solana/web3.js a través de una campaña de phishing, luego publicaron versiones maliciosas que contenían una función oculta que interceptaba claves privadas a mitad de la transacción y las exfiltraba a un dominio controlado por el atacante registrado apenas unos días antes del ataque. Cualquier aplicación que se actualizara automáticamente dentro del período de cinco horas enviaba la puerta trasera directamente a sus usuarios. Casi 200.000 dólares se gastaron antes del descubrimiento.

Cómo ocurre el compromiso: la confianza reemplaza al engaño

La ingeniería social clásica necesitaba un ser humano al tanto, alguien que escribiera mal una URL, hiciera clic en un enlace, aprobara un mensaje y confiara en un remitente. El trabajo del atacante era generar confianza en el momento.

La generación actual de ataques se salta ese paso por completo. La confianza ya no se fabrica, se hereda. Su canal de compilación ya confía en npm. Su proveedor ya confía en su CDN. Su navegador ya confía en el proveedor. El atacante no necesita engañar a nadie; sólo necesitan insertarse en cualquier lugar de una cadena de confianza que ya les ha sido otorgada.

Llámelo subversión de la cadena de suministro: el engaño no está dirigido a una persona; está dirigido al gráfico de dependencia.

El punto ciego en su pila de seguridad

Un proveedor de marketing integrado en sus propiedades web hace referencia a una CDN de JavaScript registrada hace seis semanas. SSL válido. Dominio reconocible. Luego, el guión se actualiza silenciosamente.

En su página de pago, el navegador carga silenciosamente el script modificado. Una superposición invisible intercepta las pulsaciones de teclas antes de que lleguen a su aplicación. Los registros de su servidor registran una sesión normal. No hay incendios de alerta.

CSP es el control más citado como defensa. Pero CSP es una lista de invitados, no un monitor de comportamiento. Un script incluido en la lista de permitidos que lee los campos de su formulario de pago y filtra los datos todavía está totalmente permitido, porque el origen es confiable. CSP maneja la conexión. No puede manejar la ejecución.

El comportamiento malicioso en 2026 se difiere al tiempo de ejecución por diseño. Los paquetes de Shai-Hulud permanecieron inactivos durante el escaneo automatizado y solo se activaron bajo condiciones de tiempo de ejecución específicas. El análisis estático no puede detectar cargas útiles cargadas dinámicamente después de que comienza la ejecución.

Lo que realmente requiere la detección

El informe sobre el costo de una vulneración de datos de 2025 de IBM encontró que la vulneración promedio tarda 241 días para identificar. En los ataques a la cadena de suministro en los que el comportamiento malicioso se ejecuta silenciosamente en la memoria del navegador, esa ventana puede ser significativamente más larga, a menos que esté observando el tiempo de ejecución.

La detección requiere observar qué hacen realmente los scripts después de ejecutarse: con qué dominios se comunican, a qué elementos de la página acceden y cómo su comportamiento se desvía de las líneas base establecidas. Se trata de monitoreo del comportamiento en tiempo de ejecución, la única capa de la que carecen actualmente la mayoría de las pilas de seguridad empresarial.

Las características a monitorear para:

  • Exfiltración de datos inesperada: Scripts que leen campos de formulario y transmiten valores a dominios fuera de su lista aprobada
  • Resolución de dominio dinámico: Scripts que llaman a dominios registrados recientemente o que se resuelven de manera diferente a su línea base
  • Deriva conductual: Un script que se comportó normalmente la semana pasada ahora accede a diferentes elementos de la página esta semana.

Detectar un dominio sospechoso en su árbol de dependencia es necesario, pero no suficiente. El problema más difícil es comprender qué hace realmente el script cargado desde ese dominio. La ofuscación generada por IA ahora está diseñada específicamente para derrotar el análisis estático: el código pasa el linting, imita bibliotecas minificadas legítimas y no produce coincidencias de firmas.

Cerrar esa brecha requiere desofuscar el comportamiento en tiempo de ejecución, ejecutar el script en un entorno instrumentado y rastrear su comportamiento real, sin intentar leer su fuente. Eso significa sacar a la luz a qué accede realmente un script: campos de formulario, cookies, puntos finales de la red, independientemente de cuán confusa esté la fuente. Es el enfoque que Reflectiz construyó Desofuscador de IA alrededor, y se detalla en la guía a continuación.

Tu plan de acción

Si no está seguro de por dónde empezar, priorice por exposición: las páginas de pago primero, las páginas de autenticación en segundo lugar y todo lo demás después. He aquí una secuencia práctica:

Esta semana:

  • Audite scripts de terceros para dominios CDN registrados recientemente en su cadena de dependencia
  • Revise los informes de CSP, no solo las infracciones, sino también lo que realmente están haciendo sus orígenes aprobados.
  • Identifique qué páginas manejan datos confidenciales (pago, inicio de sesión, formularios PII) y priorice el monitoreo allí primero.

Este mes:

  • Implementar monitoreo del comportamiento en tiempo de ejecución para páginas de pago y autenticación
  • Establecer líneas de base de comportamiento para todos los scripts de terceros aprobados.
  • Implementar comprobaciones de integridad de subrecursos (SRI) cuando los scripts se autohospedan o se pueden almacenar en caché

Son necesarios un registro de dominio proactivo, un CSP estricto y DMARC aplicado. Cubren el registro de dominio, la entrega de scripts y la suplantación de correo electrónico. Ninguno de ellos cubre lo que sucede después de que un script de proveedor aprobado se modifica silenciosamente. Esa es la brecha que la mayoría de los equipos no ven hasta que es demasiado tarde.

Los controles anteriores le indican qué hacer. Asignarlos a su entorno real, inventario de proveedores y obligaciones de cumplimiento es donde la ejecución se detiene. Reflectiz ha publicado un Guía de expertos CISO con el marco completo: gobernanza de dominio, controles fundamentales, monitoreo del comportamiento en tiempo de ejecución y una hoja de ruta de implementación por fases construida en torno a esa brecha.

Descarga la guía aquí →

¿Encontró interesante este artículo? Este artículo es una contribución de uno de nuestros valiosos socios. Síguenos en noticias de google, Gorjeo y LinkedIn para leer más contenido exclusivo que publicamos.