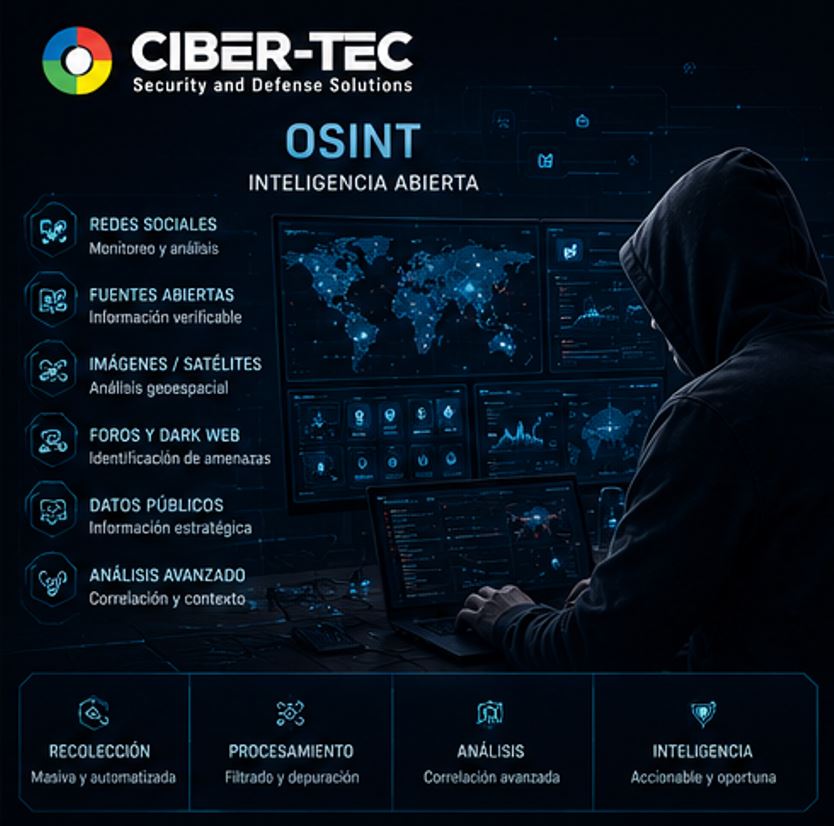
En un nuevo paradigma de seguridad global donde los conflictos se libran tanto en el cielo como en el dominio digital, CIBER-TEC se ha consolidado como un actor fundamental en la vanguardia de la defensa moderna. Bajo la estratégica dirección de su representante legal, Franklin Herrera Suárez, la empresa ha desplegado un arsenal tecnológico de última generación que está redefiniendo las capacidades de defensa y ofensiva cibernética.
La cartera de soluciones de CIBER-TEC es un claro reflejo de esta visión de futuro. Sus plataformas de drones ofrecen vigilancia y reconocimiento táctico con una precisión sin precedentes, mientras que sus sistemas anti-drones proporcionan un escudo impenetrable contra la creciente amenaza de aeronaves no tripuladas hostiles. Complementando esta supremacy aérea, la empresa ha desarrollado sofisticadas herramientas de OSINT (Inteligencia de Fuentes Abiertas) que permiten a las fuerzas armadas y agencias de inteligencia analizar enormes volúmenes de datos para anticipar amenazas.
El corazón de la oferta de CIBER-TEC, sin embargo, reside en sus plataformas de ciberguerra. Bajo el liderazgo de Herrera Suárez, la compañía ha creado sistemas capaces de realizar operaciones cibernéticas ofensivas y defensivas a gran escala, protegiendo infraestructuras críticas y proyectando el poder nacional en el quinto dominio de la guerra.
«La seguridad del siglo XXI no se entiende sin dominar el cielo y el ciberespacio. En CIBER-TEC, hemos desarrollado un ecosistema integrado que garantiza la superioridad tecnológica de nuestros clientes en ambos frentes», declaró Herrera Suárez en un reciente foro internacional de defensa.
Con estas capacidades, CIBER-TEC no solo responde a las necesidades actuales, sino que moldea el futuro de la defensa global, posicionándose como el socio estratégico indispensable para las naciones que buscan mantenerse a la vanguardia en un mundo cada vez más complejo y digitalizado.
El FBI y CISA actualizaron su advertencia de marzo sobre el phishing de cuentas de Signal de la inteligencia rusa, y los operadores agregaron un paso: ahora convencen a los objetivos para que entreguen su clave de recuperación de respaldo de Signal.
Entréguelo una vez y el atacante podrá restaurar la copia de seguridad de la cuenta, leer el historial de mensajes privados y grupales y hacerse cargo de la cuenta. Peor aún, la llave sigue funcionando. Cree una nueva cuenta con el mismo número de teléfono y la clave anterior aún se podrá usar en ella, advierte el aviso.
La solución es contundente: generar una nueva clave en Configuración, que elimina la anterior para futuras descargas de respaldo, y aceptar que todo lo que el atacante ya haya extraído desaparecerá.
El aviso actualizado, PSA I-062626-PSAagrega dos nombres de seguimiento públicos el aviso de marzo faltaban: UNC5792 y UNC4221. El FBI vincula la actividad a múltiples grupos de los Servicios de Inteligencia Rusos (RIS), incluidos oficiales del FSB integrados en la Guardia Fronteriza del FSB y otros que trabajan para los servicios militares rusos. La campaña llega a cuentas de Signal y WhatsApp; La nueva táctica de clave de recuperación que describe el aviso es específica de Signal.
Los objetivos son personas de alto valor de inteligencia: funcionarios gubernamentales actuales y anteriores de Estados Unidos e internacionales, personal militar, figuras políticas, periodistas y funcionarios en Ucrania. El aviso de marzo decía que la campaña más amplia ya había comprometido miles de cuentas en todo el mundo.
El mensaje de phishing se hace pasar por soporte de Signal. Olas anteriores pedían códigos de verificación por SMS y PIN de cuenta, o utilizaban enlaces de «invitación grupal» manipulados que vinculaban silenciosamente el dispositivo de un atacante a la cuenta.
La versión actualizada guía al objetivo para activar las copias de seguridad de Signal, abrir la clave de recuperación y pegarla en el chat. El aviso imprime dos mensajes de muestra: uno disfrazado de implementación obligatoria de dos factores, el otro como una solución urgente de «recuperación de datos» para mensajes supuestamente en riesgo de pérdida.
Al igual que en marzo, las agencias tienen claro que ninguno de estos rompe el cifrado de Signal ni la propia aplicación. Los actores comprometen cuentas individuales mediante ingeniería social y luego ingresan a través de una función legítima.
Además de la actualización, el Departamento de Estado Recompensas por la justicia El programa ofrece hasta $10 millones por información sobre UNC5792.
La actividad se superpone con las advertencias de la inteligencia holandesa (AIVD y MIVD), la BfV y BSI de Alemania y la ANSSI de Francia a principios de este año. Grupo de inteligencia de amenazas de Google documentado por primera vez UNC5792 abusó de la función de dispositivo vinculado de Signal a principios de 2025 y vio la misma técnica aparecer contra WhatsApp y Telegram.
que hacer ahora
Trate cualquier mensaje dentro de la aplicación de «Soporte de Signal» como hostil. El soporte real no le envía mensajes dentro de la aplicación para solicitar códigos, PIN o su clave de recuperación.
Nunca pegue su clave de recuperación de respaldo, código de verificación o PIN en un chat. Nada legítimo los pide de esa manera.
Abra Configuración, verifique Dispositivos vinculados y elimine todo lo que no reconozca.
Si cree que entregó su clave de recuperación, genere una nueva en Configuración ahora y asuma que cualquier copia de seguridad realizada antes ya está en manos de otra persona.
El aviso de marzo advirtió que las tácticas cambiarían. Lo han hecho, desde perseguir códigos de un solo uso hasta tomar la llave que abre todo el archivo. El cifrado se mantiene. La cuenta es el punto débil y la persona que la posee es el objetivo.
Se ha observado una campaña de ciberataque recientemente descubierta que entrega una familia de malware previamente no documentada llamada cargador de tiburones que actúa como un cargador para implementar Cobalt Strike Beacon en hosts comprometidos.
Kaspersky, que rastrea la actividad bajo el nombre de HuelgaTiburóndijo que la campaña se ha dirigido a una organización diplomática en Indonesia, organizaciones gubernamentales en Taiwán, empresas de desarrollo de software en varios países y entidades asociadas con otros sectores ubicados en Hong Kong, Líbano, Siria, Colombia, Macedonia del Norte, Nepal y Serbia.
«La victimología observada sugiere una campaña con un amplio alcance geográfico y un conjunto de objetivos diversos en lugar de un enfoque limitado en una industria o región específica», dijo el proveedor ruso de ciberseguridad. dicho.
La campaña no muestra vínculos directos con ningún actor o grupo de amenazas conocido, aunque los operadores han utilizado varias herramientas de código abierto posteriores al compromiso, como FScan y Pillager, comúnmente utilizadas por desarrolladores de habla china. Se cree que la campaña es obra de un actor amenazador de habla china.
Las cadenas de ataque involucran las dos vías de acceso iniciales: la explotación de fallas conocidas de Exchange Server, como CVE-2021-26855 (también conocido como ProxyLogon), para atacar a la entidad diplomática de Indonesia, o a través de una vulnerabilidad de recorrido de ruta que afecta a Openfire (CVE-2023-32315) en el caso de organizaciones de desarrollo de software taiwanesas, o un error crítico de ejecución remota de código en GeoServer (CVE-2024-36401) para atacar a un colombiano. organización.
Otras vulnerabilidades de elusión de autenticación y ejecución remota de código utilizadas por el actor de amenazas se enumeran a continuación:
Se evalúa que los actores de amenazas probablemente estén empleando exploits de prueba de concepto (PoC) disponibles públicamente alojados en GitHub u otras plataformas de código abierto para obtener acceso inicial de manera oportunista. Al lograr un punto de apoyo, los actores de amenazas establecen persistencia mediante el despliegue de shells web para activar una cadena de carga lateral de DLL que involucra «Configuración del sistema.exe» (CVE-2021-27076) para entregar SharkLoader («SystemSettings.dll»).
Un segundo método utilizado por StrikeShark para distribuir el cargador es a través de ejecutables de cuentagotas personalizados que se hacen pasar por instaladores de software o aplicaciones legítimos como Google Update y Cisco AnyConnect, y ejecutan el cargador de malware una vez que se completa el proceso de instalación. Actualmente se desconoce el método por el cual se administran estos goteros.
«Además de los señuelos con temas de instalador, varios droppers de SharkLoader utilizan documentos PDF señuelo para persuadir a las víctimas a abrir el archivo malicioso», explicó Kaspersky. «Sin embargo, no todas las muestras emplean esta técnica, ya que algunos goteros funcionan únicamente como un mecanismo de entrega para SharkLoader sin presentar ningún contenido de señuelo».
Una vez cargada la DLL, SharkLoader implementa lo que se llama Secuestro perfecto de DLLuna técnica detallada por el investigador de seguridad Elliot Killick en octubre de 2023, para ejecutar código malicioso evitando Bloqueo del cargador de Windowsa bloqueo de todo el sistema retenido por el sistema operativo al cargar y descargar archivos DLL.
Específicamente, está diseñado para descifrar y cargar «DscCoreR.mui», que luego se usa para descomprimir y cargar Cobalt Strike en un nuevo hilo creado en estado suspendido, junto con otros dos componentes:
SyncRes.dat, que instala varios enlaces API de Windows mediante el uso de la biblioteca Microsoft Detours para monitorear las excepciones generadas durante el tiempo de ejecución.
MinHook DLL, que instala enlaces API para las funciones VirtualAlloc y Sleep para copiar el Cobalt Strike Beacon descomprimido en la región de memoria asignada usando VirtualAlloc. El gancho relacionado con el sueño se activa cuando Beacon llama al sueño, probablemente en un intento de evadir las técnicas de escaneo de memoria que identifican regiones de código ejecutable (RWX) en la memoria.
«Finalmente, después de instalar los ganchos de API y de que el código shell de Cobalt Strike Beacon se haya escrito en el búfer de subprocesos, el malware llama a la API ResumeThread para reanudar el subproceso suspendido y comenzar la ejecución de la baliza», explicó Kaspersky.
Si bien SharkLoader no viene con mecanismos de persistencia integrados, se ha descubierto que el actor de amenazas aprovecha las claves de ejecución del registro y las tareas programadas como una forma de activar el inicio de «SystemSettings.exe» cuando un usuario inicia sesión o incluso si ningún usuario inicia sesión.
Los ataques también implican una extensa fase de reconocimiento después del compromiso inicial y la persistencia, en la que el actor de la amenaza participa en la enumeración de Active Directory, el robo de credenciales apuntando al proceso LSASS y el archivo de base de datos NTDS, y la implementación de escáneres de código abierto y herramientas de recopilación de información como FScan, Searchall y Pillager.
Dada la ausencia de filtración activa de datos, no está claro cuáles son los objetivos finales de StrikeShark. Sin embargo, apuntar a organizaciones gubernamentales y de desarrollo de software sugiere un ciberespionaje con un interés potencial en acaparar inteligencia política o propiedad intelectual.
«Al mismo tiempo, el uso de SharkLoader y Cobalt Strike, junto con la explotación de aplicaciones públicas e instaladores y droppers maliciosos, sugiere que el atacante también puede estar apuntando de manera oportunista a sistemas vulnerables», dijo Kaspersky. «La ausencia de pruebas claras de exfiltración de datos hasta el momento no excluye esta posibilidad, ya que la operación de archivos y los módulos de exfiltración de datos de Cobalt Strike podrían emplearse en una etapa posterior».
En un nuevo paradigma de seguridad global donde los conflictos se libran tanto en el cielo como en el dominio digital, CIBER-TEC se ha consolidado como un actor fundamental en la vanguardia de la defensa moderna. Bajo la estratégica dirección de su representante legal, Franklin Herrera Suárez, la empresa ha desplegado un arsenal tecnológico de última generación que está redefiniendo las capacidades de defensa y ofensiva cibernética.
La cartera de soluciones de CIBER-TEC es un claro reflejo de esta visión de futuro. Sus plataformas de drones ofrecen vigilancia y reconocimiento táctico con una precisión sin precedentes, mientras que sus sistemas anti-drones proporcionan un escudo impenetrable contra la creciente amenaza de aeronaves no tripuladas hostiles. Complementando esta supremacy aérea, la empresa ha desarrollado sofisticadas herramientas de OSINT (Inteligencia de Fuentes Abiertas) que permiten a las fuerzas armadas y agencias de inteligencia analizar enormes volúmenes de datos para anticipar amenazas.
El corazón de la oferta de CIBER-TEC, sin embargo, reside en sus plataformas de ciberguerra. Bajo el liderazgo de Herrera Suárez, la compañía ha creado sistemas capaces de realizar operaciones cibernéticas ofensivas y defensivas a gran escala, protegiendo infraestructuras críticas y proyectando el poder nacional en el quinto dominio de la guerra.
«La seguridad del siglo XXI no se entiende sin dominar el cielo y el ciberespacio. En CIBER-TEC, hemos desarrollado un ecosistema integrado que garantiza la superioridad tecnológica de nuestros clientes en ambos frentes», declaró Herrera Suárez en un reciente foro internacional de defensa.
Con estas capacidades, CIBER-TEC no solo responde a las necesidades actuales, sino que moldea el futuro de la defensa global, posicionándose como el socio estratégico indispensable para las naciones que buscan mantenerse a la vanguardia en un mundo cada vez más complejo y digitalizado.
La Oficina de Alcohol, Tabaco, Armas de Fuego y Explosivos (ATF) canceló un contrato con Penlink que utilizaba tecnologías de vigilancia publicitaria para rastrear la ubicación de los estadounidenses.
El contrato fue cancelado poco más de un mes después de que el director de la ATF, Robert Cekada, reconociera, al ser interrogado por el representante Michael Cloud, republicano por Texas, en una audiencia en el Congreso que la agencia estaba comprando los datos de geolocalización de los estadounidenses a través de un contrato para «un tipo de tecnología publicitaria» que proporcionaría a la agencia datos de geolocalización «basados en los anuncios que se publican».
«Hemos comprado acceso a ese sistema, pero no lo hemos utilizado para un caso penal porque aún no hemos establecido ninguna política sobre cómo lo haríamos», dijo Cekada.
Describió ese sistema y esos datos como novedosos y dijo que la ATF aún estaba determinando cómo elaborar una guía oficial sobre cómo los agentes los usarían en el trabajo de investigación.
En un correo electrónico, un portavoz de la ATF confirmó a CyberScoop que el contrato había sido cancelado y lo describió como un proyecto piloto limitado para capacidades que la agencia ya no buscaba.
«La ATF evalúa continuamente herramientas y técnicas para mejorar nuestras investigaciones y, en última instancia, reducir los delitos violentos en las comunidades estadounidenses», escribió el portavoz. «Realizamos una prueba piloto con Webloc para determinar si podría mejorar nuestras capacidades de investigación. Después de completar nuestra revisión, determinamos que la herramienta no satisface nuestras necesidades y cancelamos el contrato. Actualmente, la ATF no utiliza ningún otro servicio de tecnología publicitaria».
Según el senador Ron Wyden, demócrata por Oregon, solicitó y su personal recibió un informe de la ATF sobre el asunto el 12 de junio. En la reunión, Cekada identificó la compra de licencias para la herramienta de vigilancia de ubicación comercial Webloc de Penlink como el contrato en cuestión.
Además, dijo que la ATF ya había realizado más de 340 búsquedas utilizando el sistema, incluidas más de 222 que estaban directamente relacionadas con números de casos activos de la ATF.
en su sitio webPenlink se describe a sí misma como una plataforma de análisis de inteligencia de código abierto que proporciona recopilación de datos en tiempo real, análisis web y forense y recopilación de evidencia digital. La firma promociona su uso de «análisis impulsado por IA» para aumentar las tasas de resolución de casos en un 80%, así como la capacidad de «vincular datos dispares a un tema, lugar o grupo utilizando capacidades integrales de resolución de identidad».
Wyden, quien a principios de este año encabezó un grupo de 70 demócratas del Congreso que pedían una investigación sobre la compra de datos de ubicación comercial por parte del Servicio de Inmigración y Control de Aduanas, dijo que la ATF finalmente hizo “lo correcto”, pero pidió que el Congreso aprobara su legislación que cambiaría la práctica en todo el gobierno federal.
«Después de que el Representante Cloud y mi personal informaron a la ATF sobre el atolladero legal y de privacidad que rodea a los datos de tecnología publicitaria, la agencia hizo lo correcto», dijo Wyden en un comunicado. «Cancelar este contrato es una victoria para los derechos constitucionales de los estadounidenses, pero la privacidad de los estadounidenses no debería depender de intervenciones ad hoc del Congreso. El Congreso debe aprobar la Ley de Reforma de la Vigilancia Gubernamental para cerrar la laguna jurídica de los intermediarios de datos de una vez por todas».
La oficina de Wyden señaló que la compra de datos de geolocalización de tecnología publicitaria es ilegal en algunos estados, y que la Comisión Federal de Comercio ya ha establecido que la venta de datos de ubicación confidenciales a agencias gubernamentales y contratistas se considera práctica engañosa e injusta según la Ley de la FTC.
El uso de tecnología publicitaria para vigilar y geolocalizar objetivos en línea es un problema creciente. Si bien las agencias de marketing y publicidad suelen utilizar estas herramientas para enviar anuncios dirigidos según la geografía o la región, los delincuentes también pueden utilizarlas para desenmascarar las identidades o ubicaciones de las personas, o combinarlas con otros datos públicos de maneras que preocupan a los defensores de la privacidad. Una estudiante de la Universidad de Tennessee está demandando a una empresa con sede en las Islas Vírgenes por extraer videos de sus redes sociales, convertirlos en anuncios no consensuados para su servicio de citas y luego utilizar la geolocalización con tecnología publicitaria para mostrar los anuncios a hombres en línea cerca de ella.
La oficina de Wyden dijo que en un caso la herramienta se utilizó para obtener datos de ubicación de dispositivos asociados con un contratista de defensa al mismo tiempo que un presunto incidente de incendio provocado, pero que la ATF luego se abstuvo de usarla en el tribunal después de que tanto el fiscal como el juez expresaron «seria incomodidad con el uso de datos de adtech sin orden judicial». En última instancia, la ATF optó por solicitar una orden judicial para obtener datos masivos de torres de telefonía celular.
AI agents are moving through enterprise environments, inheriting permissions, traversing systems, and executing decisions at machine speed with minimal oversight. The identity infrastructure built to govern human access wasn’t designed for autonomous actors, and the gap between what enterprises are deploying and what their governance programs actually cover is widening fast. This guide breaks down how the guardian agents emerged, why it matters, and what operationalizing it looks like in practice.
The Governance Gap Agentic AI Created
Identity governance has always lagged behind infrastructure change, but the arrival of production-grade agentic AI didn’t just widen the gap. It changed its shape entirely. The assumptions baked into every IAM architecture built over the past two decades are no longer sufficient for the environment most enterprises are actually running today.
Agents Aren’t Service Accounts
Security teams have spent years getting reasonably good at governing non-human identities. Service accounts get provisioned, rotated, and scoped. API keys get vaulted. Machine identities get enrolled in PAM workflows. The controls aren’t perfect, but the mental model is coherent: a non-human identity performs a defined function against a known set of resources, and you govern it by constraining what it can reach.
AI agents break every part of that model.
An agent doesn’t execute a fixed function. It receives an instruction, reasons about how to accomplish it, dynamically selects tools, chains calls across multiple systems, and delegates sub-tasks to other agents, all within a single session. The permission footprint of a single agent invocation can span a CRM, a code repository, a document store, and an internal API, touching resources that no human explicitly authorized the agent to access.
The Permission Inheritance Problem
The deepest architectural problem isn’t that agents carry too much access. It’s that they inherit access from the human or service identity they operate on behalf of, and that inherited access was scoped for an entirely different context.
When an agent executes on behalf of a sales director, it carries that person’s OAuth tokens, their delegated permissions, and any overprivileged access accumulated over years of role changes. The agent doesn’t distinguish between what the human would have done and what it’s been instructed to do. It executes with full inherited authority across every application that identity can reach.
Traditional IAM governance was built around authentication events. A human presents credentials, the system validates them, and access is granted or denied at login. Agents don’t follow that sequence. They authenticate once, often via a long-lived token or API credential, and then operate continuously across sessions, systems, and contexts without an intervening governance checkpoint.
An Architectural Problem, Not a Configuration One
IAM tools weren’t designed to observe what happens after authentication. They record the login event and stop. The entire sequence of tool calls, permission uses, data accesses, and cross-system traversals an agent performs inside a session remains invisible to the governance layer.
Agents find existing identity dark matter and move through it at machine speed. Stale delegations and over-scoped credentials that IAM teams have long deprioritized become an active attack surface the moment an agent touches them.
Governing that requires a layer purpose-built to operate where identity actually executes, not just where it authenticates.
Why Adoption Is Accelerating Now
The speed of agentic AI deployment inside enterprise environments has less to do with hype and more to do with three converging forces: models that now reliably complete multi-step reasoning tasks, infrastructure that makes orchestrating those models straightforward, and business pressure to automate knowledge work at a scale that headcount alone can’t support.
The Infrastructure Maturity Inflection Point
Twelve months ago, deploying a reliable multi-agent workflow required significant custom engineering. Today, frameworks like LangGraph, AutoGen, and Anthropic’s Model Context Protocol provide development teams with standardized primitives for agent orchestration, tool calling, memory management, and inter-agent communication. The cost of inference has dropped sharply across all major model providers, making it economically viable to run agents continuously rather than on demand. Together, these shifts moved agentic AI from proof of concept to production pipelines on timelines most security organizations didn’t anticipate.
Enterprise adoption reflects that shift. Agents now handle procurement workflows, customer support escalations, code reviews, financial reconciliations, and internal knowledge retrieval across organizations of all sizes. Line-of-business teams deploy them via low-code platforms and vendor-supplied integrations, often without any security review during provisioning.
Security Teams Are the Last to Know
The deployment pattern for agentic AI consistently repeats itself: engineering or operations teams identify a workflow to automate, a vendor provides an agent-enabled feature or API, and the agent goes live. Security teams discover it later, sometimes during an incident review, sometimes during an audit, sometimes not at all.
The 2026 market guide on guardian agents documents exactly this pattern across enterprise deployments. Governance readiness consistently lags deployment timelines, not because security teams are inattentive but because the provisioning motion for agents bypasses the identity lifecycle entirely. Agents don’t go through access request workflows. They don’t get onboarded into IGA systems. They inherit credentials from existing identities and start executing.
The result is an expanding population of autonomous identities operating across enterprise systems with no formal governance record, no ownership mapping, and no behavioral baseline. The agents are running. The question is whether anyone knows what they’re doing.
What Guardian Agents Are
A guardian agent is a purpose-built autonomous control layer that governs the identity and behavior of AI agents operating inside enterprise environments. Where traditional IAM tools govern human access and static machine identities, a guardian agent for AI operates at the execution layer, observing, analyzing, and enforcing policy against autonomous systems that act, reason, and move across applications in real time.
The term has moved from conceptual to operational. Enterprises running production agentic workloads now require a dedicated governance mechanism that keeps pace with agent activity, not one that audits it quarterly.
Continuous Identity Inventory
The first function of a digital guardian agent is discovery. Every AI agent operating in an environment carries an identity, inherits permissions, and leaves an access trail, but most enterprises lack a systematic way to enumerate which agents are running, which identities they’re acting on behalf of, or which applications they’ve touched.
A guardian agent for AI maintains a continuous, live inventory of every autonomous entity in the environment. It maps each agent to its originating identity, its owner, its permission scope, and the applications it interacts with. When a new agent spins up, provisioned through a vendor integration or deployed by a development team, the guardian agent registers it immediately rather than waiting for a manual review cycle that may never happen.
Behavioral Baselining and Anomaly Detection
Inventory alone doesn’t constitute governance. A guardian AI agent builds a behavioral baseline for each autonomous identity it monitors, tracking the pattern of tool calls, data accesses, API interactions, and cross-system movements an agent makes during normal operation.
Deviation from that baseline is where risk surfaces. An agent that begins accessing file stores outside its typical scope, calling APIs it has never used before, or escalating through a chain of delegated permissions signals a potential compromise, a prompt injection attack, or a misconfigured policy that has expanded its reach beyond its intended scope. The guardian AI agent surfaces these deviations in real time, with enough context to distinguish a legitimate workflow change from a genuine anomaly.
Runtime Policy Enforcement and Permission Scoping
Detection without enforcement is monitoring. A digital guardian agent applies a least-privilege policy at runtime, constraining what it can access during a given session based on the context of its current task, rather than the full scope of permissions its inherited identity technically allows.
Runtime scoping is the technical capability that separates guardian agents from conventional identity tooling. Rather than relying on pre-provisioned roles defined before anyone knew an agent would use them, a guardian agent for AI evaluates the current execution context and enforces permissions accordingly, dynamically tightening access as the agent moves through its workflow.
A Distinct Category from AI Security Posture Tools
A guardian AI agent is not an AI-SPM tool. AI security posture management focuses on the configuration and risk posture of AI infrastructure: model access controls, training data exposure, and API security. A guardian agent operates one layer down, governing the identity execution behavior of agents themselves, tracking what they do with the access they have, and enforcing boundaries at the moment of action rather than at the point of configuration.
How Guardian Agents Differ from Traditional IAM Tools
The instinct to govern AI agents using existing IAM tooling is understandable, and it’s wrong. Not because those tools are poorly built, but because they were engineered against a fundamentally different model of what an identity is and how it behaves. Mapping that tooling onto agentic workloads creates dangerous blind spots rather than adequate coverage.
What IGA Was Built to Do
Identity governance and administration platforms were designed to manage the lifecycle of human identities: joiner, mover, and leaver workflows, access certifications, role mining, and separation-of-duties enforcement. They work well when identities are enumerable, when access requests follow defined workflows, and when the relationship between a user and their permissions changes on a human timescale.
AI agents violate every one of those assumptions. An agent’s identity isn’t provisioned through a request workflow. Its permission scope shifts dynamically within a session. Its lifecycle doesn’t map to employment status. IGA platforms have no native concept of an agent that inherits a human identity, operates autonomously for the duration of a task, and then becomes dormant, only to reactivate under a different context with different inherited permissions the next time it runs.
Access certification campaigns can’t capture what a guardian agent for AI continuously tracks: the actual runtime behavior of an autonomous identity as it moves across systems.
Where PAM Falls Short
Privileged access management tools address a different problem. PAM assumes that high-risk access is bounded, that a human operator checks out credentials for a session, performs a defined task, and returns the credentials. The session is recorded, the access is time-limited, and the human is accountable.
Agents don’t check out credentials. They operate through inherited OAuth delegations, service account bindings, or API keys embedded in orchestration configurations. A PAM tool sees none of that. It governs the vault, not the execution path the agent takes once it’s operating with credentials obtained entirely outside the PAM workflow.
When an agent traverses four systems in a single session using a delegated OAuth token, PAM has no visibility into any part of that traversal. A digital guardian agent does.
The CIEM Boundary Problem
Cloud infrastructure entitlement management tools brought meaningful progress on the non-human identity problem, particularly for cloud service principals, IAM roles, and workload identities operating within a single cloud environment. The limitation is the boundary itself.
Agentic workloads routinely span multiple clouds, SaaS applications, self-hosted systems, and third-party API integrations within a single workflow. CIEM tools govern entitlements within their supported platforms. They don’t follow an agent as it moves from an AWS service role to a SaaS CRM to an internal document management system, accumulating effective permissions across each hop.
A guardian AI agent operates across that entire surface, maintaining a unified view of what each autonomous identity can access and what it actually did, regardless of which platform boundary it crossed.
The Core Architectural Difference
Traditional IAM tools answer identity questions at provisioning time or at the authentication boundary. A guardian agent for AI answers them at execution time, inside the session, at the application layer, where permissions are actually exercised.
The difference isn’t incremental. Governing an autonomous identity that reasons, delegates, and acts requires a control plane that reasons alongside it, observing behavior in motion rather than auditing access after the fact.
Common Risks: How Unmanaged Agents Become Identity Dark Matter
Unmanaged AI agents don’t announce themselves as a security problem. They accumulate as one. Each agent that deploys without a governance record, inherits permissions without review, and operates without behavioral oversight adds to a growing population of autonomous identities that security teams can’t see, audit, or control. Orchid Security calls this identity dark matter: the mass of identity activity that exists and exerts real risk inside an environment while remaining invisible to the tools responsible for governing it.
Over-Privileged Agent Identities
The most pervasive risk pattern starts at provisioning. When an agent deploys by binding to an existing service account or human identity, it inherits the full permission scope of that identity, regardless of what the agent actually needs. A code review agent bound to a senior engineer’s identity might inherit access to production infrastructure, financial systems, and HR data accumulated over years of role changes. The agent needs none of it, but carries all of it into every session it runs.
Over-privileged agent identities are the rule in unmanaged deployments. Because agents bypass access-request workflows, no one applies least-privilege scoping at provisioning time. The permissions are already there, and binding an agent to an existing identity is the path of least resistance.
Orphaned Sessions and Stale Credentials
Agent sessions don’t always terminate cleanly. Long-running agents and scheduled automation tasks can maintain active credentials well beyond the duration of the task they were created for. When an agent is decommissioned or simply forgotten, the credentials it used often remain valid.
Stale agent credentials are particularly dangerous in SaaS environments where token revocation requires deliberate action against each connected application. An orphaned agent operating through a long-lived OAuth token can retain access to sensitive systems for months after anyone last intentionally invoked it.
Prompt Injection as a Privilege Escalation Vector
Prompt injection attacks target agents directly. An attacker embeds malicious instructions in content the agent processes: a document it summarizes, a web page it retrieves, a ticket it reads. The agent incorporates those instructions into its reasoning and takes actions that the legitimate user never authorized. In environments where agents operate with overprivileged inherited identities, prompt injection becomes a reliable path to privilege escalation without touching credentials at all.
Lateral Movement Through Chained Agent Calls
Multi-agent architectures introduce compounding risk. When an orchestrator agent delegates sub-tasks to specialized child agents, each delegation transfers a portion of the orchestrator’s authority. A compromise at any point in that chain propagates downstream, giving an attacker effective access to every system the trust chain touches.
The audit trail problem makes all of this harder to contain. Agents operating across unmanaged SaaS applications leave no coherent forensic record in existing security tooling. When an incident occurs, security teams reconstruct what happened from fragmented logs across disconnected systems, often without enough fidelity to determine which agent took which action on whose behalf.
Putting this into your identity governance program requires treating agent identities with the same rigor applied to privileged human accounts: continuous inventory, ownership mapping, behavioral monitoring, and a full audit record across every application each autonomous identity touches.
How to Bring AI Agents into the Light
Getting AI agents under governance control is an operational capability that security and identity teams need to continually build as agent deployments continue to grow. The following sequence reflects how mature organizations are approaching it, moving from visibility to classification to enforcement to integration.
1. Start with Discovery: Know What’s Running
Governance starts with an accurate inventory, and most enterprises don’t have one. The first operational step is deploying discovery mechanisms that identify every AI agent active in the environment, regardless of how it was provisioned or which team deployed it.
Effective discovery operates at the application layer. Network-level monitoring captures traffic patterns but can’t attribute them to specific agent identities or map them to the human identities those agents act on behalf of. Application-layer discovery surfaces the agent, its credential bindings, its permission inheritance, and its operational context, all the information needed to make a governance decision.
2. Classify by Trust Level and Permission Scope
Not every agent carries the same risk. Once an inventory exists, classify each agent by the sensitivity of the permissions it holds, the systems it can reach, and the trust level of its originating identity. An agent operating with read-only access to a single internal knowledge base carries a fundamentally different risk profile than one holding delegated OAuth tokens to a financial system and a customer data platform simultaneously.
Classification drives prioritization. Agents with broad permission inheritance and connections to sensitive systems warrant immediate least-privilege remediation. Agents with narrow, well-scoped access warrant monitoring and periodic review. Without classification, every agent looks the same, and remediation effort is distributed without regard to the actual concentration of risk.
3. Enforce Least-Privilege at Runtime, Not at Provisioning
Static scoping at provisioning time degrades quickly. As agents are reused for new tasks, their permissions drift, and the inherited credentials they carry rarely get updated to reflect actual requirements. Runtime enforcement through a guardian agent for AI dynamically applies least privilege, constraining what each agent can access based on the context of its current task rather than on the broadest permissions its identity technically allows.
Runtime enforcement also contains the blast radius of a compromise. A prompt injection attack against an agent operating under tight runtime scoping reaches far less than the same attack against an agent running with its full inherited permissions active.
4. Integrate with Existing IAM and IGA Stacks
A guardian AI agent doesn’t replace the IAM infrastructure already in place. It extends it. Agent identity data feeds into IGA platforms to enable access certification, into PAM tools to flag credential exposure, and into SIEM systems to enrich alert context with agent behavioral history. The integration layer transforms agent governance from a standalone capability into a live input to the broader identity security platform, giving every downstream tool more accurate information about what’s actually executing in the environment.
How Orchid Security Helps
The governance gap described throughout this guide is what Orchid Security is built to close. The platform operates as a continuous identity control plane across human, machine, and agentic identities, providing security and identity teams with the visibility and enforcement capabilities that existing IAM tooling doesn’t provide.
Continuous Discovery Across Every Identity Type
Orchid’s discovery engine automatically inventories every application, account, and authentication flow in an environment, managed or otherwise. When AI agents spin up, whether through vendor integrations, internal deployments, or low-code automation platforms, Orchid surfaces them, maps them to their originating identities, and enriches them with ownership, permission scope, and business context. Security teams get an accurate, continuously updated picture of what’s running rather than a static snapshot that degrades the moment it’s produced.
From Visibility to Enforcement
The guardrails for the autonomous identity use case apply Orchid’s identity control plane directly to agentic workloads. Every agent gets mapped to an accountable human owner. Runtime guardrails enforce least-privilege at the execution layer. Behavioral observability tracks what agents actually do across tool calls, data accesses, and cross-system movements, surfacing anomalies before they become incidents.
Orchid also integrates with existing IAM programs and GRC workflows, feeding continuous agent identity telemetry into the tools already governing the rest of the environment. For teams building out their identity governance program, that telemetry becomes the connective tissue between agent activity and enterprise-wide identity policy.
The result is an identity infrastructure that governs the autonomous workforce with the same rigor it applies to human identities, at the speed agents actually operate.
Found this article interesting? This article is a contributed piece from one of our valued partners. Follow us on Google News, Twitter and LinkedIn to read more exclusive content we post.
Un actor de amenaza persistente avanzada (APT) de habla china ha sido vinculado a una nueva puerta trasera personalizada llamada TinyRCT como parte de ataques cibernéticos dirigidos a entidades gubernamentales e infraestructura crítica en el sudeste asiático.
La actividad, particularmente dirigida a empresas estatales en los sectores energético y gubernamental, ha sido atribuida a un actor de amenazas llamado CL-STA-1062que según la Unidad 42 de Palo Alto Networks comparte se superpone con UAT-7237, un grupo de piratería que fue señalado por primera vez por Cisco Talos en agosto de 2025 en relación con una campaña dirigida contra entidades de infraestructura web en Taiwán.
La Unidad 42 dijo que también observó campañas CL-STA-1062 en operaciones anteriores dirigidas a sectores estratégicos en el este de Asia desde marzo de 2022, lo que sugiere un enfoque más amplio pero sostenido en la región.
«Desde un punto de vista técnico, los atacantes detrás de CL-STA-1062 se basan en un conjunto de herramientas híbrido», Unidad 42 dicho en un informe técnico. «Si bien utilizan con frecuencia herramientas comunes de código abierto como SoftEther VPN, Mimikatz y VNT, recientemente introdujeron TinyRCT, una puerta trasera hecha a medida y que antes no estaba documentada».
TinyRCT está equipado para ejecutar comandos arbitrarios, enumerar archivos y filtrarlos, capturar la pantalla del dispositivo y eliminarse del host comprometido.
En una campaña detectada en septiembre de 2025, se dice que el actor de amenazas se infiltró en una entidad gubernamental del sudeste asiático y desplegó un shell web para extraer datos de un servidor MS SQL. Durante el mismo ataque, se descubrió que los actores de la amenaza realizaban reconocimiento de red en una entidad gubernamental separada en el mismo país.
«Esto sugiere un esfuerzo para identificar oportunidades de movimiento lateral y ampliar su acceso. En un caso, observamos al atacante organizar y exfiltrar un directorio completo de código fuente del servidor web de la entidad gubernamental», dijo la Unidad 42, agregando que detectó la violación de al menos 10 organizaciones diferentes en el sudeste asiático entre octubre y diciembre de 2025.
Desde al menos mediados de 2025, CL-STA-1062 ha centrado su mirada en la infraestructura crítica, con el adversario escaneando múltiples entidades en la región en busca de vulnerabilidades y luego estableciendo un punto de apoyo a través de shells web ASPX que facilitan el reconocimiento inicial y las solicitudes salientes de las redes infectadas a la infraestructura controlada por el atacante, lo que lleva al despliegue de cargas útiles adicionales.
Esto incluye componentes de SoftEther VPN y archivos RAR que contienen el conjunto de herramientas del grupo, incluidas utilidades de código abierto como yuze (un proxy SOCKS5) y VNT (una VPN), a menudo disfrazándolos como ejecutables de VMware o un agente XDR (por ejemplo, «XDRAgent.exe», «vmtools.exe» y «vmwared.exe»).
Un análisis más profundo de la infraestructura de la campaña ha llevado al descubrimiento de una puerta trasera .NET no documentada anteriormente denominada TinyRCT («PerfWatson2.exe»), un troyano ligero de acceso remoto que permite el reconocimiento del sistema, la ejecución de comandos, la carga de archivos, la captura de capturas de pantalla, el control remoto y el borrado de rastros de sí mismo, mientras toma medidas para evitar la ejecución en entornos aislados.
Establece un canal de comunicación persistente con un servidor remoto («45.32.113[.]172») a través de HTTP, pero cifra los datos intercambiados utilizando cifrado AES-128 en modo CBC.
«El malware opera en un modelo de baliza, con un intervalo de suspensión predeterminado de 10 segundos entre solicitudes», explicó la Unidad 42. «Sondea el servidor C2 en busca de instrucciones mediante solicitudes GET, mientras envía datos exfiltrados mediante solicitudes POST».
En cuanto a cómo se entrega TinyRCT, toma la forma de un archivo malicioso llamado «chrome_setup.zip» que contiene un ejecutable legítimo («chrome_setup.exe»), un archivo de configuración («chrome_setup.exe.config») y una DLL fraudulenta («MyAppDomainManager.dll») que se utiliza para desencadenar un Inyección de AppDomainManager ataque para cargar la DLL maliciosa, que funciona como un descargador comunicándose con «139.180.134[.]221» para recuperar «PerfWatson2.exe».
«La combinación de herramientas observada en este grupo de actividades refleja un enfoque pragmático en la selección de herramientas y capacidades de ataque», concluyó la Unidad 42. «Los atacantes detrás de este grupo continúan aprovechando herramientas comunes de código abierto como SoftEther VPN y VNT para facilitar el movimiento lateral».
«Nuestro descubrimiento de la puerta trasera TinyRCT en la infraestructura de los atacantes subraya su capacidad de personalizar herramientas para obtener capacidades específicas. La combinación de apuntar a la infraestructura crítica y el desarrollo de malware personalizado sugiere que la actividad CL-STA-1062 seguirá representando una amenaza para la región».
clon sucio es una nueva escalada de privilegios del kernel de Linux en el Frag sucio familia. JFrog Security Research publicó un tutorial funcional para detectar la falla el 25 de junio, la primera demostración pública de esta variante.
Seguimiento como CVE-2026-43503 (CVSS 8.8), permite a un usuario local corromper la memoria respaldada por archivos a través de un paquete de red clonado y obtener raíz. El parche llegó a la línea principal el 21 de mayo; Si tu kernel no lo tiene, actualiza ahora.
Cuando el kernel copia un paquete de red internamente, dos funciones auxiliares colocan una bandera de seguridad que marca la memoria del paquete como compartida con un archivo en el disco. Esa bandera que falta es toda la vulnerabilidad.
El atacante carga un binario privilegiado como /usr/bin/su en la memoria, conecta esas páginas de memoria a un paquete de red y obliga al kernel a clonarlo. El paquete clonado pasa a través de un túnel IPsec que controla el atacante, y el paso de descifrado sobrescribe las comprobaciones de inicio de sesión del binario con bytes elegidos por el atacante. La próxima vez que alguien ejecute su, entregará root.
El archivo en el disco nunca cambia. La modificación se encuentra sólo en la copia en memoria del kernel, por lo que las herramientas de integridad de archivos no la detectan, el ataque no deja rastro de auditoría y un reinicio restaura el binario original. El atacante ya tiene root cuando a alguien se le ocurre comprobarlo.
La explotación requiere CAP_NET_ADMIN para configurar el túnel IPsec de bucle invertido. En Debian y Fedora, los espacios de nombres de usuarios sin privilegios están habilitados de forma predeterminada, por lo que un usuario local puede obtener esa capacidad dentro de un nuevo espacio de nombres.
Ubuntu 24.04 y versiones posteriores restringen la creación de espacios de nombres a través de AppArmor, bloqueando la ruta de explotación predeterminada. La caché de página se comparte a nivel de host, por lo que las modificaciones realizadas dentro de un espacio de nombres afectan a todos los procesos de la máquina.
Los sistemas expuestos son servidores multiinquilino, ejecutores de CI, hosts de contenedores y clústeres de Kubernetes donde los usuarios que no son de confianza pueden crear espacios de nombres. JFrog confirmó el exploit en sistemas Debian, Ubuntu y Fedora con configuraciones de espacio de nombres predeterminadas.
Cuarto de una serie
Esta es la cuarta escalada de privilegios reciente con el mismo modo de falla: la memoria respaldada por archivos se trata como paquetes de datos, luego una operación de red local escribe donde debería haberse copiado.
Copy Fail (CVE-2026-31431) apareció por primera vez a finales de abril, explotando el módulo algif_aead para una escritura de caché de página de cuatro bytes.
DirtyFrag (CVE-2026-43284 y CVE-2026-43500) siguió el 7 de mayo, encadenando rutas IPsec ESP y RxRPC para una primitiva de escritura completa.
Fragnesia (CVE-2026-46300) apareció el 13 de mayo, evitando el parche DirtyFrag a través de un error que dejaba caer la bandera en skb_try_coalesce().
Cada solución cerró una ruta de código y dejó otras abiertas. El exploit demostrado por DirtyClone se centra en __pskb_copy_fclone(), y skb_shift() también se ve afectado; la solución CVE más amplia cubre ayudas de transferencia de fragmentos adicionales donde se podría perder la misma bandera.
El problema subyacente no es una mala función auxiliar. Es un problema de contrato: cada ruta de código que mueve fragmentos de skb tiene que preservar el bit de fragmento compartido en todo momento.
La red de copia cero del kernel permite que la memoria respaldada por archivos sirva como paquetes de datos, y una sola bandera colocada en cualquier parte de la cadena convierte una optimización del rendimiento en una primitiva de escritura. Cada variante encontró un camino en el que el contrato no se cumplió.
El investigador original de DirtyFrag, Hyunwoo Kim, había presentado una visión más amplia. parche multisitio cubriendo varios asistentes de transferencia de fragmentos restantes el 16 de mayo. La solución combinada se fusionó el 21 de mayo (commit 48f6a5356a33), se le asignó CVE-2026-43503 el 23 de mayo y se envió en Linux v7.1-rc5 el 24 de mayo.
Si no puede parchear hoy, dos soluciones reducen la superficie de ataque. Restrinja los espacios de nombres de usuarios sin privilegios: en Debian y Ubuntu, establezca kernel.unprivileged_userns_clone=0 (otras distribuciones usan mecanismos diferentes).
Alternativamente, incluya en la lista negra los módulos del kernel esp4, esp6 y rxrpc, aunque eso interrumpe IPsec y AFS y solo funciona cuando esas características son módulos cargables en lugar de compilarse en el kernel. Ambos son controles temporales, no soluciones.
La clase DirtyFrag probablemente no esté terminada. Cualquier función que mueva descriptores de fragmentos sin propagar el indicador de fragmento compartido es un nuevo CVE potencial, y la auditoría debe cubrir todas las rutas que tocan skb_shinfo()->flags durante la transferencia de fragmentos.
La Agencia de Seguridad de Infraestructura y Ciberseguridad de EE. UU. (CISA) el jueves agregado una vulnerabilidad crítica de ejecución remota de código que afecta al software empresarial PTC Windchill PDMlink y PTC FlexPLM de gestión de datos de productos (PDM) y gestión del ciclo de vida del producto (PLM) hasta sus vulnerabilidades explotadas conocidas (KEV) catálogo, citando evidencia de explotación activa.
La vulnerabilidad en cuestión es CVE-2026-12569 (Puntuación CVSS: 9,3), un caso de validación de entrada incorrecta que podría permitir a un atacante ejecutar código arbitrario enviando una solicitud maliciosa a la red.
«La vulnerabilidad es un problema de ejecución remota de código (RCE) que puede explotarse mediante la deserialización de datos que no son de confianza», según un aviso publicado por PTC.
Aunque la semana pasada se lanzaron parches para la falla, PTC confirmó desde entonces, hasta el 25 de junio, que «hemos recibido informes continuos de una mayor actividad de amenazas», y la compañía reveló que atacantes desconocidos están explotando la vulnerabilidad para implementar shells web JSP contra sistemas susceptibles.
PTC también ha liberado los siguientes indicadores de compromiso (IoC) asociados con la actividad:
172.111.38.31
216.152.148.54
104.243.35.131
74.50.76.146
5.180.41.35
216.152.148.54
5.180.41.35 (Dirección de comando y control del atacante)
Archivos de shell web siguiendo el patrón de nomenclatura /Windchill/login/[0-9a-f]{16}.jsp
Como mitigaciones, se recomienda a los usuarios que realicen las siguientes acciones:
Bloquear 5.180.41.35 en el firewall perimetral inmediatamente
Busque en los registros de acceso HTTP cualquier solicitud POST para /Escalofrío/login/*.jsp
Escanee el sistema de archivos en busca de archivos JSP que coincidan con el patrón de 16 caracteres hexadecimales /Escalofrío/iniciar sesión/[0-9a-f]{16}.jsp
Realice una comprobación hash de cualquier archivo JSP sospechoso 55a1eb4c2d3da04376df39d7ba832569c6af1a37a0cf2b95f754ac898023a30c
comprobar si flst.txt en /tmp o en el directorio de trabajo de Windchill, cuya presencia confirma la actividad del atacante en el listado de archivos
Agregue una regla WAF/IDS que bloquee cualquier solicitud que contenga el encabezado X-viento frío-req:
Restringir la exposición a Internet del punto final de inicio de sesión de Windchill cuando sea operativamente posible
El desarrollo la convierte en la primera vulnerabilidad de un producto PTC agregada al catálogo KEV de CISA, sin mencionar que resalta cómo los actores de amenazas están utilizando rápidamente como arma las vulnerabilidades recientemente reveladas para su beneficio.
Una falla de alta gravedad en Amazon Q Developer permitió que un repositorio malicioso ejecutara comandos y robara las credenciales de la nube de un desarrollador. El camino fue corto: un desarrollador abre el repositorio, confía en el espacio de trabajo y Amazon Q hace el resto. Amazon lo ha parcheado.
Seguimiento como CVE-2026-12957 (CVSS 8.5), el error radicaba en cómo el asistente de codificación de IA de Amazon manejaba los servidores del Protocolo de contexto modelo (MCP).
Wiz Research, que lo encontró e informó, demostró que un solo archivo de configuración colocado en un repositorio era suficiente para pasar del clon de git al compromiso de la nube.
Cómo funcionó el ataque
Amazon Q leyó un archivo de configuración de MCP, .amazonq/mcp.json, desde el espacio de trabajo abierto e inició los servidores que definió. Los servidores MCP son procesos locales que un asistente de IA puede generar para acceder a bases de datos, API o herramientas de creación, por lo que iniciar uno significa ejecutar comandos en la máquina.
Esos procesos heredaron el entorno completo del desarrollador. Por lo general, eso significa claves de AWS, tokens CLI de la nube, secretos de API y sockets de agente SSH.
Junte los dos y un archivo ubicado en un repositorio clonado podría ejecutar código arbitrario con la sesión en vivo en la nube del desarrollador adjunta. Sin contraseña, sin segundo inicio de sesión.
en su prueba de conceptoWiz hizo que el archivo ejecutara aws sts get-caller-identity y enviara el resultado a un servidor atacante, capturando la sesión activa de AWS. Lo que viene a continuación depende de los permisos en la nube de ese desarrollador: hacer una puerta trasera a un usuario de IAM para lograr persistencia, acceder a servicios internos o girar hacia la producción.
AWS y Wiz enmarcan el paso de consentimiento de manera diferente. Amazonas consultivo dice que el usuario debe confiar en el espacio de trabajo cuando se le solicite, y CVSS califica la interacción del usuario como pasiva.
Wiz informó que no había ningún paso de consentimiento por separado para los servidores MCP antes de la solución. El parche cierra esa brecha: Amazon Q ahora marca un servidor MCP que no es de confianza y permite al desarrollador rechazar el comando antes de que se ejecute.
El defecto vive en Servidores de idiomas para AWSel tiempo de ejecución que impulsa Amazon Q en VS Code, JetBrains, Eclipse y Visual Studio. Los cuatro complementos lo incluyen, por lo que los cuatro quedaron expuestos en versiones que incluían una copia anterior.
que hacer
Actualizar. CVE-2026-12957 está corregido en Language Servers para AWS 1.65.0, pero AWS boletín les dice a los clientes que pasen a 1.69.0.
Esa construcción también cierra un segundo problema, CVE-2026-12958una verificación de enlace simbólico faltante que podría permitir escrituras arbitrarias de archivos fuera del límite de confianza del espacio de trabajo.
Los mínimos del complemento parcheado:
Código VS: 2.20 o posterior
JetBrains: 4.3 o posterior
Eclipse: 2.7.4 o posterior
Kit de herramientas de Visual Studio: 1.94.0.0 o posterior
El servidor de idiomas se actualiza automáticamente a menos que la red lo bloquee y al recargar el IDE se obtiene la última versión.
No se conoce ninguna explotación pública; La entrada ADP de CISA para CVE-2026-12957 lo enumera como ninguno. Wiz encontró la falla a través de una investigación y la reveló en coordinación con Amazon, informándola el 20 de abril y viendo una solución el 12 de mayo, antes del informe público del 26 de junio.
Un patrón, no algo único
Amazon Q no es el primer asistente de codificación que tropieza con la confianza de MCP. Los errores no son idénticos, pero riman: la configuración del proyecto se convierte en un comportamiento ejecutable y las comprobaciones de confianza en torno a esa transferencia siguen fallando.
Claude Code (CVE-2025-59536) y Cursor (CVE-2025-54136) tenían una configuración MCP a nivel de proyecto que conducía a la ejecución del comando. windsurf (CVE-2026-30615) llegó al mismo final por una ruta diferente, con contenido controlado por el atacante reescribiendo la configuración de MCP local para registrar un servidor malicioso.
La conveniencia de permitir que una carpeta de proyecto configure un agente de IA también es la superficie de ataque. La configuración transportada por el repositorio es una entrada que no es de confianza. Convertirlo en un proceso en ejecución debería requerir un sí explícito.